


Java与Python实现常见算法的难度对比:内置库与语法特性解析
深入对比Java与Python在常见算法实现中的难度差异,围绕语法心智负担、内置集合工具库(heapq、bisect、TreeMap、TreeSet)及经典算法案例展开系统解析与选型建议。
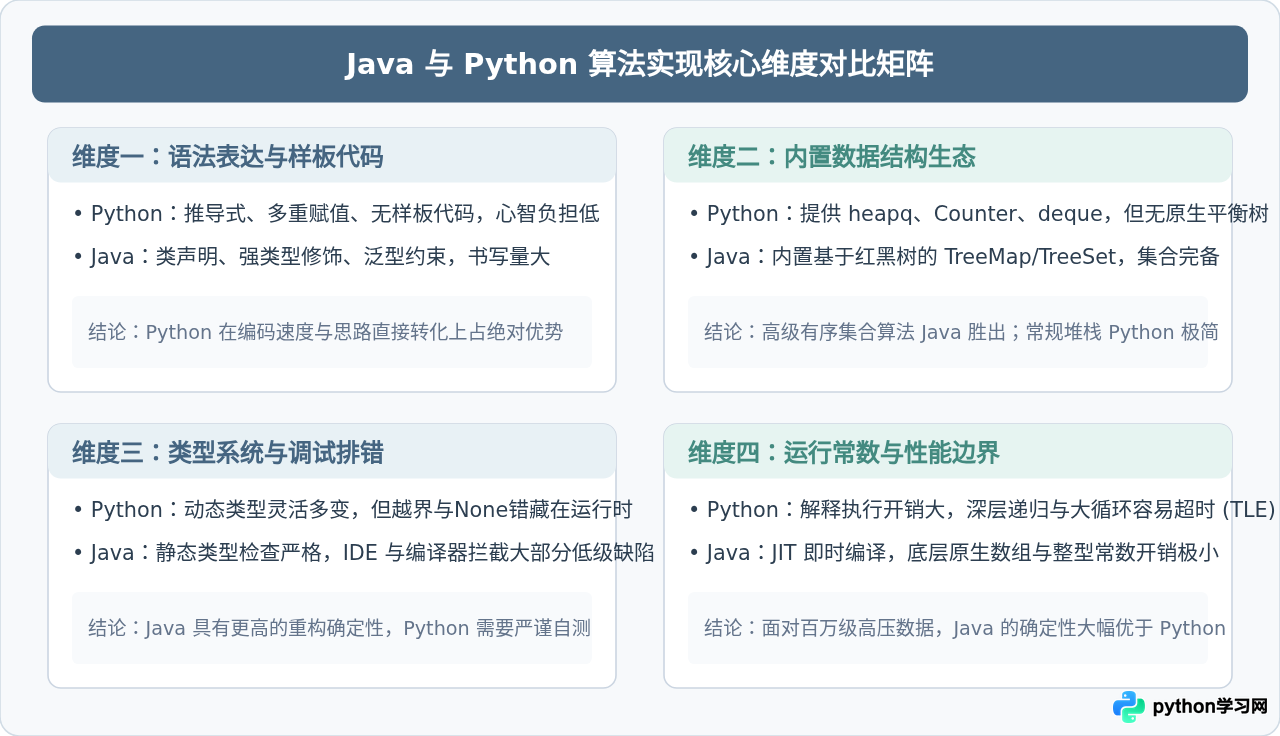
在算法实现与刷题过程中,选择 Java 还是 Python 往往直接决定了编写代码的速度与心智负担。核心结论在于:Python 凭借极简语法、动态类型、高阶解构与丰富的快捷库(如 collections、heapq),在中低复杂度算法、图搜索及字符串处理中实现难度显著更低;然而在涉及动态前驱后继查询等高级有序集合场景下,Java 凭借内置完备的红黑树实现(TreeMap/TreeSet)展现出绝对优势,且 Java 严格的强类型系统与极高的常数运行性能,有效规避了动态类型带来的运行时隐患与超时瓶颈。本文将系统拆解两者的内置库生态与核心语法特性,深入对比常见算法的落地难易度。
一、语法特性对算法编码心智负担的影响
在算法实现中,“代码书写成本”直接影响解题效率和思路连贯性。Python 的设计理念强调表达力与极简,而 Java 则注重类型严谨与架构清晰。两者在语法层面的差异主要体现在以下三个方面:
1. 样板代码与类型声明
在 Java 中,任何算法逻辑都必须挂载在类与方法签名之下,必须明确声明每一个变量的类型,例如双层嵌套集合 Map<Integer, List<Integer>> graph = new HashMap<>();。这种显式声明保证了类型安全,但在草稿推演阶段会消耗大量键盘敲击时间。而 Python 仅需 graph = defaultdict(list),变量随用随赋,代码行数通常只有 Java 的三分之一到二分之一。
2. 数据交换与多重返回值
算法中常见的双指针元素互换,在 Python 中只需简洁的元组解构赋值:nums[i], nums[j] = nums[j], nums[i];而在 Java 中则需要显式引入临时变量 int temp = nums[i]; nums[i] = nums[j]; nums[j] = temp;。在递归回溯或分治算法中,函数需要同时返回多个指标(如树的最大深度与是否平衡),Python 支持直接返回元组 return depth, is_balanced,Java 则必须定义专门的内部类或使用长度为 2 的数组进行包装。
3. 列表推导与切片操作
Python 原生支持切片语法 arr[start:end] 和带步长的反转 arr[::-1],配合列表推导式 [x for x in nums if x > 0],能在单行内完成数据的筛选与清洗。虽然 Java 提供了 Stream API(例如 nums.stream().filter(x -> x > 0).collect(...)),但装箱拆箱开销和冗长的方法链在追求极致速度的算法场景中并不常用,更多仍依赖传统的 for 循环操作。
二、内置集合与标准库深度对比
算法的实现效率很大程度上取决于标准库是否提供了开箱即用的底层数据结构。下表展示了两种语言常见数据结构的对应关系与特性边界:
| 数据结构分类 | Python 内置模块与类型 | Java 标准库工具类 | 核心能力差异与难点解析 |
|---|---|---|---|
| 动态数组 | list |
ArrayList<E> / 原生数组 int[] |
Java 原生数组无对象包装开销,访问常数速度极快;Python list 兼具栈功能,灵活性更高。 |
| 双端队列 / 栈 | collections.deque |
ArrayDeque<E> / LinkedList<E> |
两者均提供 $O(1)$ 头尾存取;Java ArrayDeque 性能优异,Python deque 支持限制最大长度 maxlen。 |
| 优先队列(堆) | heapq(就地操作普通列表) |
PriorityQueue<E> |
Python 默认仅支持最小堆,大顶堆需存负值或取反包装;Java 原生支持 Comparator 自定义。 |
| 二分查找 | bisect(bisect_left/right) |
Arrays.binarySearch / Collections.binarySearch |
Python bisect 极其优雅地处理插入位置;Java 若未命中则返回 -(insertion point) - 1,易出错。 |
| 动态有序集合(平衡二叉树) | 无原生内置(需额外手写或第三方库) | TreeMap<K,V> / TreeSet<E> |
Java 原生基于红黑树,提供 floor()、ceiling() 等前驱后继查询;Python 在此维度完全缺失。 |
| 计数与默认哈希 | Counter / defaultdict |
HashMap<K,V>(配合 getOrDefault) |
Python 一行完成频次统计与图节点邻接表初始化,Java 需多行样板代码判断空值。 |
三、典型算法实战难度对比:Top-K 堆问题
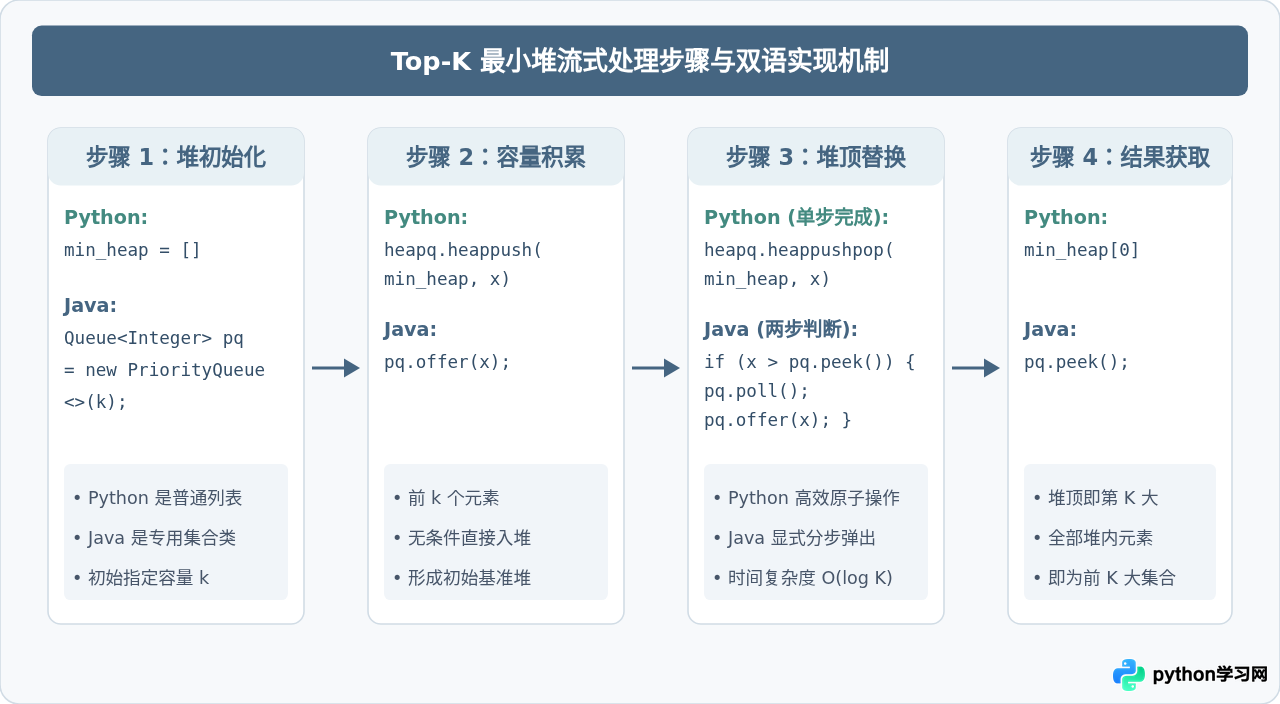
在海量数据流中寻找前 K 大元素是经典的面试题,核心解法是维护一个容量为 K 的最小堆。若当前数值大于堆顶,则弹出堆顶并将当前值入堆。这一算法在两种语言下的实现步骤与心智模型如下图所示:
代码实现直观对比
以 LeetCode 215 题(数组中的第 K 个最大元素)为例,两者的完整实现如下:
Python 实现:
import heapq

def findKthLargest(nums: list[int], k: int) -> int:
    # 直接使用 heapq 提供的 nlargest 函数,内部也是利用最小堆优化
    # 或者手动维护大小为 k 的最小堆
    min_heap = nums[:k]
    heapq.heapify(min_heap)
    for num in nums[k:]:
        if num > min_heap[0]:
            heapq.heappushpop(min_heap, num)
    return min_heap[0]
Java 实现:
import java.util.PriorityQueue;

public class Solution {
    public int findKthLargest(int[] nums, int k) {
        PriorityQueue<Integer> minHeap = new PriorityQueue<>(k);
        for (int i = 0; i < k; i++) {
            minHeap.offer(nums[i]);
        }
        for (int i = k; i < nums.length; i++) {
            if (nums[i] > minHeap.peek()) {
                minHeap.poll();
                minHeap.offer(nums[i]);
            }
        }
        return minHeap.peek();
    }
}
在常规堆问题中,Python 凭借 heapq.heappushpop 与切片语法更为精炼。但必须注意一个关键限制:Python 的 heapq 仅支持最小堆。若要实现大顶堆,开发者必须将元素取反(如存入 -val)或封装为自定义比较类,容易在提取结果时忘记反转符号导致逻辑错误;而 Java 的 PriorityQueue 可以通过 Lambda 表达式自由指定排序规则,例如大顶堆只需 new PriorityQueue<>((a, b) -> b - a),在复杂多字段比较排序中比 Python 更直观安全。
四、典型算法实战难度对比:二分查找与有序集合
有序集合问题展示了完全相反的难度对比。二分查找用于在静态有序数组中定位目标,而有序集合则要求在数据持续动态插入和删除的过程中,随时以 $O(\log N)$ 的时间复杂度查询某元素的前驱(小于等于它的最大值)或后继(大于等于它的最小值)。
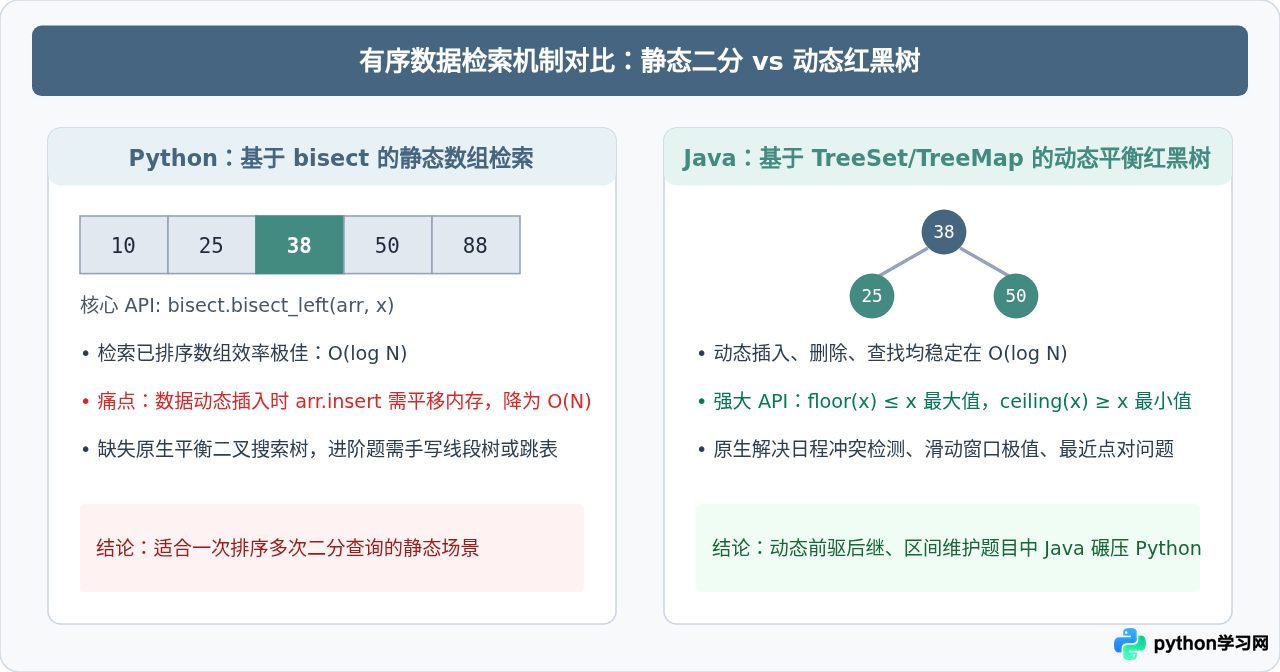
在 LeetCode 729 题(我的日程安排表 I)等需要动态插入区间并检查是否发生重叠的场景中,Java 开发者可以直接使用 TreeSet 或 TreeMap,仅需数行代码即可完成:
// Java 利用 TreeSet 解决动态日程区间重叠
TreeSet<int[]> calendar = new TreeSet<>((a, b) -> a[0] - b[0]);

public boolean book(int start, int end) {
    int[] curr = new int[]{start, end};
    int[] prev = calendar.floor(curr); // 找到起始时间小于等于当前区间的上一个区间
    if (prev != null && prev[1] > start) return false;
    int[] next = calendar.ceiling(curr); // 找到起始时间大于等于当前区间的下一个区间
    if (next != null && next[0] < end) return false;
    calendar.add(curr);
    return true;
}
而在 Python 的标准库中,没有内置平衡二叉树(如 Red-Black Tree 或 AVL)。Python 开发者若要在面试现场解决该类问题,通常面临艰难抉择:要么退化为维护有序列表使用 bisect.insort,导致单次插入时间复杂度劣化为 $O(N)$(在大规模测试用例下极易超时);要么必须在白板上手工编写 200 行以上的平衡树或线段树。这一内置库的生态缺失,是 Python 在高阶算法实现中最大的短板。
五、典型算法实战难度对比:图遍历与滑动窗口
1. 图的邻接表构建与 BFS/DFS
在图算法中,图的构建开销占据相当比例。Python 提供了 collections.defaultdict(list),在读取边 (u, v) 时可直接书写 graph[u].append(v),完全不需要预先检测节点 u 是否在哈希表中。而在 Java 中,即便使用现代集合 API,也通常需要书写 graph.computeIfAbsent(u, k -> new ArrayList<>()).add(v);。虽然 computeIfAbsent 简化了代码,但其底层生成 Lambda 对象的额外开销和冗长的泛型参数 Map<Integer, List<Integer>> 仍然增加了读写心智负担。
2. 字符串匹配与滑动窗口
在处理双指针与字符串滑动窗口(如无重复字符的最长子串)时,Python 的 Counter 与字典能够在两行内完成字符频次增减与对比。但是,Python 中的字符串是不可变对象,且切片 s[l:r] 会在内存中创建全新的子字符串,在大字符串上频繁切片会导致剧烈的内存复制;而 Java 在处理字符串时通常先执行 char[] arr = s.toCharArray();,后续所有窗口收缩与扩展全部直接在底层的连续字符数组上进行整型指针操作,不仅完全规避对象创建,执行速度往往比 Python 快一个数量级以上。
六、算法场景选型建议与全景评估
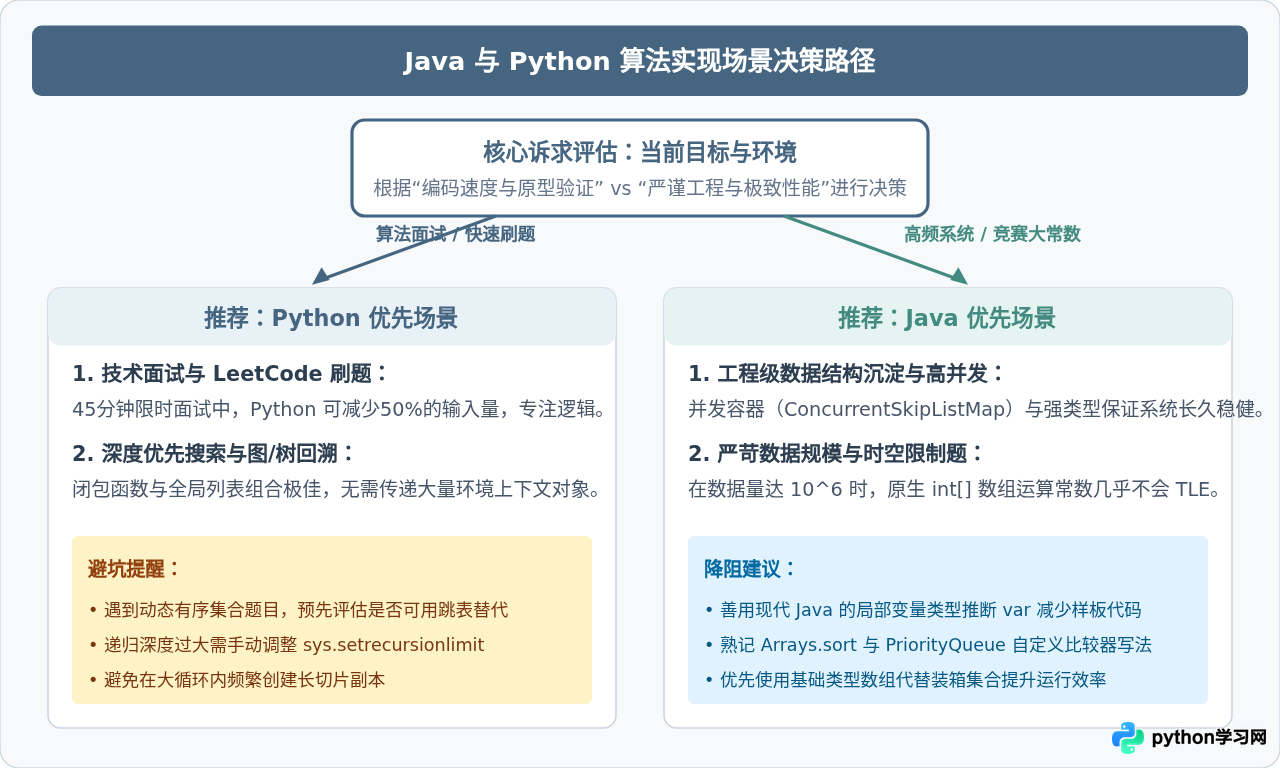
根据具体的应用目标与考核环境,合理选择语言能够事半功倍:
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















