


Python可以用来干什么?Web开发、数据分析与AI应用全景
深入解析Python的核心应用领域,系统梳理Web开发、数据分析与人工智能三大支柱的技术栈、工作流程、代码实践与选型路径。
一、Python 技术生态全景与核心支撑机制
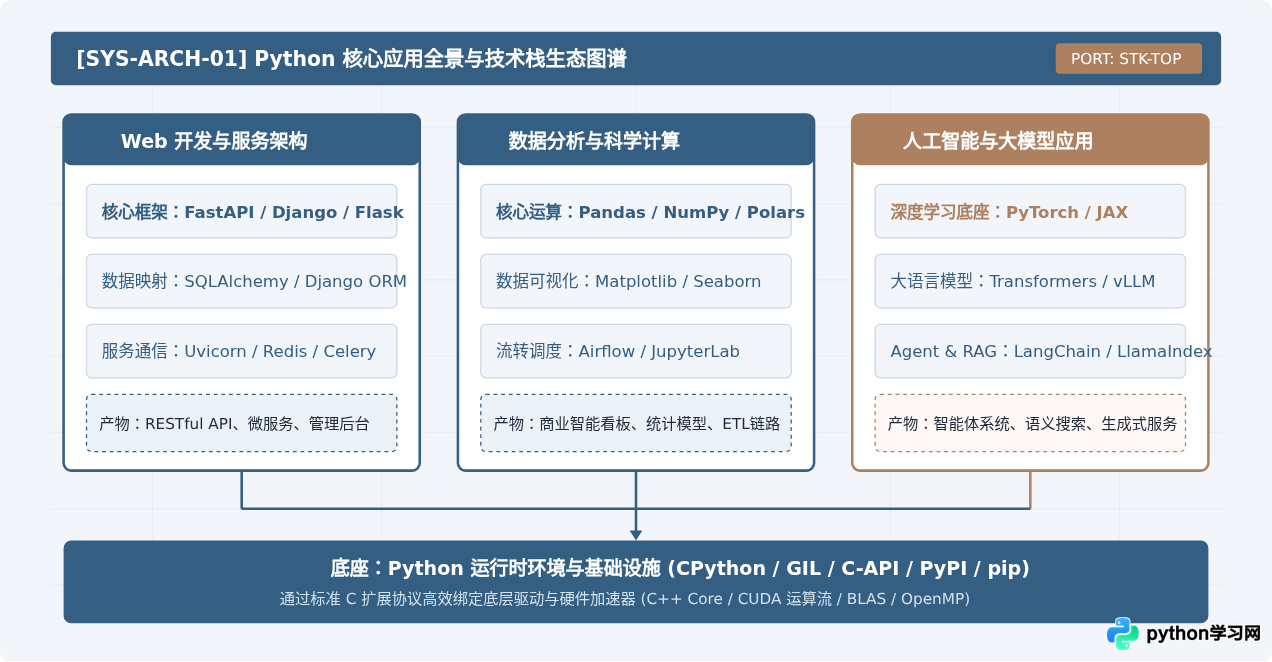
探讨 Python 能干什么,首先需要理解为什么这门运行速度弱于 C/C++ 与 Go 的解释型语言能够横跨 Web、大数据与前沿 AI 领域。其根本原因在于其卓越的“胶水语言”能力与成熟的标准包生态。
Python 核心解释器(如 CPython)提供了完善的 C/C++ 扩展接口。对于需要极致吞吐或复杂数学矩阵运算的底层模块,社区使用 C、C++ 或 CUDA 编写并编译为底层动态链接库,再通过 Python 暴露统一、直观的调用接口。开发者既享受到了 Python 简洁的语法和高研发效率,又通过底层模块获得了接近原生硬件的执行性能。
二、Web 开发领域的实际应用与架构实践
在 Web 开发方向,Python 主要用于构建后端服务、API 接口和综合管理平台。与前端渲染技术(如 React、Vue)解耦后,Python 专注于业务逻辑验证、数据持久化与外部系统协同。
1. 主流 Web 框架定位与选型考量
选择 Python 进行 Web 开发时,框架的选择直接决定了工程规范与研发效率:
- FastAPI:现代异步微服务首选。基于 Python 3.6+ 的类型注解(Type Hints)构建,原生支持异步并发(AsyncIO),自动校验入参并实时生成符合 OpenAPI 标准的 Swagger 交互文档。其高性能特性非常适合承载 AI 模型推理接口与实时高频 API。
- Django:开箱即用的全栈企业级框架。内置强大的 ORM(对象关系映射)、身份验证体系、CSRF 安全防护以及自动生成的管理后台(Django Admin)。适用于业务规则复杂、交付周期紧迫的中大型管理系统或内容型网站。
- Flask:极简微内核框架。自身仅保留路由与模板渲染等核心能力,其余组件均由开发者按需装配插件。适合开发轻量级内部工具、原型验证或单功能服务。
2. FastAPI 典型接口实现与结构
以下代码展示了如何使用 FastAPI 和 Pydantic 构建一个带类型安全校验与结构化响应的 API 模块:
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field
from typing import Optional
import uvicorn

app = FastAPI(title="用户任务服务", version="1.0.0")

# 定义入参数据验证模型
class TaskCreateRequest(BaseModel):
    title: str = Field(..., min_length=2, max_length=50, description="任务标题")
    priority: int = Field(default=1, ge=1, le=5, description="优先级1-5")
    description: Optional[str] = None

# 定义响应数据结构模型
class TaskResponse(BaseModel):
    task_id: int
    title: str
    priority: int
    status: str

# 模拟内存数据存储
task_db = {}
counter = 0

@app.post("/api/v1/tasks", response_model=TaskResponse, status_code=status.HTTP_201_CREATED)
async def create_task(payload: TaskCreateRequest):
    global counter
    counter += 1
    new_task = {
        "task_id": counter,
        "title": payload.title,
        "priority": payload.priority,
        "status": "pending"
    }
    task_db[counter] = new_task
    return new_task

if __name__ == "__main__":
    # 执行命令:uvicorn main:app --host 0.0.0.0 --port 8000
    uvicorn.run(app, host="127.0.0.1", port=8000)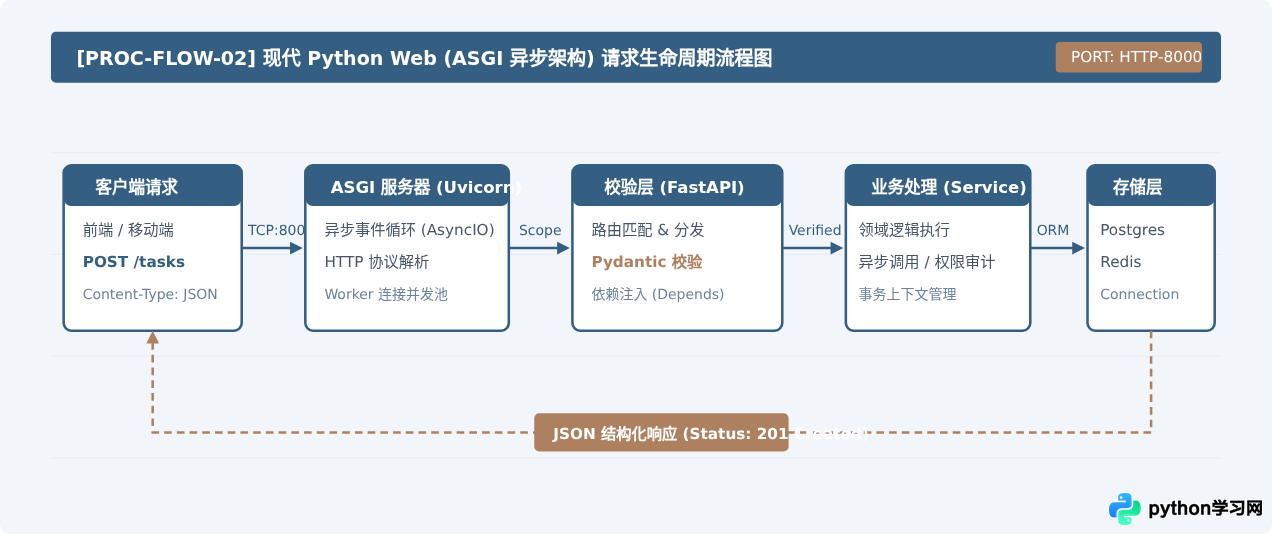
三、数据分析与科学计算的落地流水线
数据分析是 Python 确立行业主导地位的关键领域。无论是商业智能报表、财务风险计算,还是气象物理模拟,Python 均提供了一条自数据接入至可视化报告落地的闭环工具链。
1. 核心工具链的职责分工
-
NumPy:底层科学计算核心。提供了同构多维数组对象(
ndarray)及针对数组的高性能广播运算函数。底层由优化过的 C/Fortran(如 BLAS/LAPACK)驱动,是 Pandas、SciPy 与 PyTorch 的底层依赖。 -
Pandas / Polars:结构化表格数据分析的主力。Pandas 提供了
DataFrame数据结构,封装了索引管理、缺失值过滤、时间序列对齐及透视聚合(Group By)等复杂操作。面对千万级以上海量数据,基于 Rust 内核的多线程数据帧引擎 Polars 则展现出更高的内存利用率与计算性能。 - Matplotlib 与 Seaborn:数据可视化标准库。Matplotlib 提供了对图表一切绘图元素的像素级控制能力;Seaborn 则在此基础上对统计学图表(分布图、热力图、箱线图)进行了高级封装。
2. 数据清洗与统计示例代码
以下脚本演示了利用 Pandas 进行脏数据清洗、分类指标聚合计算的典型流程:
import pandas as pd
import numpy as np

# 1. 模拟生成原始业务订单数据
raw_data = {
    "order_id": [1001, 1002, 1003, 1004, 1005, 1006],
    "region": ["华东", "华北", "华东", "华南", np.nan, "华北"],
    "amount": [250.0, -10.0, 180.5, np.nan, 320.0, 450.0],
    "paid": [True, False, True, True, True, True]
}
df = pd.DataFrame(raw_data)

# 2. 数据清洗:过滤无效订单与异常金额
# 剔除区域缺失的数据,排除金额小于等于零或缺失的无效记录
cleaned_df = df.dropna(subset=["region"]).copy()
cleaned_df = cleaned_df[cleaned_df["amount"] > 0]

# 3. 聚合分析:统计各区域总成交额与订单平均值
summary = cleaned_df.groupby("region").agg(
    total_sales=("amount", "sum"),
    avg_sales=("amount", "mean"),
    order_count=("order_id", "count")
).reset_index()

# 示例输出结果呈现:
#    region  total_sales  avg_sales  order_count
# 0    华东        430.5     215.25            2
# 1    华北        450.0     450.00            1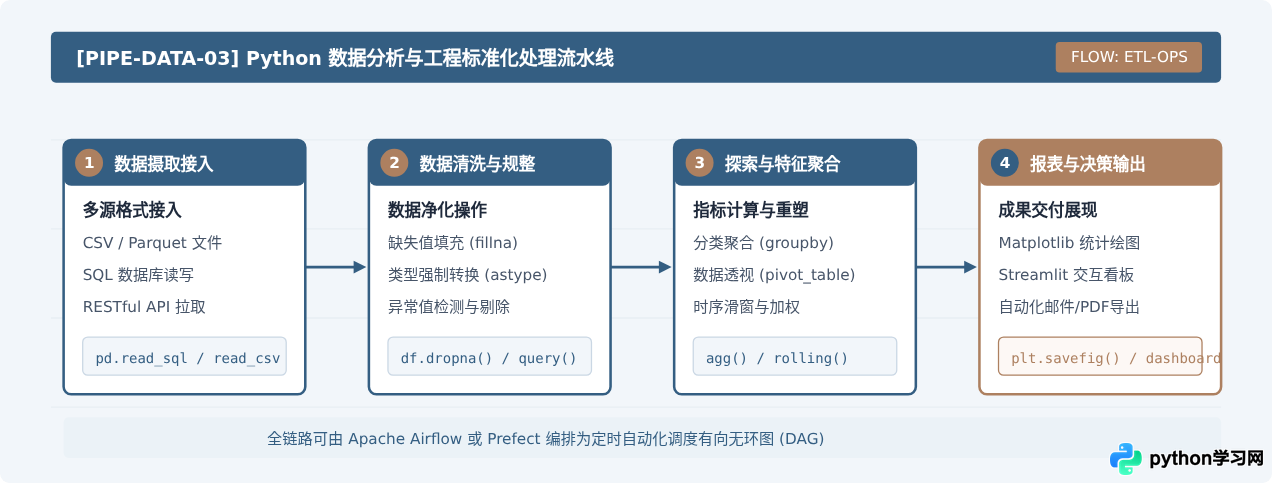
四、人工智能与机器学习的主导地位
在当今人工智能领域,Python 拥有无可撼动的行业事实标准地位。从传统的机器学习算法,到以 Transformer 为基石的计算机视觉与大语言模型(LLM),全球绝大多数 AI 研发均使用 Python 进行实验、训练和部署封装。
1. 为什么 AI 领域全面倾向 Python?
AI 模型研发具有极强的试验性质,算法研究员需要频繁调整张量维度、调试层级参数并验证假设。Python 的动态类型与交互式执行环境(如 Jupyter Notebook)提供了快速反馈循环。更为关键的是,主流硬件厂商(如 NVIDIA)深度绑定了 Python 生态,通过 CUDA 和 TensorRT 提供了直接的底层硬件加速绑定。
2. 核心技术栈划分
- 传统机器学习(Scikit-learn、XGBoost、LightGBM):专注于结构化表格数据的分类、回归、聚类与降维任务。广泛应用于电商推荐、金融风控打分、用户流失预警等场景。
- 深度学习底层框架(PyTorch、JAX、TensorFlow):提供基于计算图的自动微分能力(Autograd)与 GPU 张量加速。PyTorch 凭借灵活的动态计算图,已经成为学术界论文复现与企业模型研发的标配工具。
- 生成式 AI 与大模型框架(Hugging Face、LangChain、vLLM):在现有大模型基础设施之上,利用 Transformers 库完成开源模型权重加载与微调,利用 LangChain/LlamaIndex 构建基于检索增强生成(RAG)的知识库系统,并借助 vLLM 实现高吞吐量的推理服务。
3. 轻量级 AI 推理任务实现代码
以下示例展示了利用 Hugging Face transformers 库进行本地自然语言情感分析任务的工程代码:
from transformers import pipeline

def analyze_sentiment(text: str) -> dict:
    """
    使用预训练文本分类模型进行情感倾向预测
    环境依赖: pip install torch transformers
    """
    # 初始化文本分类推理管道(首次运行将自动下载轻量模型权重)
    classifier = pipeline(
        "sentiment-analysis",
        model="distilbert-base-uncased-finetuned-sst-2-english"
    )

    # 执行模型前向推理
    result = classifier(text)[0]
    return {
        "text": text,
        "sentiment": result["label"],
        "confidence": round(result["score"], 4)
    }

if __name__ == "__main__":
    sample_text = "The system performance improved significantly after optimization."
    output = analyze_sentiment(sample_text)

    # 示例输出:{'text': '...', 'sentiment': 'POSITIVE', 'confidence': 0.9998}
    print(f"输入文本: {output['text']}")
print(f"分析结论: {output['sentiment']} (置信度: {output['confidence']})")五、方向选择与学习演进路径
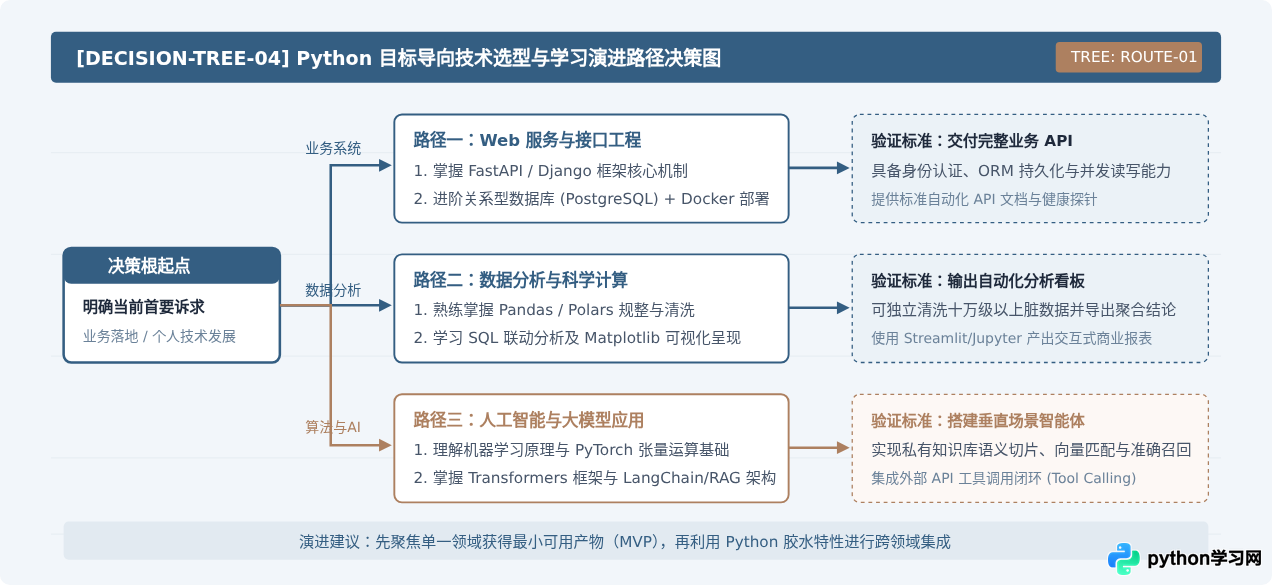
面对庞大的应用生态,初学者或技术团队不宜盲目追求“全栈掌握”,而应根据实际业务目标与核心需求,选择条件明确的演进路径。
| 技术方向 | 典型应用场景 | 核心工具组合 | 交付物形式 | 技术门槛重点 |
|---|---|---|---|---|
| Web 与后端开发 | 微服务系统、SaaS产品、管理后台 | FastAPI, Django, PostgreSQL, Docker | RESTful API、后台Web站点 | 网络协议、并发模型、数据库事务 |
| 数据分析与工程 | 商业指标报表、运营洞察、自动化ETL | Pandas, Polars, SQL, Matplotlib | 统计看板、聚合数据集、清洗脚本 | 数据结构规整、SQL调优、统计指标 |
| AI与大模型应用 | 企业知识库RAG、智能Agent、图像处理 | PyTorch, Transformers, LangChain | 推理API、智能助手、语义搜索系统 | 向量检索原理、提示词工程、微调机制 |
总结
Python 的核心价值不在于解决单一的某一类问题,而在于其高通用性与跨领域的无缝衔接能力。在同一个工程组织或业务流中,工程师可以使用 Python 的 FastAPI 搭建 Web 业务接口,使用 Pandas 清洗业务日志,同时调用由 PyTorch 训练并封装的模型进行实时预测。理解其在 Web 开发、数据分析与人工智能这三大核心领域的工程落地机制与选型依据,有助于根据具体业务场景精准选型,发挥其最高效的生产力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















