


Python数据分析新手入门:从零开始的完整操作步骤与代码示例
面向新手的Python数据分析实操指南,按步骤讲解环境准备、数据读取、数据清洗、分组统计与可视化导出的完整闭环,附带全套可运行代码示例与关键避坑说明。
Python数据分析的核心闭环由五个标准阶段组成:环境搭建与库加载、数据读取、数据清洗、聚合统计与图表呈现。本文通过一组贴近实际业务的电商销售数据集,从零演示每个环节的具体代码、参数配置与预期结果,帮助初学者建立清晰规范的数据处理习惯。
一、核心技术栈与工作环境准备
初学者进入Python数据分析时,面对众多第三方库往往容易感到无所适从。实际上,标准数据分析任务主要依赖两个基础组件:用于表格数据处理的 pandas 和用于图表绘制的 matplotlib。它们分别建立在高性能数值计算库 numpy 之上,各自承担明确的分工。
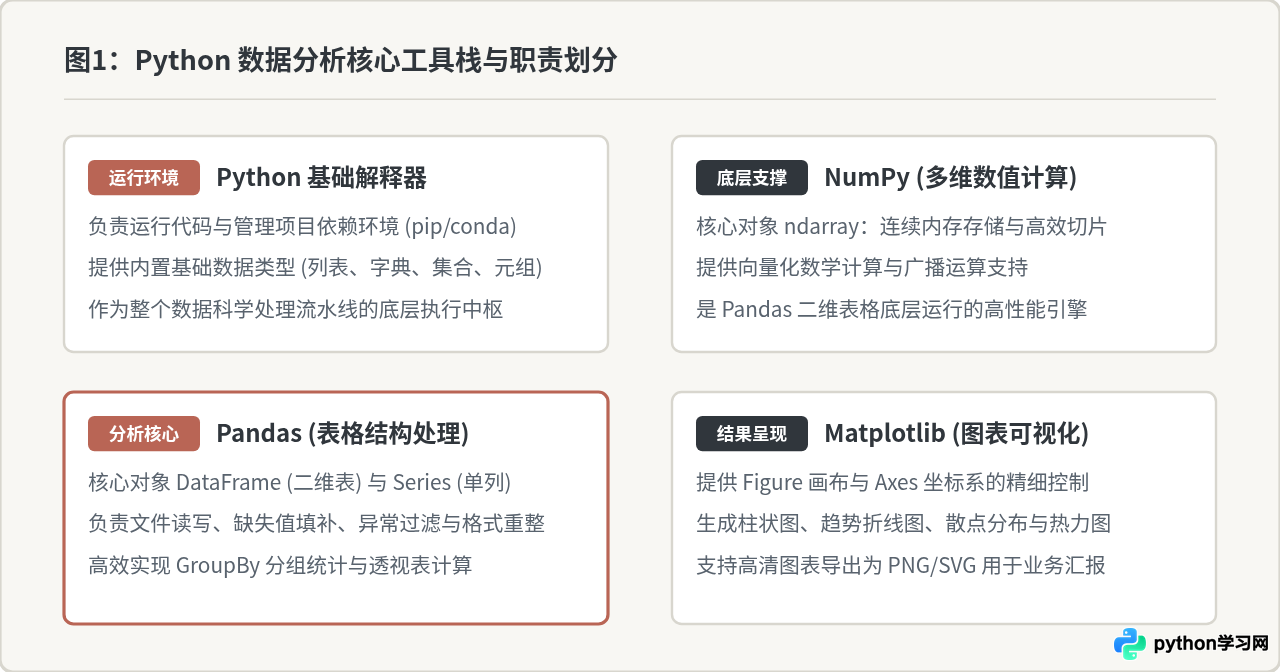
在开始编写代码前,需要在命令行终端安装所需的依赖库。执行以下命令即可完成安装:
# 在命令行终端(Terminal / CMD)中执行安装命令
pip install pandas matplotlib
安装完成后,建议在当前工作目录下创建一个 Python 脚本(例如 analysis.py),并在开头导入这两个库。通常约定使用统一的别名:
import pandas as pd
import matplotlib.pyplot as plt
二、数据加载与初识数据结构
数据分析的第一步是将外部存储的数据载入内存并转化为 DataFrame。最常见的格式是 CSV 文件与 Excel 工作簿。
1. 读取外部文件与编码处理
读取 CSV 文件使用 pd.read_csv() 函数。如果文件内包含中文字符,常见编码为 utf-8 或 gbk。若未指定正确编码,可能会抛出 UnicodeDecodeError。
# 常见读取方式:通过 encoding 参数避免中文乱码报错
# df = pd.read_csv("sales_data.csv", encoding="utf-8")

# 如果读取出现解码错误,可改用 gbk
# df = pd.read_csv("sales_data.csv", encoding="gbk")
2. 构建自包含的演示数据集
为了让初学者能够直接复制并无门槛运行后续全部示例,我们使用字典构建一个包含常见业务缺陷(缺失值、格式异常、重复行)的完整示例数据集:
import pandas as pd
import numpy as np

# 构造包含真实常见瑕疵的模拟销售数据
raw_data = {
    "订单号": ["ORD001", "ORD002", "ORD003", "ORD004", "ORD005", "ORD006", "ORD006", "ORD007"],
    "交易日期": ["2026-03-01", "2026-03-01", "2026-03-02", "2026-03-03", "2026-03-03", "2026-03-04", "2026-03-04", "2026-03-05"],
    "商品类别": ["办公用品", "数码配件", "办公用品", "数码配件", "生活日用", "数码配件", "数码配件", "办公用品"],
    "销售单价": ["120.5", "85.0", "45.0", "320.0", "15.0", "99.0", "99.0", "68.0"],
    "销售数量": [2, 1, 5, np.nan, 10, 3, 3, 4],
    "客户所在区域": ["华东", "华北", "华东", "华南", "华东", "华北", "华北", None]
}

df = pd.DataFrame(raw_data)
print("--- 原始数据预览 ---")
print(df.head())三、数据清洗与规整的标准化步骤
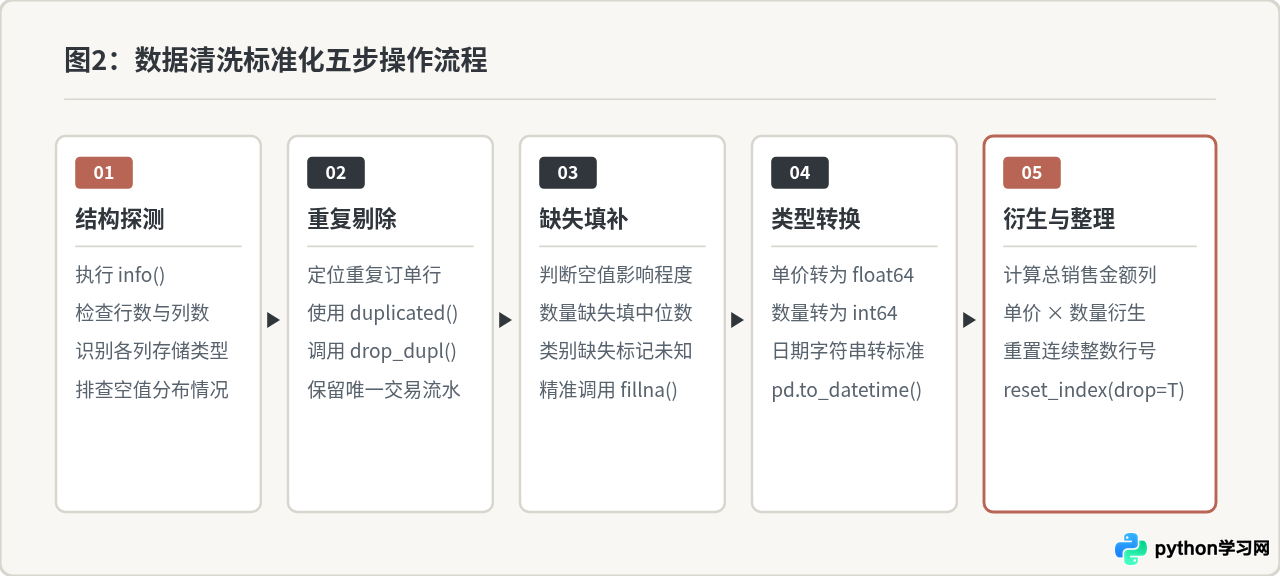
真实场景中的数据几乎都存在脏数据。如果不经清洗直接统计,会导致计算结果失真或程序报错。数据清洗应遵循固定且严密的逻辑流程。
3. 清洗代码具体实现
按照上述五步流程,使用 Pandas 编写完整清洗语句:
# 步骤 1:探测数据结构与缺失情况
print("--- 数据类型与非空统计 ---")
print(df.info())

# 步骤 2:去除完全重复的订单记录
df_clean = df.drop_duplicates(subset=["订单号"]).copy()

# 步骤 3:缺失值处理
# 对销售数量缺失项填入该列中位数(防止均值受极端大值拉偏)
median_qty = df_clean["销售数量"].median()
df_clean["销售数量"] = df_clean["销售数量"].fillna(median_qty)

# 对分类文本的缺失标记为“未知区域”
df_clean["客户所在区域"] = df_clean["客户所在区域"].fillna("未知区域")

# 步骤 4:数据类型转换
# 销售单价原始数据为字符串,转为浮点型;数量转为整型;日期转为标准日期对象
df_clean["销售单价"] = df_clean["销售单价"].astype(float)
df_clean["销售数量"] = df_clean["销售数量"].astype(int)
df_clean["交易日期"] = pd.to_datetime(df_clean["交易日期"])

# 步骤 5:衍生计算与索引重置
df_clean["销售总额"] = df_clean["销售单价"] * df_clean["销售数量"]
df_clean = df_clean.reset_index(drop=True)

print("\n--- 清洗后规范数据 ---")
print(df_clean)当通过切片或条件筛选获取子表后再直接赋值时,Pandas 往往会弹出 SettingWithCopyWarning 警告。这是因为系统无法确认你是在修改原数据还是视图。解决方法是在切片或筛选后明确调用 .copy(),例如上例中的 df.drop_duplicates(...).copy(),这样便可彻底杜绝隐蔽的赋值异常。
四、数据聚合统计与分组计算
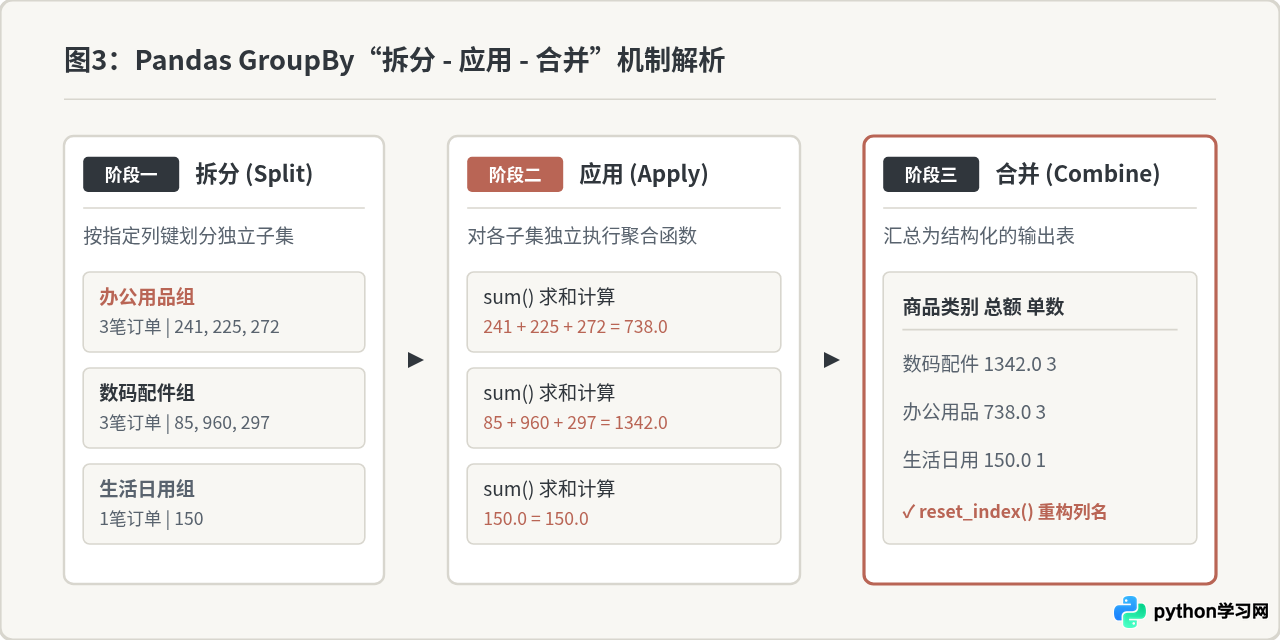
完成数据清洗后,下一步是按照特定业务维度(如商品类别、地区或时间)汇总关键指标。Pandas 采用的 groupby 机制遵循经典的“拆分 - 应用 - 合并”(Split - Apply - Combine)模型。
4. 常用分组统计代码
在实际开发中,推荐使用 agg() 函数一次性完成多个指标的综合计算:
# 按“商品类别”分组,分别统计总金额、平均单价和订单数
category_summary = df_clean.groupby("商品类别").agg(
    总销售额=("销售总额", "sum"),
    平均单价=("销售单价", "mean"),
    订单总量=("订单号", "count")
).reset_index()

# 按照总销售额从高到低排序
category_summary = category_summary.sort_values(by="总销售额", ascending=False)
print("--- 商品类别统计汇总 ---")
print(category_summary)五、数据可视化与成果呈现
统计结果以表格呈现时不够直观,借助图表可以快速抓住业务核心。在使用 matplotlib 绘图时,国内初学者最常遇到的问题是中文显示为方块或乱码。这是由于系统缺少指定中文字体所致。
1. 配置中文字体与图形基础
# 解决 Matplotlib 中文显示为方块的问题
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei', 'sans-serif']
# 解决负号 '-' 显示为方块的问题
plt.rcParams['axes.unicode_minus'] = False
2. 生成柱状图并导出图片
以下代码以面向对象的规范写法生成各类别销售额柱状图,并在柱顶标注具体数值,最后保存为本地图片:
# 创建画布与子图对象
fig, ax = plt.subplots(figsize=(8, 4.5), dpi=100)

# 绘制柱状图,指定主色调
bars = ax.bar(category_summary["商品类别"], category_summary["总销售额"], color="#B96555", width=0.5)

# 在每个柱子上方添加具体的金额数值
for bar in bars:
    height = bar.get_height()
    ax.annotate(f"{height:.1f}元",
                xy=(bar.get_x() + bar.get_width() / 2, height),
                xytext=(0, 4),  # 垂直偏移4点
                textcoords="offset points",
                ha='center', va='bottom', fontsize=10, color="#30363C")

# 设置图表标题与坐标轴标签
ax.set_title("各商品类别总销售额统计", fontsize=14, fontweight="bold", pad=12, color="#30363C")
ax.set_xlabel("商品类别", fontsize=11, color="#59636E")
ax.set_ylabel("销售总额 (元)", fontsize=11, color="#59636E")
ax.set_ylim(0, max(category_summary["总销售额"]) * 1.2)  # 留出顶部间距

# 去除上方与右侧边框,保持视觉清爽
ax.spines['top'].set_visible(False)
ax.spines['right'].set_visible(False)
ax.spines['left'].set_color('#D8D6CE')
ax.spines['bottom'].set_color('#D8D6CE')

# 自动调整边距并保存
plt.tight_layout()
plt.savefig("sales_by_category.png", dpi=200)
print("图表已成功保存为 sales_by_category.png")
六、零基础端到端完整实战代码
为了让读者可以直接在本地运行并复现整个过程,以下是将上述全部环节整合后的完整脚本。代码无需外部数据文件输入,直接运行即可查看从清洗、聚合到输出的完整控制台反馈。
"""
Python 数据分析新手入门:端到端完整实战脚本
功能:从零构建脏数据 -> 清洗规整 -> 分组聚合 -> 图表导出
执行环境:Python 3.8+,需安装 pandas, matplotlib, numpy
"""
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt

def main():
    print("=== 第一步:加载与模拟原始数据 ===")
    raw_data = {
        "订单号": ["ORD001", "ORD002", "ORD003", "ORD004", "ORD005", "ORD006", "ORD006", "ORD007"],
        "交易日期": ["2026-03-01", "2026-03-01", "2026-03-02", "2026-03-03", "2026-03-03", "2026-03-04", "2026-03-04", "2026-03-05"],
        "商品类别": ["办公用品", "数码配件", "办公用品", "数码配件", "生活日用", "数码配件", "数码配件", "办公用品"],
        "销售单价": ["120.5", "85.0", "45.0", "320.0", "15.0", "99.0", "99.0", "68.0"],
        "销售数量": [2, 1, 5, np.nan, 10, 3, 3, 4],
        "客户所在区域": ["华东", "华北", "华东", "华南", "华东", "华北", "华北", None]
    }
    df = pd.DataFrame(raw_data)
    print("原始数据包含行数:", len(df))

    print("\n=== 第二步:执行标准化数据清洗 ===")
    # 1. 去重
    df_clean = df.drop_duplicates(subset=["订单号"]).copy()
    # 2. 缺失填补
    median_val = df_clean["销售数量"].median()
    df_clean["销售数量"] = df_clean["销售数量"].fillna(median_val)
    df_clean["客户所在区域"] = df_clean["客户所在区域"].fillna("未知区域")
    # 3. 强制类型转换
    df_clean["销售单价"] = df_clean["销售单价"].astype(float)
    df_clean["销售数量"] = df_clean["销售数量"].astype(int)
    df_clean["交易日期"] = pd.to_datetime(df_clean["交易日期"])
    # 4. 业务衍生列
    df_clean["销售总额"] = df_clean["销售单价"] * df_clean["销售数量"]
    df_clean = df_clean.reset_index(drop=True)
    print("清洗后有效订单数:", len(df_clean))
    print(df_clean[["订单号", "商品类别", "销售总额", "客户所在区域"]])

    print("\n=== 第三步:维度分组与指标聚合 ===")
    category_summary = df_clean.groupby("商品类别").agg(
        总销售额=("销售总额", "sum"),
        平均单价=("销售单价", "mean"),
        订单总量=("订单号", "count")
    ).reset_index().sort_values(by="总销售额", ascending=False)
    print(category_summary)

    print("\n=== 第四步:数据导出与图表渲染 ===")
    # 导出清晰规范的 CSV 结果文件
    category_summary.to_csv("clean_summary.csv", index=False, encoding="utf-8-sig")
    print("结构化统计结果已导出至 clean_summary.csv")

    # 绘图配置
    plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei', 'sans-serif']
    plt.rcParams['axes.unicode_minus'] = False

    fig, ax = plt.subplots(figsize=(7, 4), dpi=100)
    bars = ax.bar(category_summary["商品类别"], category_summary["总销售额"], color="#B96555", width=0.45)
    for bar in bars:
        h = bar.get_height()
        ax.annotate(f"{h:.1f}", xy=(bar.get_x() + bar.get_width() / 2, h),
                    xytext=(0, 3), textcoords="offset points", ha='center', va='bottom', fontsize=9)
    ax.set_title("商品类别销售总额对比", fontsize=12, fontweight="bold")
    ax.set_ylabel("金额 (元)", fontsize=10)
    ax.spines['top'].set_visible(False)
    ax.spines['right'].set_visible(False)
    plt.tight_layout()
    plt.savefig("category_sales.png", dpi=150)
    print("可视化柱状图已生成: category_sales.png")
    print("\n全套流程执行完成!")

if __name__ == "__main__":
    main()
七、全流程自检与新手避坑清单
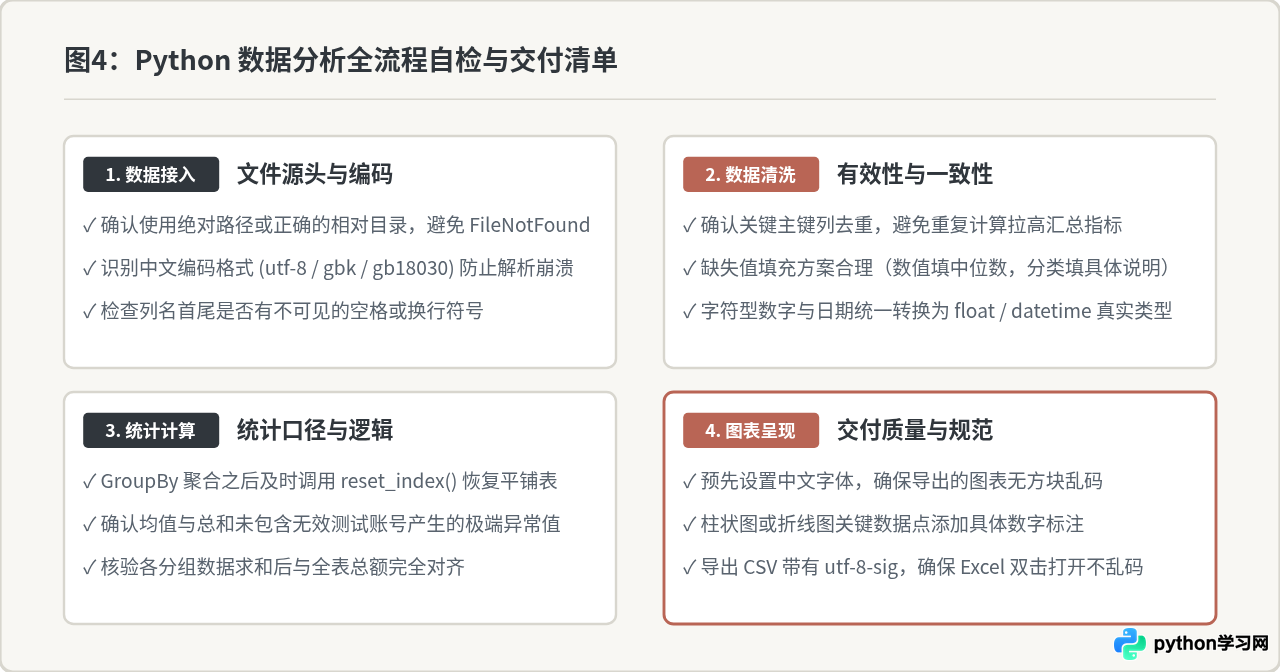
为了保证分析结果准确可信,在向业务团队提交数据结果或图表之前,建议对照以下四个核心维度完成全流程自检:
常见高频疑问解答
| 常见现象 / 报错 | 诱发原因 | 针对性解决方案 |
|---|---|---|
KeyError: 'xxx' |
请求的列名在 DataFrame 中不存在,往往是表头有隐藏空格 | 运行 df.columns = df.columns.str.strip() 批量清除首尾空格。 |
TypeError: unsupported operand... |
尝试对包含字符串的列执行数学计算 | 使用 df['col'] = pd.to_numeric(df['col'], errors='coerce') 强制转为数值。 |
| 导出的 CSV 在 Excel 打开中文乱码 | Excel 默认无法自动识别无 BOM 标记的普通 UTF-8 编码 | 保存时使用参数 encoding='utf-8-sig'。 |
掌握以上数据加载、清洗规整、分组统计与可视化展现的标准流程后,新手就已经具备了处理大多数日常业务分析需求的基础能力。在后续深入学习中,可以进一步探索多表关联(merge / join)、透视表(pivot_table)以及时间序列分析等高阶技能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















