


Python数据分析完整流程:从数据获取到结论输出
系统梳理Python数据分析的完整工作流,详解从多源数据获取、探索清洗、统计建模到可视化决策结论输出的完整实践与落地规范。
一个完整的 Python 数据分析项目由四个标准阶段构成:数据获取、数据清洗与探索性分析(EDA)、统计建模与深度分析、可视化与决策结论输出。分析工作的核心不是单纯运行函数代码,而是围绕明确的目标问题建立可靠的数据证据链,最终形成具备可执行性的商业或业务结论。
阶段一:数据获取与标准化接入
数据分析的第一步是将分散在不同介质中的数据以结构化形式载入内存。在 Python 生态中,通常使用 pandas 作为中枢载体,将本地平面文件、关系型数据库及 Web API 统一映射为标准的二维数据表(DataFrame)。
在面对不同数据源时,接入策略存在差异:本地 CSV 或 Excel 文件需防范字符集编码错误与大文件内存占用;SQL 数据库应优先在数据库端完成初步筛选与聚合,避免全表载入引发单机内存溢出;Web API 则需处理网络异常重试与多层嵌套 JSON 字段的扁平化展开。
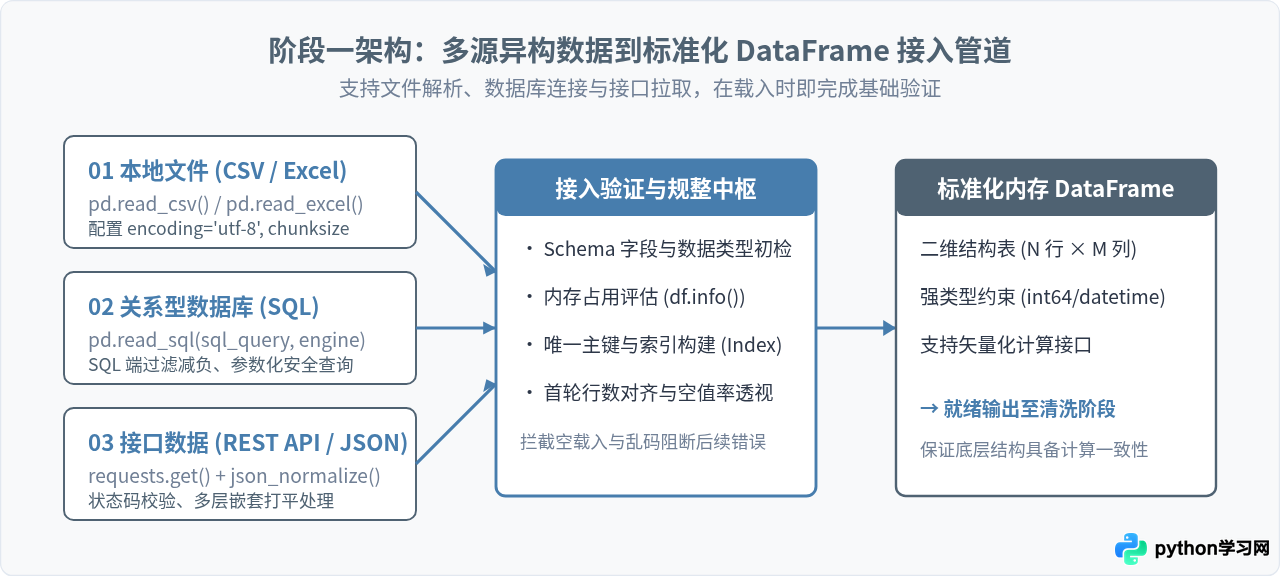
以下代码演示从 CSV 文件和网络接口分别加载数据并核验基本维度的标准写法:
import pandas as pd
import requests

# 1. 本地结构化文件读取:指定编码与核心列
try:
    df_sales = pd.read_csv('sales_data.csv', encoding='utf-8', parse_dates=['order_date'])
except UnicodeDecodeError:
    # 针对 Windows 系统常见 GBK 编码文件的后备机制
    df_sales = pd.read_csv('sales_data.csv', encoding='gbk', parse_dates=['order_date'])

# 2. 网络 JSON 接口数据获取与层级展平
api_url = "https://api.example.com/v1/orders"
response = requests.get(api_url, timeout=10)
if response.status_code == 200:
    raw_json = response.json()
    # 将包含多层嵌套的字典数组展平为平铺结构
    df_api = pd.json_normalize(raw_json['data'])
else:
    raise ConnectionError(f"数据请求失败,响应状态码: {response.status_code}")

# 查看基础维度与内存结构
print("数据集尺寸:", df_sales.shape)
print("各列类型概览:\n", df_sales.dtypes)
阶段二:数据清洗与探索性分析(EDA)
原始数据通常存在缺失、重复、类型不符或业务逻辑冲突。清洗与探索性分析(Exploratory Data Analysis)并非割裂的两个步骤,而是通过统计探查发现问题、通过清洗修正问题、再通过重新探查验证质量的循环过程。
1. 结构全景审视
执行 df.info() 能快速确认每列非空值数量与内存类型,而 df.describe() 则提供数值列的均值、极值与四分位数。通过这些统计量可快速识别异常:例如年龄出现负数、交易金额最大值超出常规业务范围几个数量级等。
2. 关键清洗动作
- 缺失值处理:非随机缺失应分析原因;随机缺失根据重要程度决定剔除(
dropna)或以中位数、分组均值进行填充(fillna)。 - 重复记录剔除:区分全局重复与依据业务主键(如订单号、用户ID)的局部重复(
drop_duplicates(subset=['order_id']))。 - 异常值识别:结合业务边界与统计学准则(如 3-Sigma 原则或 IQR 四分位距法),对离群点实施截断(Clipping)或打标分析。
- 类型强制转换与特征衍生:将混杂字符串转换为数值,将日期字符串解析为时间序列,并提取月份、周几、客单价等业务衍生特征。
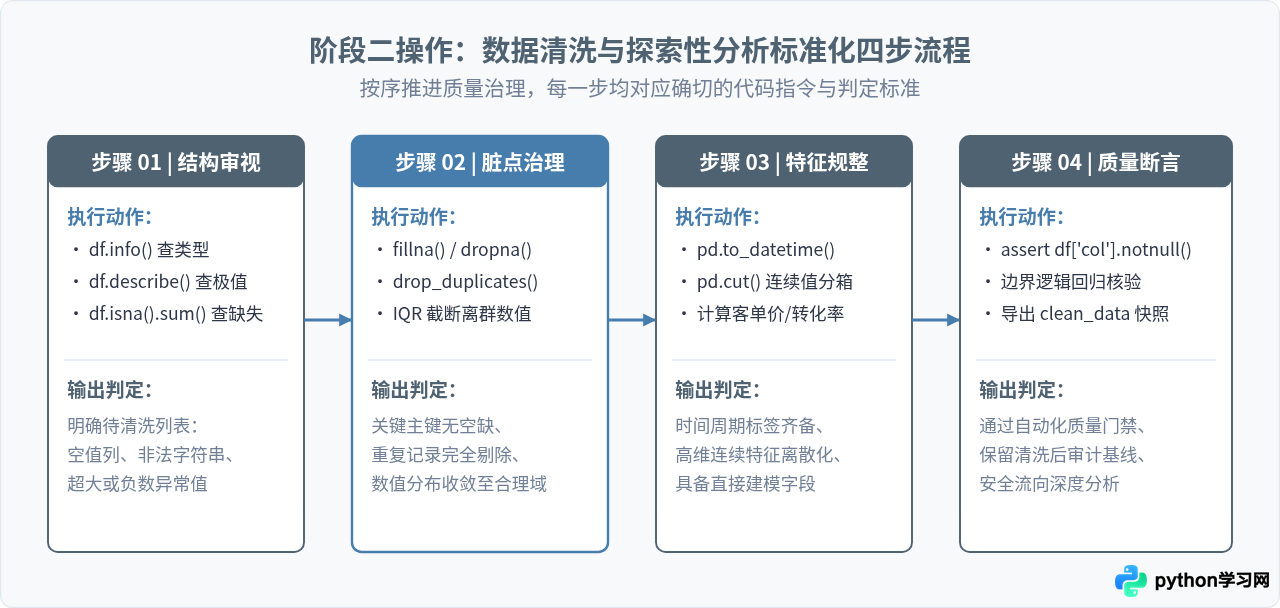
下面是一段典型的数据治理代码示例:
import numpy as np

# 1. 剔除全行重复项及指定主键重复项
df_clean = df_sales.drop_duplicates(subset=['order_id'], keep='last').copy()

# 2. 缺失值填充:类别字段填补默认值,数值字段使用中位数填充
df_clean['customer_segment'] = df_clean['customer_segment'].fillna('Unknown')
median_amount = df_clean['amount'].median()
df_clean['amount'] = df_clean['amount'].fillna(median_amount)

# 3. IQR 规则识别并盖帽处理(Clipping)异常高额交易
q1 = df_clean['amount'].quantile(0.25)
q3 = df_clean['amount'].quantile(0.75)
iqr = q3 - q1
upper_bound = q3 + 1.5 * iqr
lower_bound = max(0, q1 - 1.5 * iqr)
df_clean['amount_capped'] = df_clean['amount'].clip(lower=lower_bound, upper=upper_bound)

# 4. 时间衍生特征生成
df_clean['order_year_month'] = df_clean['order_date'].dt.to_period('M')
df_clean['is_weekend'] = df_clean['order_date'].dt.dayofweek.isin([5, 6]).astype(int)

# 5. 断言检查:确保核心关键列不存在脏数据
assert df_clean['amount_capped'].isna().sum() == 0, "金额列仍存在缺失值"
print(f"清洗完成,有效样本量: {len(df_clean)} 行")
阶段三:深度分析计算与归因推导
清洗完成的数据集进入实际业务计算环节。初学者容易停留在“分组求和”阶段,但完整的数据分析应当包含三个递进层次:描述性分析(发生了什么)、诊断性分析(为什么发生)和预测性探索(未来会怎样)。
分析的核心方法包括多维聚合分析(Aggregation)、交叉透视(Pivot Table)、相关性矩阵分析以及同期群分析(Cohort Analysis)。在得出指标波动后,关键任务是排除虚假相关,通过控制变量法或拆解细分漏斗定位真实驱动因素。
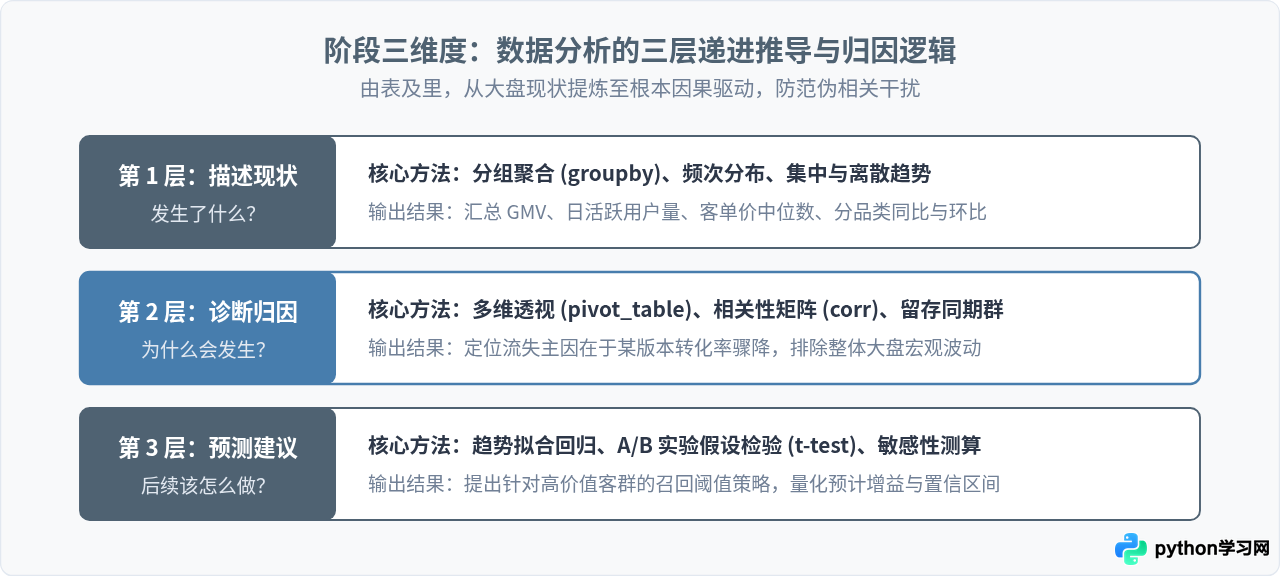
以下代码展示如何利用透视表与统计检验进行多维度下钻,定位业绩波动的具体客群:
from scipy import stats

# 1. 多维度透视:分析各区域在不同客户群体上的交易总额与频次
pivot_summary = pd.pivot_table(
    df_clean,
    values='amount_capped',
    index='region',
    columns='customer_segment',
    aggfunc=['count', 'mean', 'sum'],
    fill_value=0
)
print("区域 × 客群交叉透视表:\n", pivot_summary)

# 2. 统计假设检验:验证新旧两类渠道的客单价差异是否具有统计显著性
group_a = df_clean[df_clean['channel'] == 'Organic']['amount_capped']
group_b = df_clean[df_clean['channel'] == 'Paid']['amount_capped']

t_stat, p_val = stats.ttest_ind(group_a, group_b, equal_var=False)
print(f"独立样本 t 检验结果: t统计量 = {t_stat:.4f}, p值 = {p_val:.4e}")

if p_val < 0.05:
    print("结论:两类渠道客户在客单价上存在显著统计差异,可作为差异化定价依据。")
else:
    print("结论:未发现显著差异,均值微小波动可能仅为随机抽样误差。")
阶段四:可视化表达与结论输出
分析的最终目的是赋能决策。没有形成明确商业行动指引的图表只是中间过程。在结论呈现时,需遵守“金字塔原理”:先给出核心结论与具体行动建议,再展现关键图表证据,最后附上技术假设、数据口径与潜在风险。
图表选型与设计原则
- 时间趋势:使用折线图(Line Chart),展示连续维度的演变,同时标出重大节点事件。
- 分类对比:使用水平或垂直条形图(Bar Chart),按数值大小降序排列,降低阅读疲劳。
- 相关关系:使用散点图(Scatter Plot)配合趋势线,直观呈现两变量关联强度。
- 避免图表垃圾:杜绝使用倾斜的 3D 饼图或难以辨识的多重双 Y 轴,保持图面元素高信息密度。
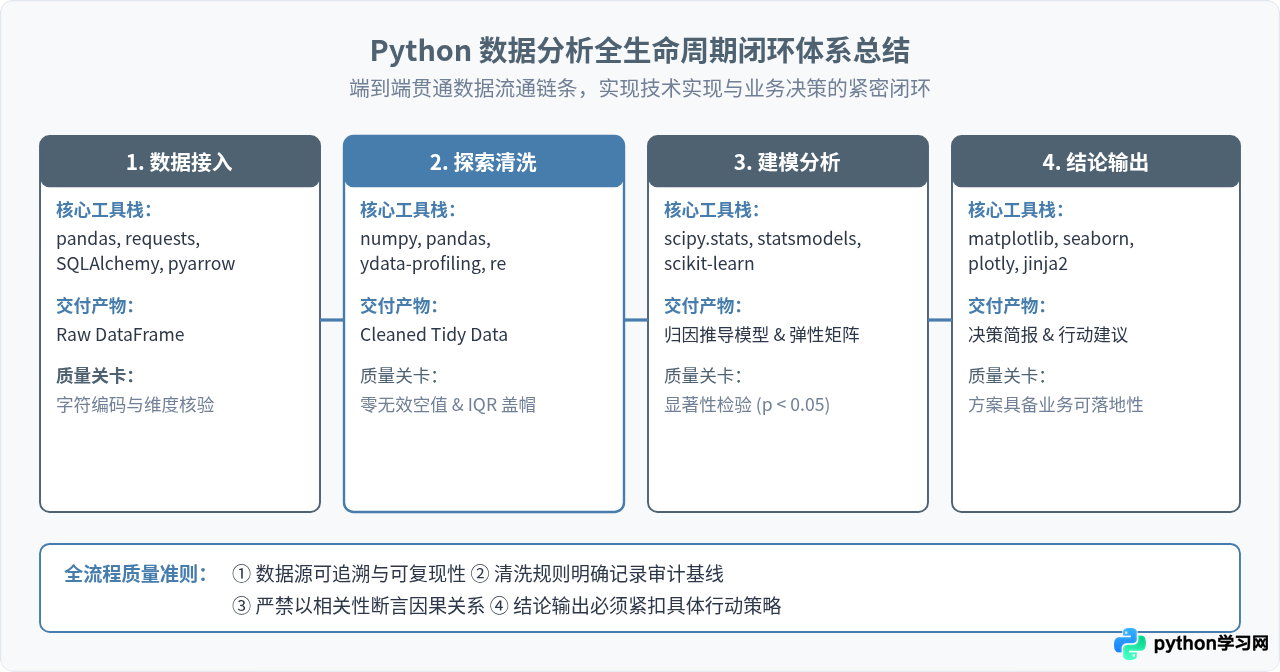
结论输出的规范结构
- 执行摘要(Executive Summary):用 2-3 句话直接陈述关键发现与预期影响。
- 核心指标证据:列出支撑结论的 2-3 个关键统计数字,配合简洁的高对比图表。
- 潜在因果机制与边界:说明该结论在哪些细分场景成立,在哪些条件下可能失效(如季节性、样本偏差)。
- 具体行动倡议(Actionable Recommendations):按优先级排列接下来业务团队应执行的具体动作及对应负责人,设定跟踪周期与效果度量指标。
掌握 Python 数据分析不仅要求熟练使用各类库的 API,更重要的是建立从原始数据到可靠结论的严谨思维逻辑:始终从业务问题出发,以可验证的代码清洗加工,以审慎的统计方法推导,最终以清晰的图表和建议交付价值。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















