


Python数据分析常用库有哪些?Pandas、NumPy与Matplotlib的作用
深入解析Python数据分析领域最常用的三大核心基石库:NumPy、Pandas与Matplotlib的核心作用、底层机制、协同工作流与实战选型指南。
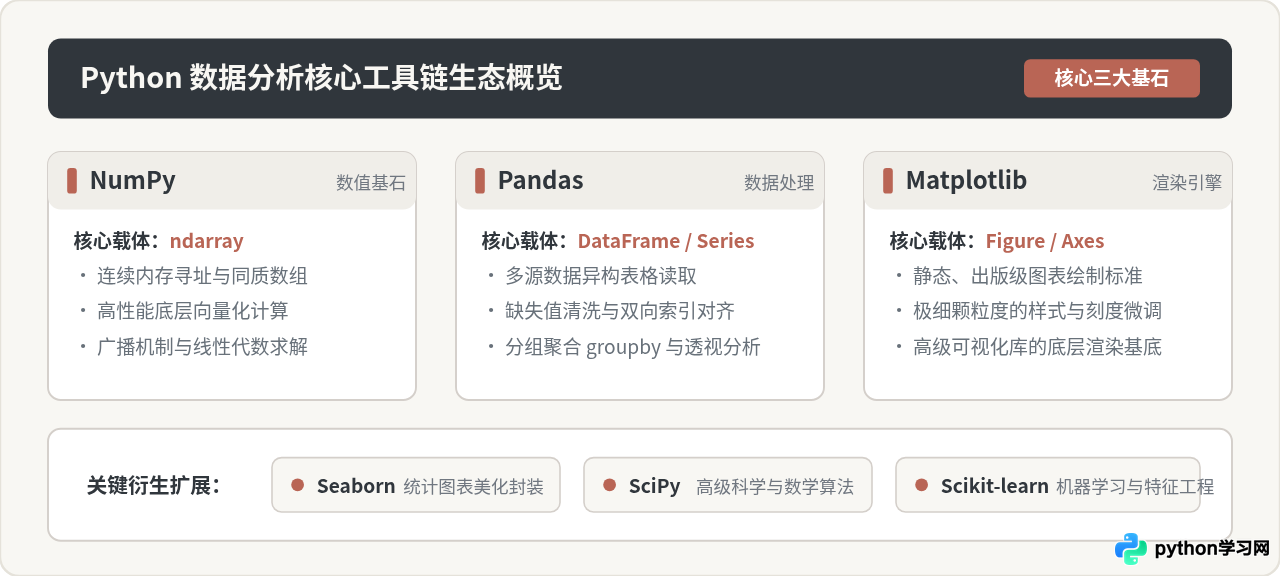
一、分层体系:为什么数据分析需要这三大基石?
初学者常有一个疑问:既然 Python 已经内置了列表(list)、字典(dict)以及基础数学运算模块,为什么进行数据分析时几乎必须引入 NumPy、Pandas 与 Matplotlib?
根本原因在于执行效率、内存模型与抽象层级的差异。Python 原生列表由分散在内存中的对象指针组成,每读取一个元素都需要解引用并进行动态类型检查,在面对几十万甚至数千万行数据时,纯 Python 循环的耗时将变得无法忍受。NumPy 直接在底层调用 C/C++ 与 Fortran 编写的线性代数库(BLAS/LAPACK),实现了紧凑的内存排布与硬件级 SIMD 指令并行;Pandas 则在此基础上引入了二维表格与行/列语义标签,让缺失值处理、时间重采样、关联拼接变得直观可控;最后由 Matplotlib 完成数据到几何图形的映射。
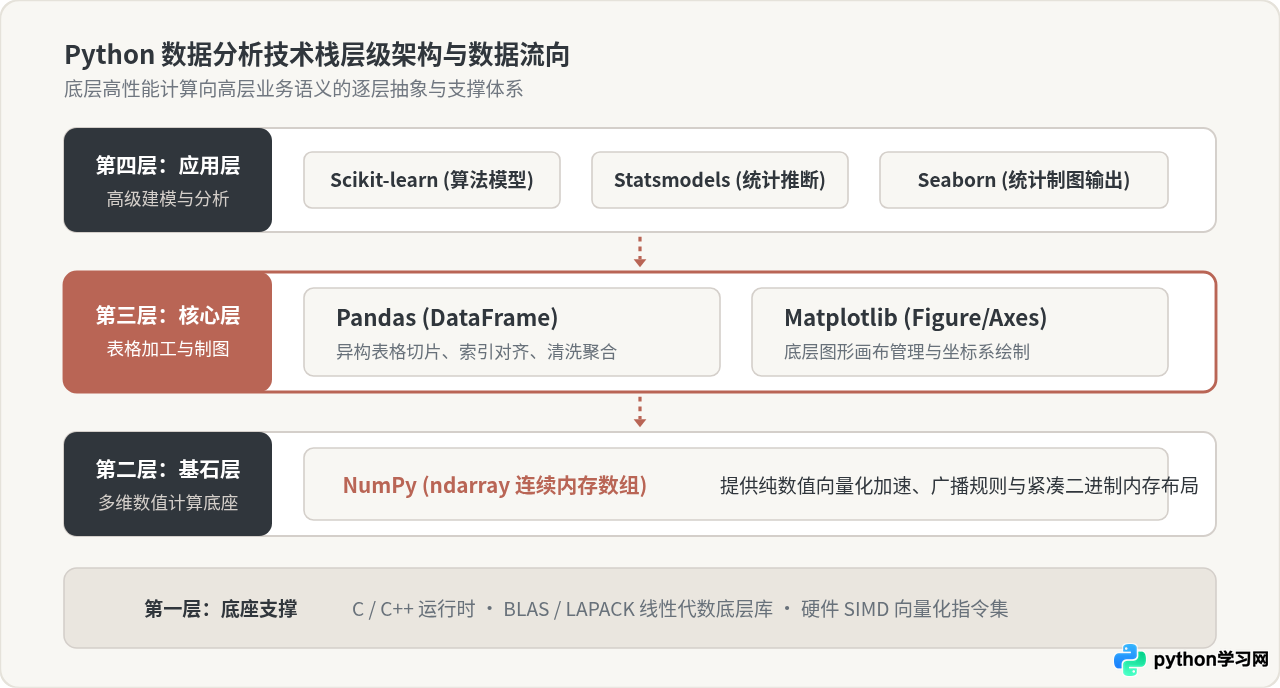
从架构上看,自底向上的依赖关系非常严谨:
- 底层运算引擎:硬件指令与 C 语言基础库,保证计算吞吐量。
- NumPy(基石层):管理纯粹同质的连续内存多维数组(
ndarray),提供纯数值数学运算。 - Pandas 与 Matplotlib(核心层):Pandas 将内存数组组织成带列名与索引的业务表;Matplotlib 接收数组数据并绘制点、线、面。
- 高级应用层:诸如 Scikit-learn 训练模型、Seaborn 快速绘图,输入几乎全部直接接收 NumPy 数组或 Pandas 数据帧。
二、NumPy 的核心作用:高效的多维数值计算基石
NumPy(Numerical Python)是整个 Python 科学计算生态的绝对基石。它的首要任务就是解决原生 Python 运算速度慢和内存冗余的问题。
1. 核心载体:多维同质数组 ndarray
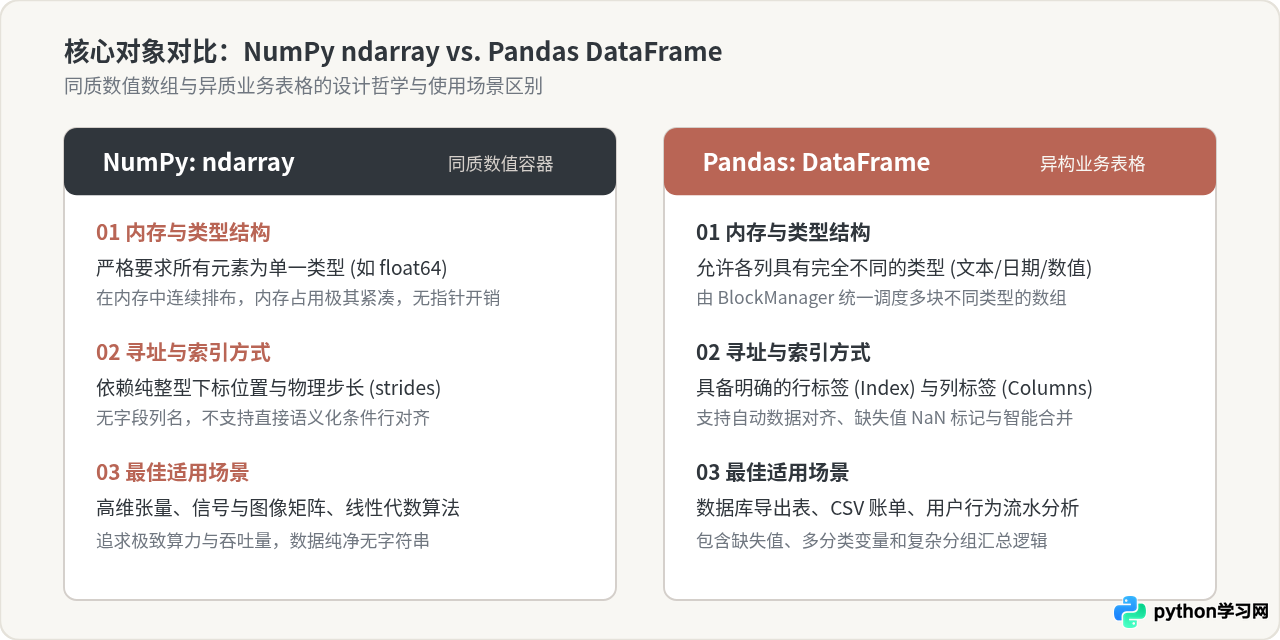
NumPy 最关键的类是 ndarray。与原生列表可以混合存放字符串、整数、字典不同,ndarray 要求其中所有元素具有完全相同的数据类型(例如全为 float64 或全为 int32)。因为类型固定,NumPy 可以在内存中开辟一段连续的二进制空间,直接通过指针步长(strides)快速寻址,消除了解释器装箱(boxing)与拆箱的开销。
2. 向量化运算(Vectorization)与广播机制(Broadcasting)
在 NumPy 中对数组进行算术操作,不需要编写任何 for 循环,代码以数学矩阵公式的方式直接书写:
import numpy as np

# 创建两个包含 100 万个浮点数的数组
arr_a = np.linspace(1.0, 10.0, num=1_000_000)
arr_b = np.full(1_000_000, 2.5)

# 向量化加法与乘法(底层 C 循环,无需 Python for 循环)
arr_result = (arr_a * 1.5) + arr_b

print(f"数据形状: {arr_result.shape}")
print(f"数据类型: {arr_result.dtype}")
print(f"前 3 个计算结果: {arr_result[:3]}")如果两个数组形状不一致,NumPy 的广播机制会自动在缺失或长度为 1 的维度上虚拟扩展,让不同维度的矩阵也能顺畅运算,无需手动复制数据占用额外内存。
三、Pandas 的核心作用:结构化与表格数据处理能手
如果说 NumPy 是为数学和算法工程师设计的数值引擎,那么 Pandas(Python Data Analysis Library)就是专门为业务分析师、数据科学家打造的“代码版 Excel + SQL”。
1. 核心载体:Series 与 DataFrame
Pandas 基于 NumPy 封装了两种关键数据结构:
- Series:带标签的一维同构数组,类似于表格里的一列,拥有数据索引(Index)。
- DataFrame:带行索引(Index)和列标签(Columns)的二维异构表格,每列可以有独立的数据类型(字符串、浮点数、整数、布尔值等)。
2. Pandas 的主要职责
- 多源数据输入输出(I/O):一行代码直接读取或写入 CSV、Excel、Parquet、JSON 以及主流 SQL 关系型数据库。
- 缺失值处理:真实业务数据充满空缺,Pandas 提供了完善的
isna()、fillna()、dropna()方法,支持均值插补、前向填充或安全剔除。 - 索引自动对齐:两个表格合并或执行运算时,Pandas 会严格根据行/列标签自动寻找匹配项,避免错位。
- 分组聚合(Split-Apply-Combine):通过
groupby()配合求和、均值、分位数等聚合函数,能轻松实现商业报表分析。 - 时间序列支持:原生支持日期范围生成、时区转换以及按日、周、月周期重采样(
resample)。
import pandas as pd
import numpy as np

# 构造包含缺失值的异构业务数据
raw_data = {
    "订单号": ["ORD-101", "ORD-102", "ORD-103", "ORD-104", "ORD-105"],
    "销售大区": ["华东", "华南", "华东", "华北", "华南"],
    "销售额": [1200.0, np.nan, 2300.0, 850.0, 3100.0],
    "是否完成": [True, False, True, True, True]
}

df = pd.DataFrame(raw_data)

# 1. 缺失值填充:将销售额的空值替换为该列中位数
df["销售额"] = df["销售额"].fillna(df["销售额"].median())

# 2. 分组聚合统计:按大区计算订单数量与平均销售额
summary = df.groupby("销售大区").agg(
    订单总数=("订单号", "count"),
    平均销售额=("销售额", "mean")
).reset_index()

print("清洗后分组汇总结果:")
print(summary)四、Matplotlib 的核心作用:灵活可靠的可视化渲染引擎
数据清洗和聚合后,需要转化为图表以直观揭示分布、趋势与离群点。Matplotlib 是 Python 社区中最资深、生态最稳固的 2D 绘图库,被誉为 Python 可视化的“事实工业标准”。
1. 架构哲学:Figure(画布)与 Axes(坐标系)
初学者容易被 Matplotlib 的两套绘图接口搞混:一套是模仿 MATLAB 的快捷函数 plt.plot(),另一套是面向对象接口(Object-Oriented API)。在实际工程与严肃分析中,强烈推荐始终使用面向对象方式:
Figure:整张图表的总画卷,管理图表大小、背景色以及保存导出的文件分辨率。Axes:放置在 Figure 上的具体绘图坐标系(子图)。真正的数据折线、柱子、刻度线、网格和坐标轴标签均由 Axes 管辖。
import matplotlib.pyplot as plt

# 准备绘图数据
months = ["1月", "2月", "3月", "4月", "5月"]
sales_a = [120, 145, 180, 160, 210]
sales_b = [90, 110, 130, 175, 195]

# 1. 创建 Figure 与 1行2列的 Axes 坐标系
fig, (ax1, ax2) = plt.subplots(nrows=1, ncols=2, figsize=(10, 4), dpi=100)

# 2. 在第一个子图上绘制折线走势图
ax1.plot(months, sales_a, marker="o", color="#B96555", label="产品 A")
ax1.plot(months, sales_b, marker="s", color="#30363C", label="产品 B")
ax1.set_title("月度销售趋势对比")
ax1.set_ylabel("销售额 (万元)")
ax1.grid(True, linestyle="--", alpha=0.5)
ax1.legend()

# 3. 在第二个子图上绘制柱状对比图
x_indices = range(len(months))
ax2.bar([x - 0.2 for x in x_indices], sales_a, width=0.4, label="产品 A", color="#B96555")
ax2.bar([x + 0.2 for x in x_indices], sales_b, width=0.4, label="产品 B", color="#707780")
ax2.set_xticks(x_indices)
ax2.set_xticklabels(months)
ax2.set_title("月度销售柱状对比")
ax2.legend()

# 4. 调整布局并保存
fig.tight_layout()
fig.savefig("sales_report.png", dpi=150)
plt.close(fig)
print("图表已成功保存为 sales_report.png")2. 与 Seaborn 等高级库的定位区分
很多开发者会使用 Seaborn 绘制统计图。Seaborn 在底层完全是基于 Matplotlib 编写的。Seaborn 封装了复杂的统计计算和优美的配色方案,但当需要微调坐标轴文本旋转、添加多层标尺、调整图例边框等细节排版时,最终调用的依然是 Matplotlib 返回的 Axes 对象。因此,掌握 Matplotlib 是精通 Python 数据可视化的必经之路。
五、三库协同:从原始数据到图表洞察的标准流水线
在真实项目中,NumPy、Pandas 与 Matplotlib 绝非孤立存在,而是构成一条严密协同的流水线:
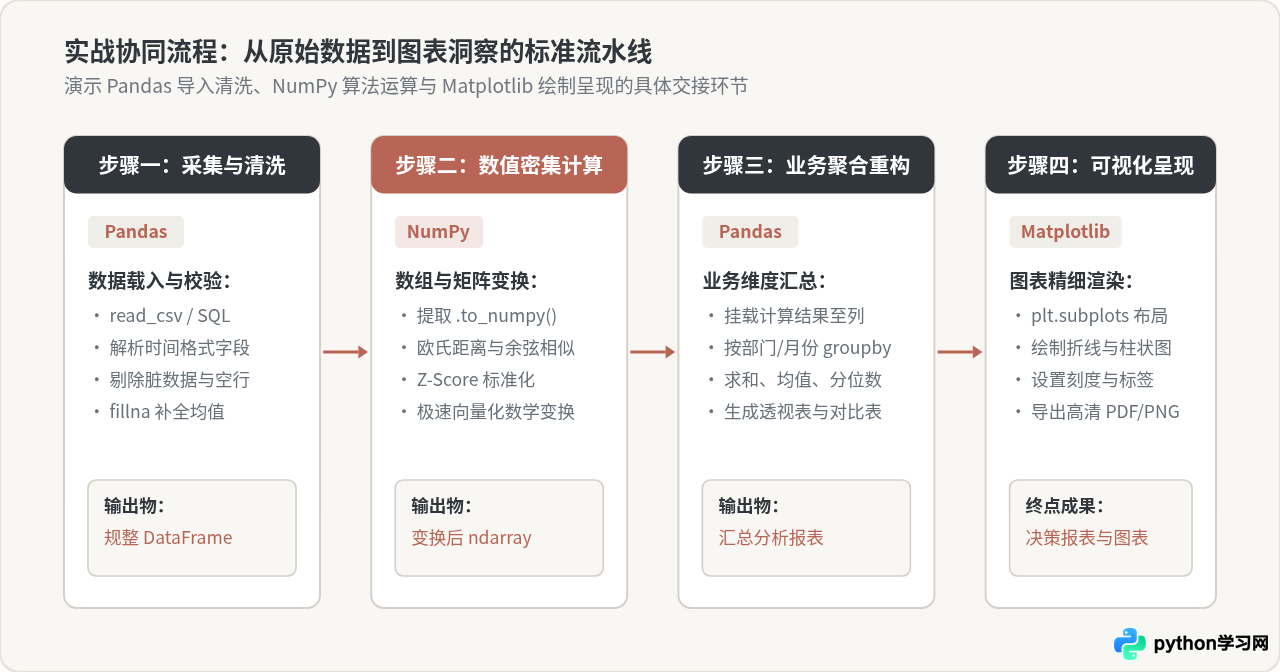
流水线的四个标准阶段分工明确:
- 输入解析(Pandas 挂帅):读取杂乱的数据源,将文本、日期、浮点数归类为结构化 DataFrame,执行异常值过滤和缺失值清洗。
- 数值算法加速(NumPy 介入):当涉及矩阵乘法、批量余弦相似度计算或统计标准化时,通过
df.to_numpy()将纯数值列转为紧凑的ndarray极速计算。 - 聚合重构(Pandas 回归):将计算后的指标附加回表格,按商业维度(如渠道、省份、时间跨度)进行
groupby或pivot_table,生成精简的决策报表。 - 洞察可视化(Matplotlib 呈现):将整理好的报表字段传入 Matplotlib,定制坐标轴、配色、标注重点,生成可读的交付报告。
六、生态扩展:除了“三剑客”,还有哪些常用分析库?
掌握了三大基石之后,根据具体业务方向,通常还会用到以下常用分析库:
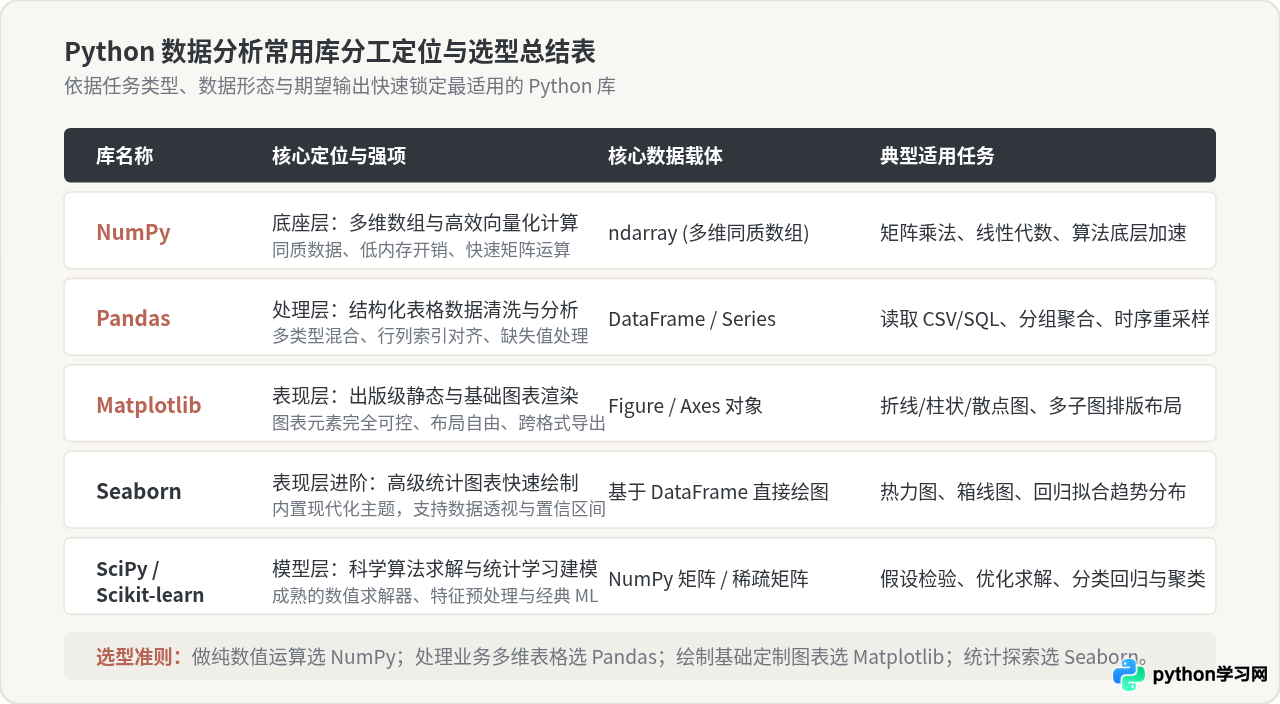
| 库名称 | 主要功能 | 与三大基石的关系 |
|---|---|---|
| Seaborn | 专注于统计分布、回归拟合和热力图等高级统计制图。 | 深度依赖 Matplotlib 渲染,同时天然支持 Pandas DataFrame 作为直接输入。 |
| SciPy | 科学计算扩展包,提供数值积分、非线性方程求解、信号滤波与假设检验。 | 基于 NumPy 数组开发,是高级科学计算与工程算法的官方基底。 |
| Scikit-learn | 经典机器学习库,涵盖分类、回归、聚类、降维与特征预处理。 | 核心算法输入与输出均标准对接 NumPy ndarray 与 Pandas 表格。 |
| Statsmodels | 计量经济学与严谨统计建模,提供 OLS 回归公式和详细的假设检验报告。 | 底层计算依赖 NumPy 与 SciPy,支持使用类似 R 语言的公式接口分析 Pandas 数据。 |
七、实战避坑与常见认知误区
在日常使用中,初学者常常因为不了解底层原理而踩坑,以下三点尤其需要注意:
1. 避免在 DataFrame / ndarray 上使用原生 for 循环
很多初学者习惯用 for index, row in df.iterrows(): 逐行遍历计算。iterrows() 会在每一次迭代中把行转换成临时的 Series 对象,开销极大。正确的做法是始终使用向量化表达式(如 df['C'] = df['A'] + df['B']),或者对于复杂的自定义多列逻辑,使用 np.vectorize 或内置矢量算子,运行速度通常有几十到上百倍的提升。
2. 正确理解与消除 SettingWithCopyWarning 警告
在 Pandas 中对过滤切片进行赋值时,经常会弹出该警告:
# 错误示例:链式索引赋值(无法确定操作的是原表视图还是临时拷贝)
# df[df["城市"] == "北京"]["状态"] = "已核验"  # 会触发 SettingWithCopyWarning

# 推荐写法 1:使用 .loc 单一表达式定位
df.loc[df["城市"] == "北京", "状态"] = "已核验"

# 推荐写法 2:如果需要独立子表,显式进行深度拷贝
sub_df = df[df["城市"] == "北京"].copy()
sub_df["状态"] = "已核验"
3. 在服务或循环绘图时显式管理 Matplotlib 资源
在批量生成多张图表时,如果只调用 plt.plot() 而没有关闭画布,已绘制的图形对象会一直驻留在内存中,不仅会导致后续绘图出现重叠线条,还会引发内存泄漏。建议使用面向对象方式,并在保存完毕后立即调用 plt.close(fig) 释放内存。
八、总结
在 Python 数据分析的工作流中,NumPy 决定计算的极限与精度,Pandas 决定业务数据的整理效率,Matplotlib 决定结论的呈现质量。理解它们的底层内存特征与分工边界,能够在实际开发中写出既高效又优雅的数据分析代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















