


Python高效读取大体积txt文件避免内存溢出
详细解析Python在读取GB乃至更大体积txt文本文件时的内存机制,通过原生行迭代器、定长分块切分、生成器流式管道与mmap内存映射等实用方案,彻底避免内存溢出(OOM)。
处理几GB乃至数十GB的大体积txt文本时,很多初学者最容易遇到的错误就是 MemoryError。这种内存溢出的根源并不在于Python本身的性能瓶颈,而在于调用了错误的数据加载方式。直接使用 read() 或 readlines() 会强行将整个文件一次性载入物理内存,而在Python对象体系中,字符串与列表封装还会带来额外的存储放大效应。解决大文件读取的核心设计原则只有一条:用时间换空间,将线性递增的内存开销压缩为恒定的常数级缓冲。借助Python原生文件迭代器、定长分块切分、生成器管道以及内存映射等机制,我们可以在仅消耗数兆字节内存的前提下,平稳高效地处理任意尺寸的文本文件。
一、为什么常规读取方法会引发内存溢出
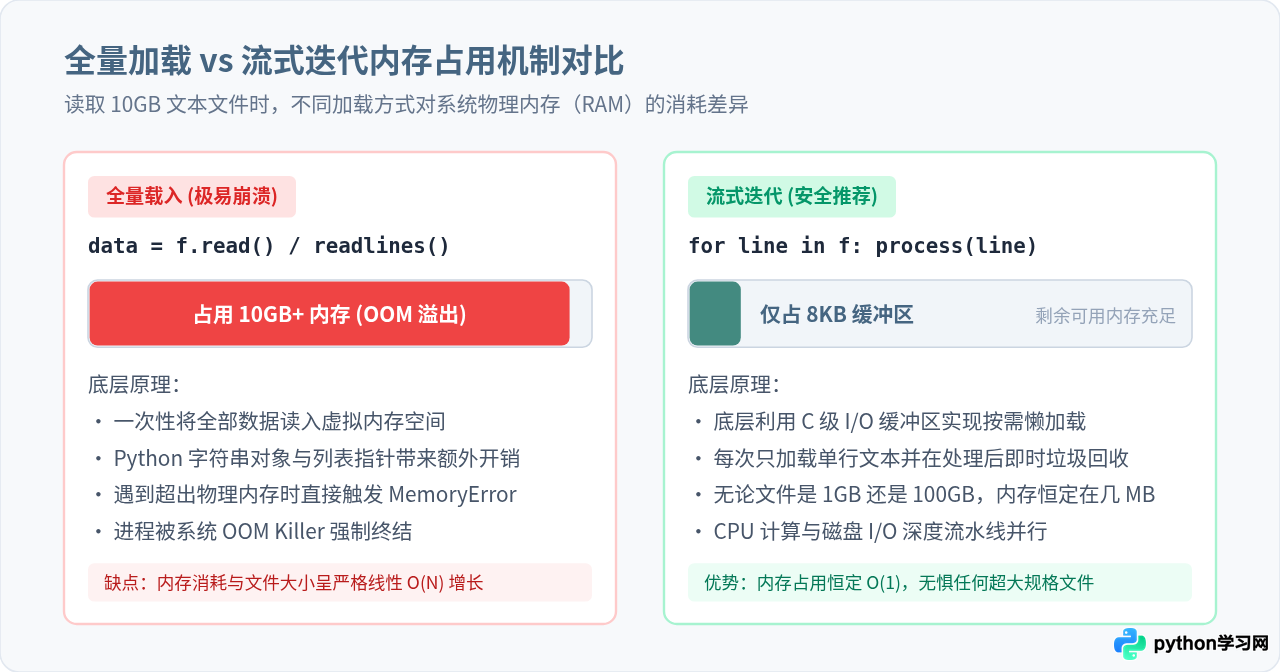
在编写读取文件的脚本时,f.read() 和 f.readlines() 是最先接触到的两个内置API。在文件体积只有几十兆字节时,这种方式直观且快捷,但在工业级生产场景中,大体积日志文件、导出数据或语料库动辄达到10GB以上,这两种方式会迅速成为崩溃源头:
f.read()的全量载入:试图在虚拟内存中开辟一段连续的地址空间,存放整个文件的全部文本字符。当系统剩余可用RAM不足以支撑目标尺寸时,操作系统将直接抛出内存分配失败异常。f.readlines()的对象膨胀:除了读取全部字符串外,还会将其按行拆分成一个庞大的list列表。在64位Python解释器中,每个列表指针和字符串元数据都需要独立的堆内存开销,往往会导致内存占用达到原文件体积的2到3倍以上。
二、首选基础方案:利用文件对象原生行迭代器
在Python中,open() 返回的文件对象本身就是一个可迭代对象(Iterable)。通过 for line in file_object 进行遍历,是处理常规行式文本最简洁、最高效且最标准的方式。
其内部底层由C语言实现的I/O缓冲机制驱动。操作系统每次从磁盘读取一个数据块(默认通常为8KB)到缓冲区,Python解释器在内部寻找换行符并生成一条字符串给循环体。在当前行处理完成后,上一行的局部引用失效,内存立即被垃圾回收机制标记或复用,从而实现常数级 $O(1)$ 的内存占用。
def process_large_file(file_path: str):
    """
    使用原生文件迭代器流式逐行统计关键词
    """
    match_count = 0
    # 使用 with 确保文件句柄一定被正确关闭
    # 显式声明 encoding 与错误处理策略,防止个别异常编码字节中断长任务
    with open(file_path, mode="r", encoding="utf-8", errors="replace") as f:
        for line in f:
            # 移除行尾换行符,避免污染比对逻辑
            clean_line = line.rstrip("\r\n")
            if "ERROR_404" in clean_line:
                match_count += 1

return match_counterrors="replace":在GB级别文本中,经常混入个别坏字节。若使用默认的严格解码,程序会在几小时的处理后因某个字符突然崩溃。设置replace可以将坏字节替换为?,保障主流程的平稳推进。line.rstrip("\r\n"):行迭代器返回的字符串保留了原始换行符,使用rstrip清理不仅能防止逻辑错误,还能略微缩减后续处理对象的长度。
三、标准生产流水线:四步实现稳健数据流
在实际生产环境中,大文件读取往往伴随着数据清洗、结构化解析与结果落盘。为了避免出现“虽然按行读取了,但把所有提取结果全装进一个大列表导致内存再次溢出”的情况,必须严格遵循流式四步流水线规范。
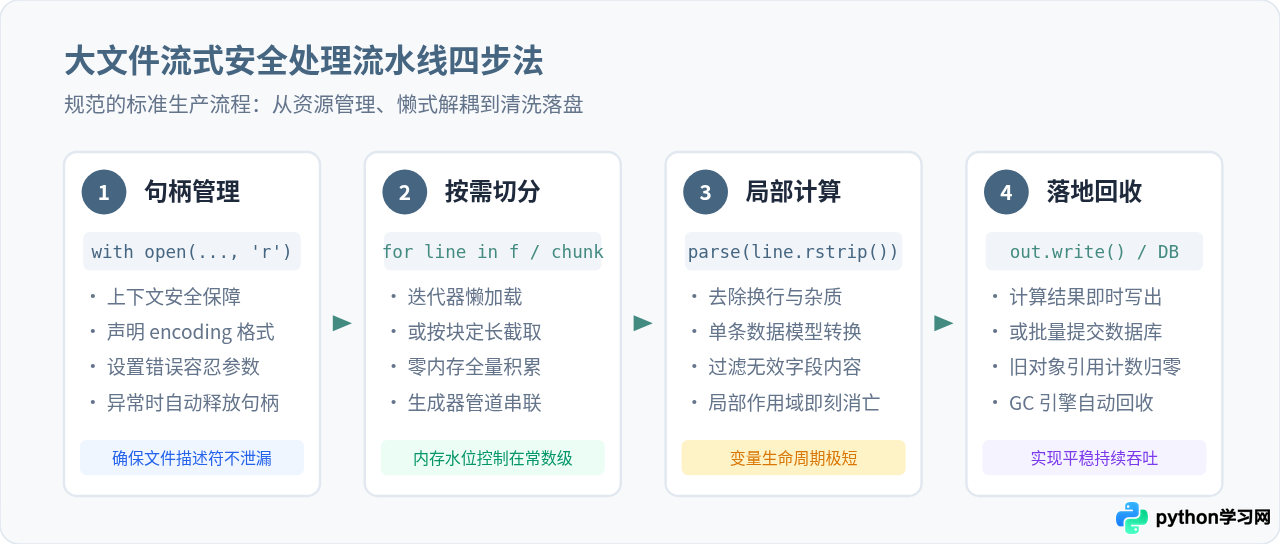
利用生成器(Generator)解耦复杂解析
如果每行数据需要经过多阶段清洗与转换,将逻辑全部堆在单个 for 循环内会导致代码极其臃肿。通过 yield 关键字封装生成器,能够优雅地将读取与业务解耦,同时完全保留懒加载特性:
from typing import Generator, Dict, Any

def read_and_filter_logs(file_path: str) -> Generator[Dict[str, Any], None, None]:
    """
    第一级流水线:按行流式过滤并产出结构化字段
    """
    with open(file_path, mode="r", encoding="utf-8", errors="replace") as f:
        for line in f:
            line_str = line.strip()
            if not line_str or line_str.startswith("#"):
                continue  # 跳过注释与空行
            parts = line_str.split("|")
            if len(parts) >= 3:
                yield {
                    "timestamp": parts[0],
                    "level": parts[1],
                    "message": parts[2]
                }

def run_pipeline(source_file: str, target_file: str):
    """
    第二级流水线:消费生成器并实时输出,内存占用恒定
    """
    log_stream = read_and_filter_logs(source_file)
    with open(target_file, mode="w", encoding="utf-8") as out_f:
        for record in log_stream:
            if record["level"] == "FATAL":
                out_f.write(f"{record['timestamp']} - {record['message']}\n")
批量分批处理:itertools.islice
如果业务下游需要将数据批量写入数据库(例如每次批量 insert 1000条),单行操作的数据库网络开销过大。此时可以使用标准库的 itertools.islice 对迭代器进行受控切片:
from itertools import islice

def process_in_batches(file_path: str, batch_size: int = 1000):
    """
    兼顾 I/O 吞吐与内存上限的分批处理方案
    """
    with open(file_path, "r", encoding="utf-8") as f:
        while True:
            # 每次仅切片取出 batch_size 行,构建一个局部轻量列表
            lines_chunk = list(islice(f, batch_size))
            if not lines_chunk:
                break

            # 模拟批量落库或集中批处理
            # 每次处理完毕,lines_chunk 被下一批替换,上一批自动被释放
            execute_batch_insert(lines_chunk)
四、进阶场景:超长单行分块与 mmap 内存映射
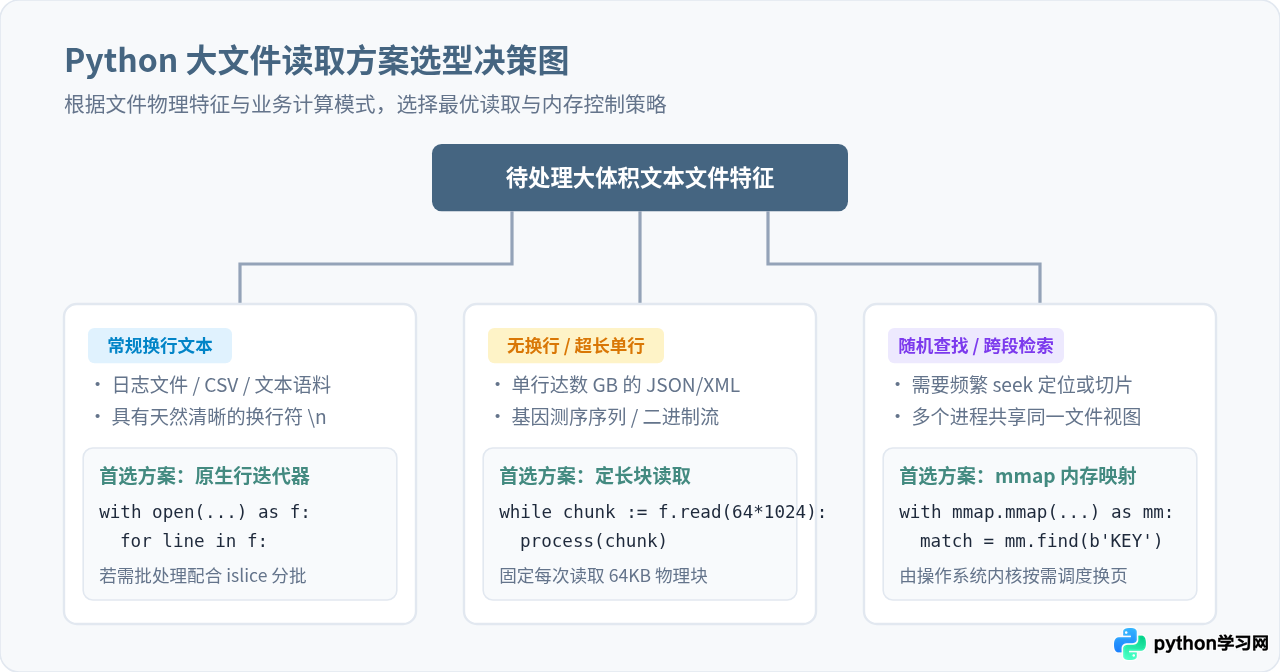
并不是所有大体积文本都具备规整的换行符。面对复杂非标准文件时,需要根据实际特征选择针对性的读取技术。
1. 针对超长无换行文件的定长块读取
如果待读取的文件是未经格式化的一整行超大JSON、XML或基因序列,单行大小就可能高达几GB,此时 for line in f 会因为一直找不到 \n 而持续加载,最终同样引发内存溢出。此时必须使用显式指定字节大小的定长分块机制:
def read_in_chunks(file_path: str, chunk_size: int = 65536):
    """
    每次严格只读 64KB 字符,彻底免疫无换行单行超大文件
    """
    with open(file_path, "r", encoding="utf-8", errors="replace") as f:
        # 使用 Python 3.8+ 海象运算符精简读取结构
        while chunk := f.read(chunk_size):
            yield chunk

# 或者使用更函数式的方式构造生成器
from functools import partial

def read_chunks_func(file_path: str, chunk_size: int = 65536):
    with open(file_path, "r", encoding="utf-8") as f:
        for chunk in iter(partial(f.read, chunk_size), ""):
            yield chunk
2. 针对频繁检索与随机读取的 mmap 模块
如果需要在超大文本文件中搜索某个关键词的偏移位置,或者需要频繁跳跃读取(例如二分查找),常规的逐行遍历速度过慢。Python内置的 mmap 模块可以将文件内容直接映射到进程的虚拟地址空间:
import mmap

def search_with_mmap(file_path: str, target_bytes: bytes) -> int:
    """
    借助操作系统内核的分页缓存实现毫秒级快速匹配
    """
    with open(file_path, "r+b") as f:
        # 创建一个只读的内存映射对象
        with mmap.mmap(f.fileno(), length=0, access=mmap.ACCESS_READ) as mm:
            # 可以在像操作大 bytearray 一样进行切片和 find
            position = mm.find(target_bytes)
            if position != -1:
                # 定位到匹配行起始
                mm.seek(position)
                sample = mm.readline()
                print(f"找到目标内容,偏移位置: {position}, 样本: {sample}")
return position原理解析:mmap 并没有把整个文件读入物理RAM,而是依靠操作系统的“缺页中断”机制按需加载对应的物理磁盘页(Page)。当不需要某部分数据时,内核会自动将其换出内存,因此在几十GB文件的全局搜索中表现非常优异。
五、核心设计准则与避坑指南
掌握了上述技术手段后,在工程编写中还需避开几类隐蔽的内存泄漏陷阱:
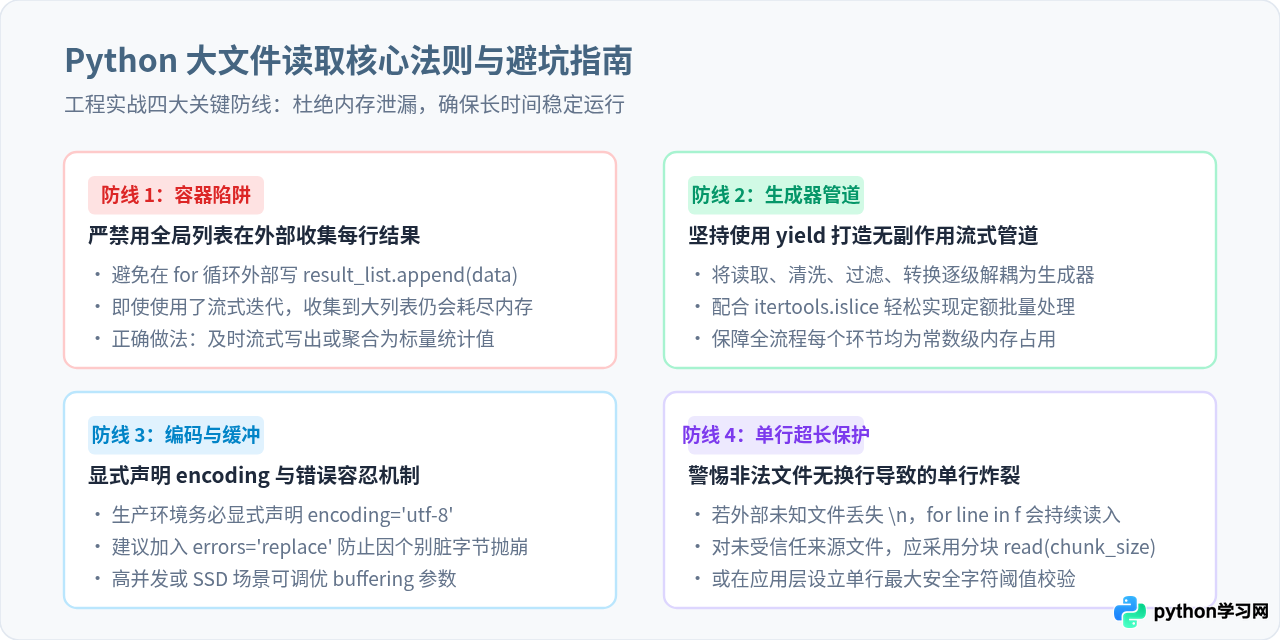
初学者常犯的一种错误是在行迭代器外部包裹容器,例如写出 all_lines = [line.strip() for line in f]。这样虽然形式上写成了单行,但本质上是立即强制生成一个包含数千万项的完整列表,完全丧失了迭代器的懒加载优势,依旧会在瞬间耗尽系统物理内存。正确的理念始终是:消费一行、处理一行、释放一行。
六、方案对照与选择指南
为了在实际项目中快速决断,下表总结了各常见方案的核心指标:
for line in f:内存占用 $O(1)$,代码难度最低,适用绝大多数带正常换行的日志、CSV 与纯文本。f.read(chunk_size):内存严格受限于chunk_size,适用非结构化、无换行、单行极长或任意二进制衍生文件。itertools.islice:内存占用可控(单批次开销),适用需要将大文件分批导入数据库或远程 RPC 消费的批处理系统。mmap内存映射:内存由内核虚拟内存自动换页调度,适用需要对多GB文件执行频繁快速定位、跨段搜索或多进程共享读取。
掌握以上这套组合拳后,无论面对几十兆的日常文件还是上百GB的超大文本集合,Python脚本都能在几十兆内存的受限容器内稳健运行,彻底告别 MemoryError 的困扰。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















