


Python调用DeepL API实现高精度文本翻译
使用 Python 调用官方 DeepL API 进行高精度文本翻译的完整实践教程,包含密钥配置、单文本与批量翻译、术语表控制、格式保护及生产环境健壮性设计。
在自动化多语言内容生产、文档本地化和跨语言信息检索场景中,机器翻译的语法自然度与语境准确性直接决定了业务可用性。基于深度神经网络的 DeepL 在语义保留和长句结构解析上具备显著优势。使用 Python 官方 SDK(deepl),开发者只需数行代码即可建立标准翻译调用。本文将从认证准备、接口初始化、单文本与批量翻译、高级定制(术语表与格式保留),到生产级异常重试与额度管控进行完整讲解,帮助读者构建健壮的翻译管道。
一、准备工作与账户密钥区分
在调用 API 之前,需要先在 DeepL 开发者控制台完成账号注册并获取身份验证密钥(Authentication Key)。DeepL 将开发者计划划分为免费版(DeepL API Free)与付费版(DeepL API Pro)。这一区分直接关系到 API 的请求地址与密钥格式。
免费版提供每月 50 万字符的调用额度,其密钥具有一个显著的特征:字符串结尾固定包含 :fx 标识(例如 3b1c8e...:fx)。付费版密钥则不含此后缀。官方 Python SDK 在底层会自动依据密钥是否带有 :fx 后缀,自动将流量路由到正确的服务端点:免费版对应 api-free.deepl.com,专业版对应 api.deepl.com。
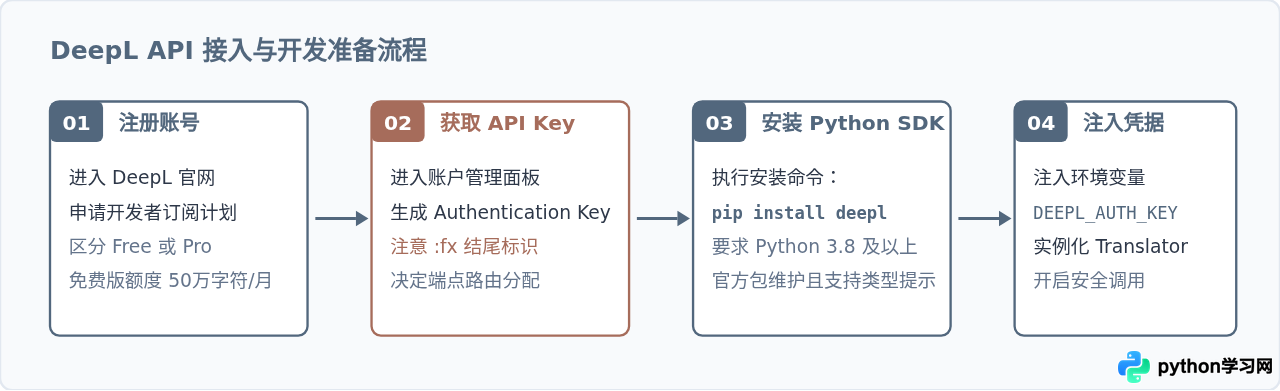
安装官方 SDK 非常直接,在本地终端执行如下命令即可:
pip install --upgrade deepl为了避免将敏感密钥硬编码进业务代码或提交至版本控制系统,推荐将其注入环境变量。在终端中可按如下方式配置:
# Linux / macOS
export DEEPL_AUTH_KEY="your-api-key-here"

# Windows PowerShell
$env:DEEPL_AUTH_KEY="your-api-key-here"
二、核心翻译接口调用实现
SDK 的主要交互入口是 deepl.Translator 类。在实例化时传入密钥,随后便可调用 translate_text 方法。
1. 目标语言与语言代码约定
调用 DeepL 接口时,源语言(source_lang)是可选参数。如果省略,服务端算法会自动检测文本输入语言。而目标语言(target_lang)则是必填项。需要注意的是,DeepL 对目标语言代码有规范要求:
- 中文(简体):指定为
"ZH"或"ZH-HANS"。 - 英语:作为目标语言时必须区分地区变体,例如
"EN-US"(美式英语)或"EN-GB"(英式英语);作为源语言时可直接写"EN"。 - 其他主流语种:如德语
"DE"、法语"FR"、日语"JA"、西班牙语"ES"。
2. 单文本翻译与结果解析
以下代码演示从环境变量读取密钥、初始化客户端,并将一段英文文本翻译为中文:
import os
import deepl

# 从环境变量获取 API Key
auth_key = os.getenv("DEEPL_AUTH_KEY")
if not auth_key:
    raise ValueError("未检测到 DEEPL_AUTH_KEY 环境变量,请先配置密钥。")

# 初始化客户端(自动根据密钥格式适配端点)
translator = deepl.Translator(auth_key)

# 待翻译英文内容
source_text = "Microservices architecture enables organizations to deliver large, complex applications rapidly and reliably."

# 执行翻译
result = translator.translate_text(
    source_text,
    target_lang="ZH"
)

# 输出结果与元数据
print("译文内容:", result.text)
print("检测到的源语言:", result.detected_source_lang)
运行后得到的输出示例:
[示例输出]
译文内容: 微服务架构使组织能够快速、可靠地交付大型复杂应用。
检测到的源语言: EN
3. 批量文本翻译降低网络开销
当有成批的段落、表格单元格或列表条目需要翻译时,如果逐行发起网络请求,会产生严重的 HTTP 往返延迟。translate_text 方法的原生入参支持直接传入字符串列表(List[str]),SDK 会将其打包在同一个请求载荷中发送:
texts_to_translate = [
    "High availability is essential for cloud infrastructure.",
    "Latency can be mitigated by distributed edge caching.",
    "Data integrity should be enforced through ACID transactions."
]

# 批量传入列表
results = translator.translate_text(texts_to_translate, target_lang="ZH")

for idx, item in enumerate(results, start=1):
    print(f"[{idx}] {item.text}")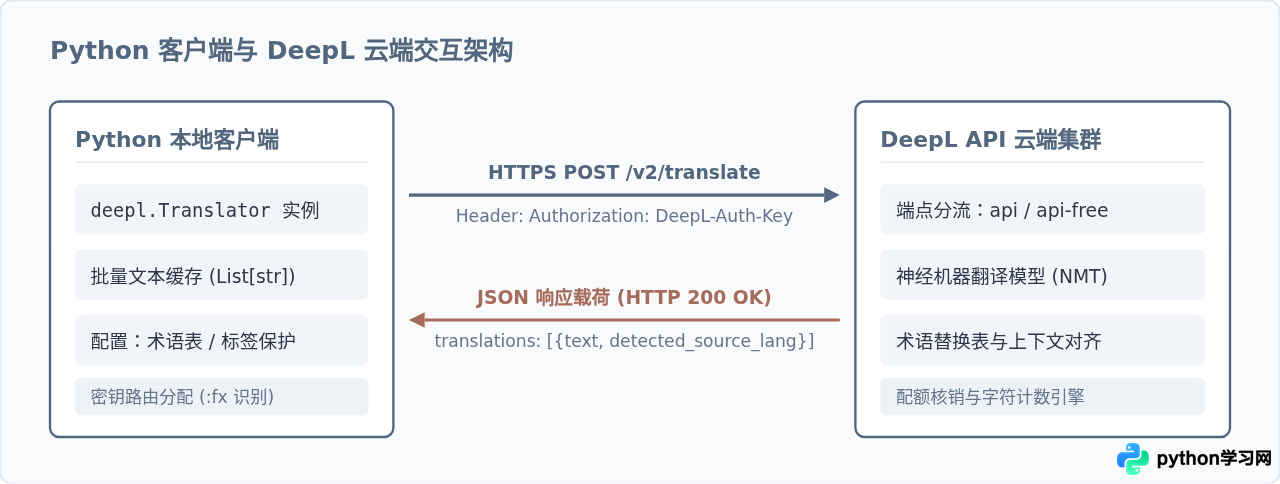
三、高级特性与精细化控制
在实际项目落地中,通用翻译往往无法满足专业场景的严苛要求。例如行业专业名词不能被字面直译、HTML 标记结构不能被破坏、不同场景需要控制敬语语气。DeepL API 提供了专门的参数来满足这些精细控制需求。
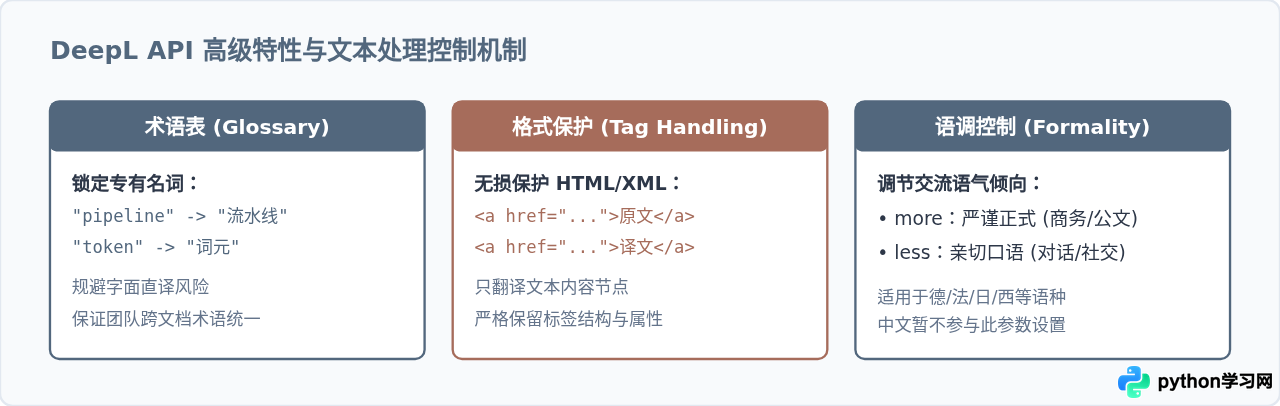
1. 术语表(Glossary)保障专有名词统一
在技术、金融或医药翻译中,品牌名或专业名词如果被拆词直译会导致严重错误。DeepL 允许创建词对术语表并绑定到翻译任务中。创建术语表需要同时指定源语言和目标语言:
# 创建双语术语表词条映射
entries = {
    "pipeline": "流水线",
    "prompt": "提示词",
    "token": "词元",
    "Transformer": "Transformer"  # 保持专有名词不翻译
}

# 提交术语表到云端
my_glossary = translator.create_glossary(
    name="ai_engineering_glossary",
    source_lang="EN",
    target_lang="ZH",
    entries=entries
)

# 使用术语表执行翻译
specialized_text = "The training pipeline processes each prompt and breaks it into tokens."
result = translator.translate_text(
    specialized_text,
    target_lang="ZH",
    glossary=my_glossary  # 传入术语表对象或术语表 ID
)

print(result.text)
绑定术语表后,“pipeline”将严格锁定为“流水线”,而不会被随机翻译为“管道”,从而确保系列技术文档术语的一致性。
2. 格式与排版保护(Tag Handling)
如果直接将带有 HTML 或 XML 标签的富文本发送给通用翻译,模型常常会把 class 属性、标签闭合符破坏,或者漏掉闭合标签。DeepL 支持指定 tag_handling="html" 或 tag_handling="xml",此时翻译引擎会只翻译标签内的文字内容,并完整保留标签层级与属性:
html_content = '<p class="summary">Click <a href="https://example.com">here</a> for details.</p>'

result = translator.translate_text(
    html_content,
    target_lang="ZH",
    tag_handling="html"
)

print(result.text)
# 输出: <p class="summary">点击<a href="https://example.com">此处</a>了解详情。</p>
3. 语调与敬语倾向(Formality)
对于支持敬语或正式语调的目标语言(如德语、法语、日语、意大利语等),可以通过 formality 参数指定语气倾向:
formality="more":更正式、严谨的语气,适用于商业合同、公文、技术白皮书。formality="less":更亲切、随意的语气,适用于社交媒体、即时通讯或口语对话。
formality 参数,否则可能引发参数不兼容异常。
四、生产级健壮性:额度监控与异常重试体系
在无人值守的生产服务中,直接使用裸调用是危险的。网络波动、字符额度耗尽、无效密钥都可能引发未捕获异常导致进程崩溃。因此,建立完善的用量监测与异常防护体系是落地 DeepL API 的必要环节。
1. 实时额度与用量监控
可以通过 get_usage() 实时获取当前账户的字符使用情况,常用于在批量翻译任务执行前进行断言检查,避免任务进行到中途因额度不足而失败:
usage = translator.get_usage()

if usage.character.valid:
    print(f"当前已用字符数: {usage.character.count}")
    print(f"字符总额度上限: {usage.character.limit}")

    # 计算剩余额度百分比
    remaining = usage.character.limit - usage.character.count
    percent = (usage.character.count / usage.character.limit) * 100
    print(f"额度使用率: {percent:.2f}% (剩余 {remaining} 字符)")

    if usage.character.limit_exceeded:
        print("警告: 字符配额已耗尽,请及时扩容或充值!")
2. 细分异常捕获与指数退避重试
DeepL SDK 提供了明确的异常继承结构。根据不同的异常类型,程序应采取不同的补救措施:
deepl.QuotaExceededException:字符额度用尽。此时重试毫无意义,应触发告警并停止后续调用,或降级走备用翻译通道。deepl.AuthorizationException:密钥错误或被吊销。属于不可恢复配置错误,应直接报错中止。deepl.ConnectionException:网络超时、DNS 无法解析或服务端短时抖动。属于瞬态错误,应采用指数退避(Exponential Backoff)算法进行有限次重试。deepl.DeepLException:其他通用异常兜底。
下面是一个具备防御性设计的生产级翻译包装函数:
import time
import logging
from typing import Optional, List, Union
import deepl

logger = logging.getLogger("TranslatorService")

def safe_translate_with_retry(
    translator: deepl.Translator,
    text: Union[str, List[str]],
    target_lang: str = "ZH",
    max_retries: int = 3,
    initial_delay: float = 1.0,
    **kwargs
) -> Optional[Union[str, List[str]]]:
    """
    具备重试和异常防御机制的安全翻译调用函数
    """
    delay = initial_delay

    for attempt in range(1, max_retries + 1):
        try:
            response = translator.translate_text(text, target_lang=target_lang, **kwargs)
            if isinstance(response, list):
                return [r.text for r in response]
            return response.text

        except deepl.QuotaExceededException:
            logger.critical("DeepL 账户字符配额已彻底耗尽,无法继续执行任务!")
            raise  # 严重配额问题立即向上抛出报警

        except deepl.AuthorizationException as auth_err:
            logger.critical(f"身份认证失败,请检查密钥是否有效: {auth_err}")
            raise

        except deepl.ConnectionException as conn_err:
            logger.warning(f"第 {attempt} 次请求遭遇网络波动: {conn_err}")
            if attempt == max_retries:
                logger.error("超过最大重试次数,网络恢复失败。")
                raise
            time.sleep(delay)
            delay *= 2  # 指数退避递增等待时间

        except deepl.DeepLException as deep_err:
            logger.error(f"DeepL 服务返回未预期异常: {deep_err}")
            raise

    return None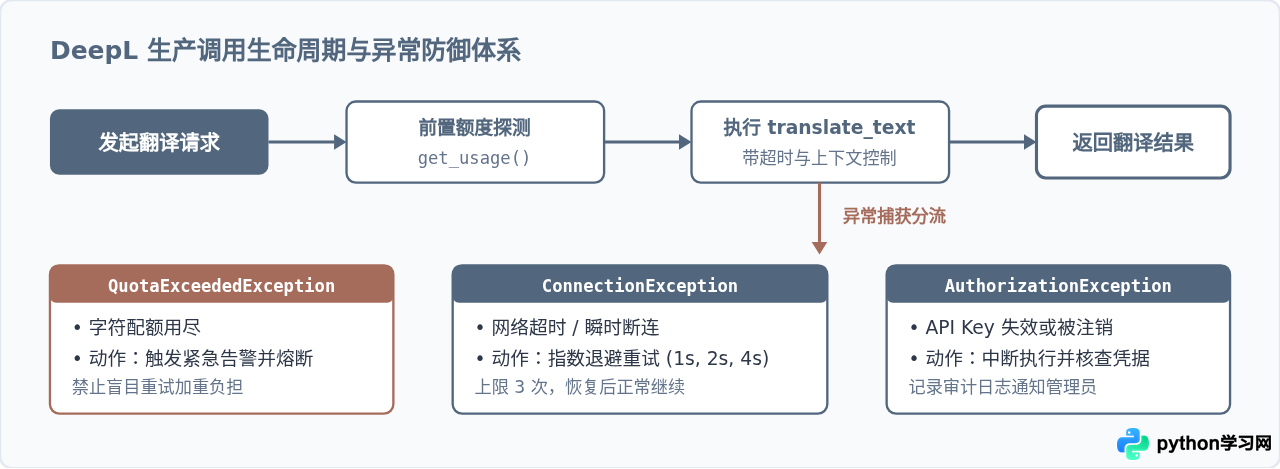
五、工程实践优化与避坑要点
在规模化使用 DeepL API 的过程中,以下几条来自实际工程经验的建议能有效降低成本并提升系统吞吐量:
- 计费字符认知:DeepL 按请求中发送的实际 UTF-8 字符数计费,包括空格、标点符号。使用
tag_handling="xml"时,标签名称和属性本身不会扣除翻译额度,只有标签内的实际文本才计费。合理精简传输内容有助于节约开支。 - 本地多级缓存机制:在 UI 国际化或固定问答语料库场景下,许多语句的重复率极高。建议在 Python 客户端前置一层基于 Redis 或 SQLite 的键值缓存(以
hash(source_lang + target_lang + text)作为键)。命中缓存直接返回,未命中再发起 API 调用。 - 避免高并发单字请求:如果使用异步协程或多线程,不要并发向 API 发送海量单个短词请求。应优先在客户端将短语按 50 至 100 条归整为一个数组列表,再使用一次
translate_text批量下发。
通过理解密钥后缀路由规则、善用官方 SDK 的高级入参,以及补齐生产环境的重试和用量检测逻辑,开发者即可在 Python 项目中无缝串联起高精度、工业级稳定的机器翻译基础设施。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















