


Python re模块常用方法详解:match、search与findall的区别
深入解析Python标准库re模块中match、search与findall三大核心方法的匹配机制、返回值类型、分组捕获行为及工程选型指南。
在 Python 正则表达式处理中,re.match、re.search 与 re.findall 是使用频次最高的三大基础检索函数。很多初学者在编写模式匹配时常会遇到困惑:为什么包含匹配内容的字符串用 match 会返回 None?为什么用 findall 提取内容时拿到的不是整串文本而是元组?要准确掌握它们,核心在于理解三者在“检索起始位置”、“扫描范围”与“返回值组织形态”上的设计差异。
一、核心机制与特性全景对比
re 模块对这三个方法的定义各有侧重。为了直观展现差异,我们可以通过下方的特性架构图快速建立整体认识:
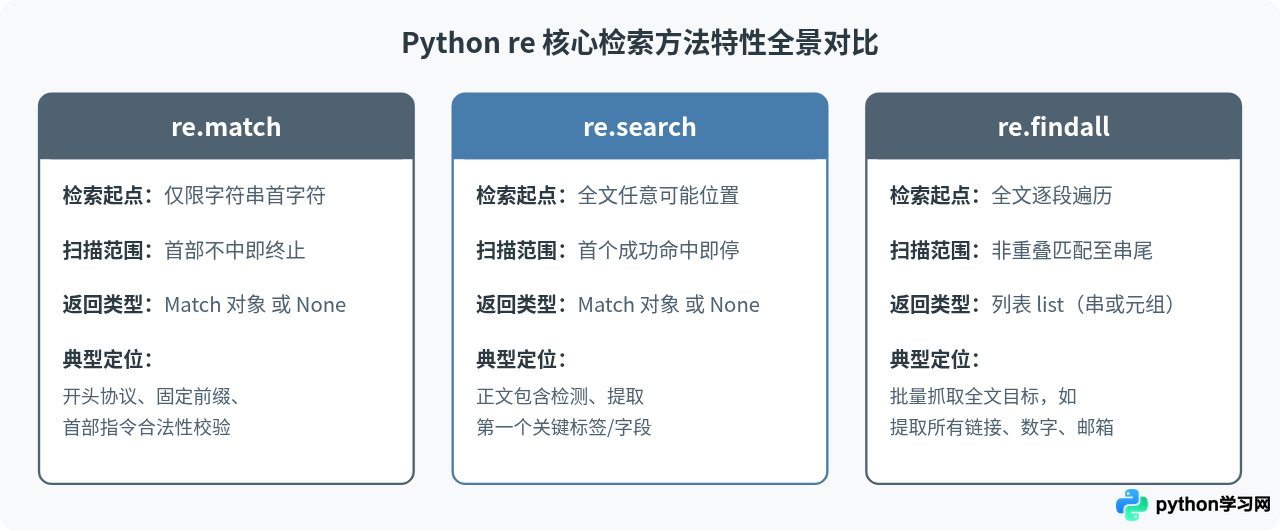
| 方法名 | 匹配起点要求 | 扫描结束条件 | 未匹配时返回值 | 分组捕获时的行为 |
|---|---|---|---|---|
re.match |
必须从字符串开头(索引 0)匹配 | 开头匹配完成或开头失败即停 | None |
返回包含分组信息的 Match 对象 |
re.search |
从字符串任意位置开始 | 找到第一个符合条件的子串即停 | None |
返回包含分组信息的 Match 对象 |
re.findall |
从字符串任意位置开始扫描 | 扫描完全部文本,返回所有非重叠结果 | 空列表 [] |
受分组控制,返回分组字符串或元组列表 |
二、match 与 search 的匹配流程对比
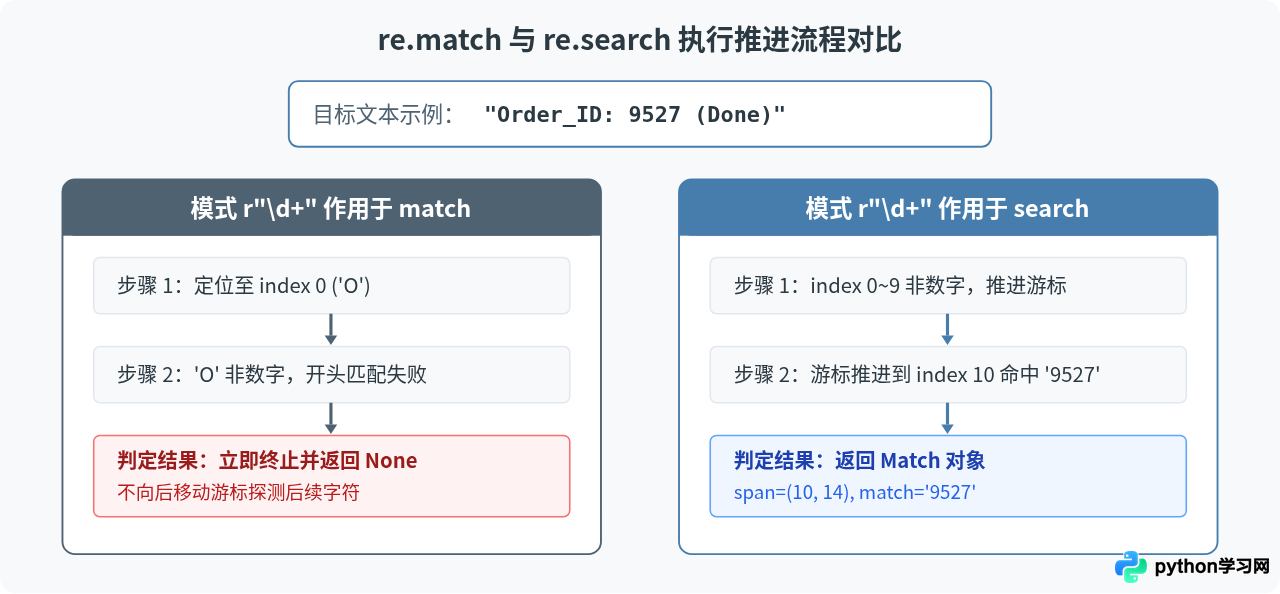
re.match 与 re.search 最显著的共同点是它们在匹配成功时都返回一个 re.Match 对象,失败时都返回 None。二者的本质区别在于游标推进机制:match 相当于自带隐式锚点 ^,只对开头生效;而 search 会在开头不匹配时自动推进指针继续探测。
示例代码与执行对比
import re

text = "Item-456: price 88 CNY, Item-789: price 99 CNY"
pattern = r"\d+"

# 1. 使用 re.match
res_match = re.match(pattern, text)
print("match 结果:", res_match)

# 2. 使用 re.search
res_search = re.search(pattern, text)
print("search 结果:", res_search.group() if res_search else None)
示例输出:
match 结果: None
search 结果: 456
在这个例子中,目标文本以字母 Item 开头,因此匹配连续数字 \d+ 的 re.match 在第 0 位即判定失败,直接返回 None;而 re.search 则向后扫描,直到发现 456 处成功命中并返回 Match 对象。
防踩坑提醒:在调用 match 或 search 后,严禁在未做判断的情况下直接使用 .group()。如果未命中返回 None,直接调用会触发 AttributeError: 'NoneType' object has no attribute 'group'。推荐使用 if match_obj: 保护语句或 walrus 操作符(if (m := re.search(...)):)。
三、re.findall 的深入机制与分组行为
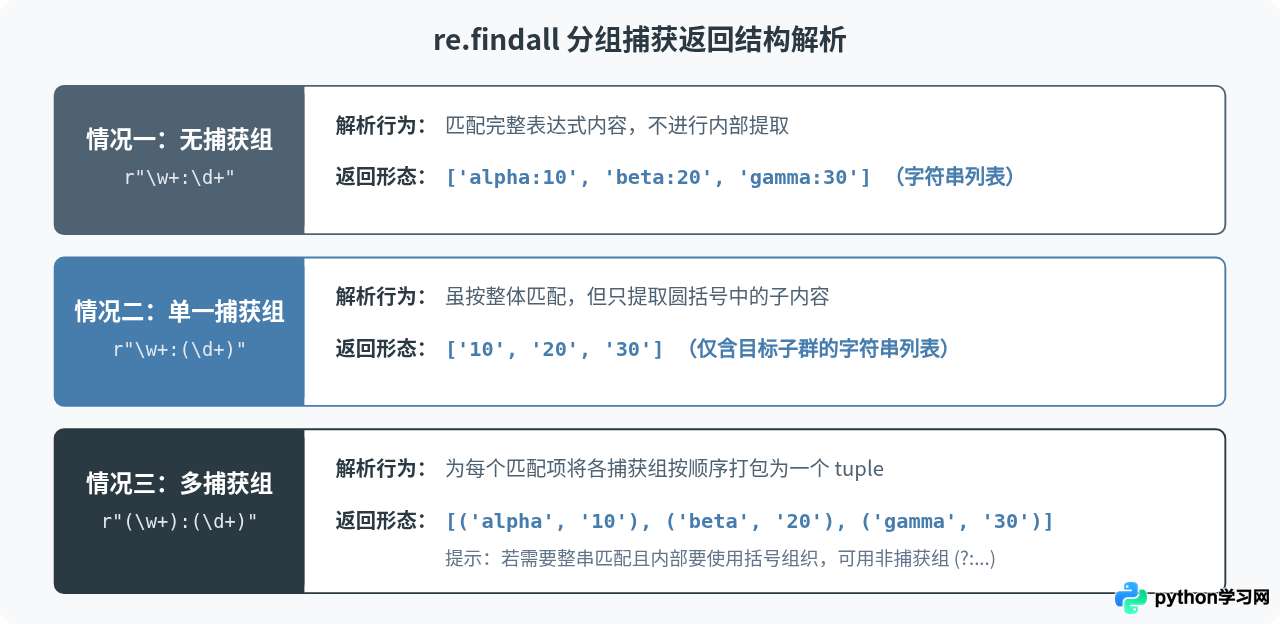
与 match 和 search 只获取单个匹配项不同,re.findall 会遍历整个字符串并提取所有非重叠的匹配内容。更重要的是,re.findall 的返回值形态完全取决于正则表达式中是否使用了捕获分组 ()。
三种分组模式的代码演示
import re

text = "Tom:98; Jerry:85; Spike:92"

# 1. 无捕获组:返回包含完整匹配项的列表
res_all = re.findall(r"\w+:\d+", text)
print("无分组:", res_all)

# 2. 单个捕获组:只提取括号内的数据
res_single_group = re.findall(r"\w+:(\d+)", text)
print("单分组:", res_single_group)

# 3. 多个捕获组:将各分组组合成元组
res_multi_group = re.findall(r"(\w+):(\d+)", text)
print("多分组:", res_multi_group)

# 4. 非捕获组 (?:...):仅用于语法聚类,不改变返回结构
res_non_capture = re.findall(r"(?:\w+):(?:\d+)", text)
print("非捕获组:", res_non_capture)
示例输出:
无分组: ['Tom:98', 'Jerry:85', 'Spike:92']
单分组: ['98', '85', '92']
多分组: [('Tom', '98'), ('Jerry', '85'), ('Spike', '92')]
非捕获组: ['Tom:98', 'Jerry:85', 'Spike:92']
四、工程选型决策路径
在实际业务开发中,选择哪个方法主要取决于三个问题:匹配边界在哪里?需要单个结果还是全部结果?是否需要获取匹配项在文本中的起止偏移量?
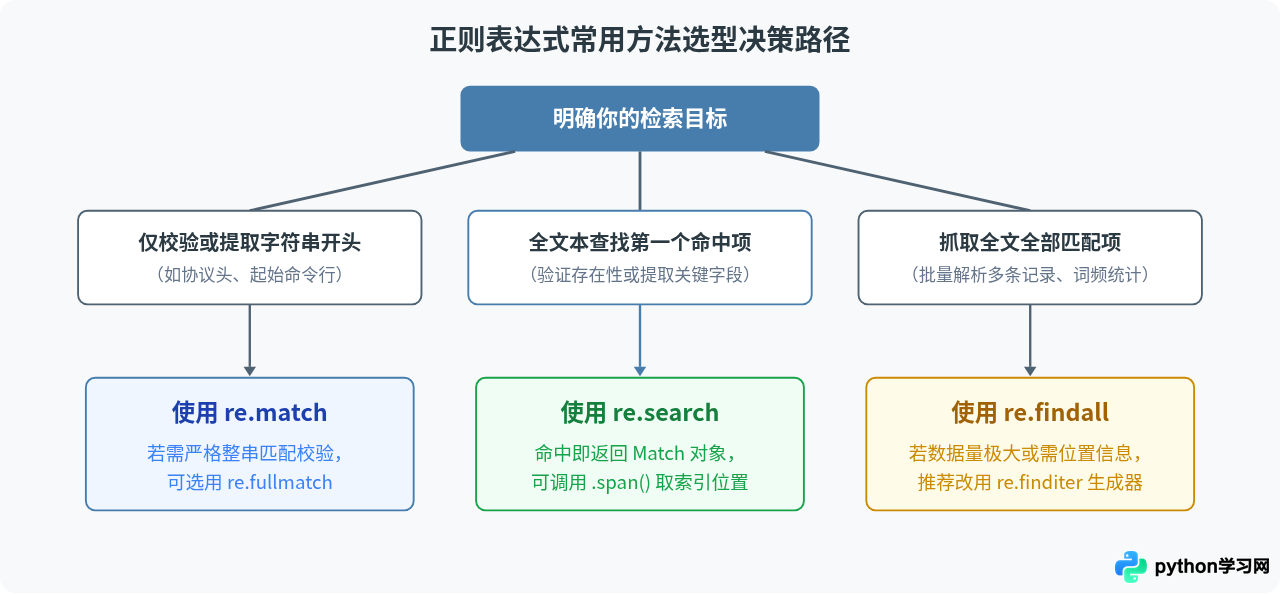
五、重要补充:大文本场景下的 re.finditer
当处理日志文件、网络爬虫正文或数兆字节的大文本时,re.findall 会一次性将所有匹配项全部加载到内存并构建一个巨大列表。这在极端情况下可能引发内存暴涨。
此时更佳的实践是使用 re.finditer。它与 findall 一样全串扫描,但返回的是一个迭代器(Iterator),每次迭代按需产出一个包含位置与分组信息的 re.Match 对象:
import re

large_text = "error: 404 at 10:00; error: 500 at 10:02; error: 502 at 10:05"

# 使用 finditer 流式处理
for match in re.finditer(r"error:\s*(\d+)", large_text):
    status_code = match.group(1)
    start_pos, end_pos = match.span()
    print(f"发现状态码: {status_code}, 出现位置: {start_pos}~{end_pos}")
示例输出:
发现状态码: 404, 出现位置: 0~10
发现状态码: 500, 出现位置: 21~31
发现状态码: 502, 出现位置: 42~52
六、总结速记
- 只查开头:选
re.match。若需要整串完全相等无多余字符,优先考虑re.fullmatch。 - 查第一个出现:选
re.search。拿到结果后务必检查是否为None再做属性调用。 - 抓取全部:选
re.findall。留心捕获组()对返回形态(字符串或元组)的影响;若只需语法分组请使用(?:...)。 - 超大文本或需要精确坐标:选
re.finditer,通过惰性求值兼顾内存效率与匹配细节。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















