


llama.cpp b12433为什么要限制AMD的MMVF偶数列条件
llama.cpp b12433将AMD相关MMVF路径限定到偶数src0列,避免奇数列触发按值对读取的断言。这个修复面向MUL_MAT_ID的特定输入类型与少量token分支,不是对全部GPU、所有LoRA或任意模型性能的统一升级。
哪些条件组合会触及这项修复
提交说明限定了设备、操作、输入类型和token数量:AMD设备上的MUL_MAT_ID,src0为F32、F16或BF16,且至多8个token。原逻辑在这一场景使用MMVF,而该路径按两个值一组读取src0,并要求ne[0]为偶数。
奇数列违反了这一读取前提。代码给出的实际例子是MoE专家权重上的rank 1 LoRA:lora_b的ne[0]等于1,因此会触发断言并中止。这里的rank 1描述LoRA权重的形状,不能被替换成“只要使用MoE或LoRA就必然出错”。
偶数条件如何保留已有回退
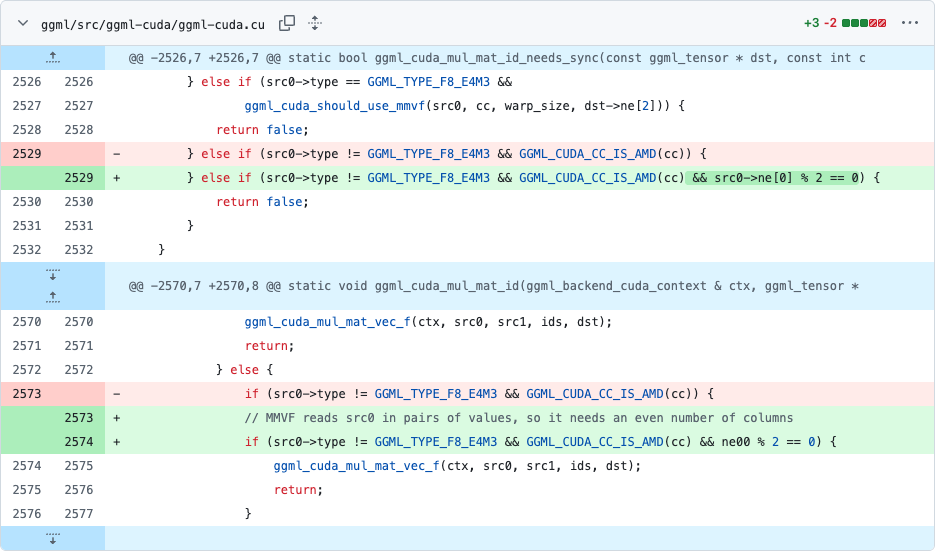
ggml/src/ggml-cuda/ggml-cuda.cu中两处判断加入了列数取模条件。一处在同步需求判断中检查src0->ne[0] % 2 == 0,另一处在实际调用MMVF前检查ne00 % 2 == 0。两处都让AMD相关分支只在列数为偶数时成立。
不满足偶数条件时,代码不再在这里调用MMVF并提前返回,而是让其他形状进入已有回退。这并不是给奇数列补零、改变LoRA rank或重写权重,也不是新建一个宣称更快的内核;改动的关键是让路径选择符合读取条件。
怎样在已有源码中定位这两类变化
以下命令适用于已经克隆llama.cpp、且本地对象库包含指定提交的Git环境。在该仓库目录运行,可同时查看实现文件和回归测试的该次提交差异;命令只读取源码,不构建GPU后端,也不下载模型或运行推理。
git show f477c1b90adb1f27e80276c0ebeed4d04812e605 -- ggml/src/ggml-cuda/ggml-cuda.cu tests/test-backend-ops.cpp预期能看到实现文件增加偶数列检查,以及tests/test-backend-ops.cpp增加奇数k、少量token的MUL_MAT_ID测试用例。本地缺少该提交时,Git可能提示无法解析对象;这表示源码对象尚不齐全,不能据此认定修复逻辑或GPU运行结果异常。
新增测试覆盖什么,不能推出什么
测试差异注释明确提到少量token下的奇数k,例如专家权重rank 1 LoRA的lora_b。新增用例遍历n为1和2,并为MUL_MAT_ID构造相应输入。它为这类形状增加回归覆盖,和“所有模型、所有LoRA组合都已测试”是不同结论。
代码和测试中没有提供可引用的通用吞吐、延迟或显存收益数据。新增回归用例也不能替代具体AMD设备的运行结果;避免特定中止不等于全部GPU提速,已有fallback也不代表任何配置都必然更快。
代码修复身份与发行包状态怎样区分
这里讨论的是b12433对应的不可变提交f477c1b90adb1f27e80276c0ebeed4d04812e605及上述代码变化。代码提交、公开条目更新时间和预编译发行包是不同证据,不能把某个更新时间直接当作首次公开时刻,也不能据此判断所有平台包的可用状态。
需要评估这项修复时,应保留AMD、MUL_MAT_ID、输入类型、token数量和奇数列这组条件。相邻构建的其他功能与这项修复并不是同一个事件,不能把其他版本的功能、测试或性能数据拼到b12433名下。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















