


Python主要应用在哪些领域?Web开发、数据科学与AI实战解析
深入解析Python在Web开发、数据科学与人工智能三大核心领域的实际应用、架构分工、主流技术栈与工程选型指南。
一、Web开发:高生产力的后端服务与API架构
在 Web 开发中,Python 主要承担后端服务与接口系统的构建,常见于企业业务中台、高并发微服务 API、内容管理平台以及数据驱动型应用的底层架构。Python 的动态特性与丰富的扩展生态,使其在快速验证产品需求与构建稳定商业系统之间取得了良好的平衡。
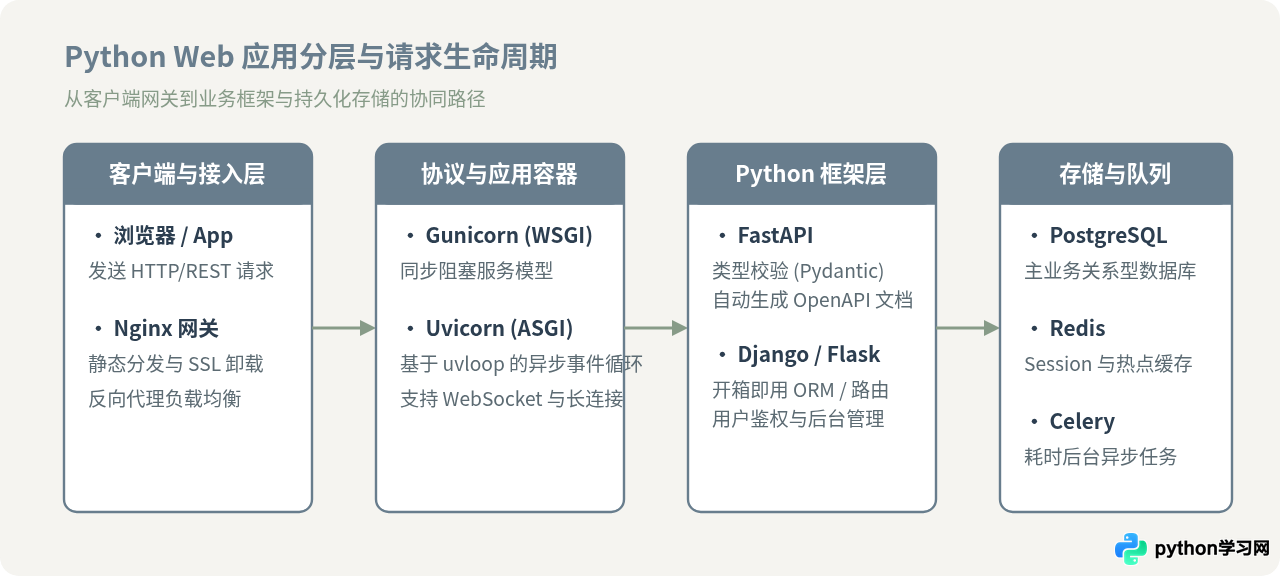
1. 主流框架选型:Django 与 FastAPI 的核心差异
在实际项目启动时,最常见的抉择发生在 Django 与 FastAPI 之间。两者的差异不在于优劣,而在于设计哲学与业务契合度:
- Django(全功能体系):提供完备的“电池内置”体验,自带强大的 ORM、Admin 管理后台、用户认证体系及表单验证机制。适合业务实体复杂、需要快速搭建完整中后台运营系统、或依赖成熟单体架构的团队。
- FastAPI(现代微服务与 API 优先):基于 Python 类型提示(Type Hints)与 Starlette/Pydantic 深度整合。核心优势在于极低的序列化开销、原生
async/await异步支持、以及根据代码自动生成的交互式 OpenAPI(Swagger)文档。适合作为前后端分离架构中的纯数据接口层、微服务节点或 AI 模型的在线推理网关。
2. 实战代码示例:FastAPI 构建结构化数据接口
以下示例展示了 FastAPI 如何通过 Pydantic 声明请求实体,并在异步上下文中完成数据校验与业务逻辑返回。
# 环境要求: pip install fastapi uvicorn pydantic
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field
from typing import Optional

app = FastAPI(title="用户任务处理服务", version="1.0.0")

class TaskCreateRequest(BaseModel):
    title: str = Field(..., min_length=2, max_length=100, description="任务标题")
    priority: int = Field(default=1, ge=1, le=5, description="优先级 1-5")
    payload: Optional[dict] = Field(default=None, description="任务扩展参数")

class TaskResponse(BaseModel):
    task_id: int
    title: str
    status: str

@app.post("/api/v1/tasks", response_model=TaskResponse, status_code=status.HTTP_201_CREATED)
async def create_task(task_in: TaskCreateRequest):
    # 模拟数据落库与异步触发
    if not task_in.title.strip():
        raise HTTPException(status_code=400, detail="标题不能为空白字符")

    generated_id = 1001
    return TaskResponse(
        task_id=generated_id,
        title=task_in.title,
        status="queued"
    )

# 启动命令: uvicorn main:app --host 0.0.0.0 --port 8000 --reloadasync def 路由中直接执行同步阻塞操作(如直接调用未经包装的大规模计算函数或同步 I/O 库)。阻塞事件循环会导致并发处理能力急剧下降。CPU 密集型任务应当分发给 Celery 或外部任务进程执行。
二、数据科学:从数据清洗、探索分析到指标建模
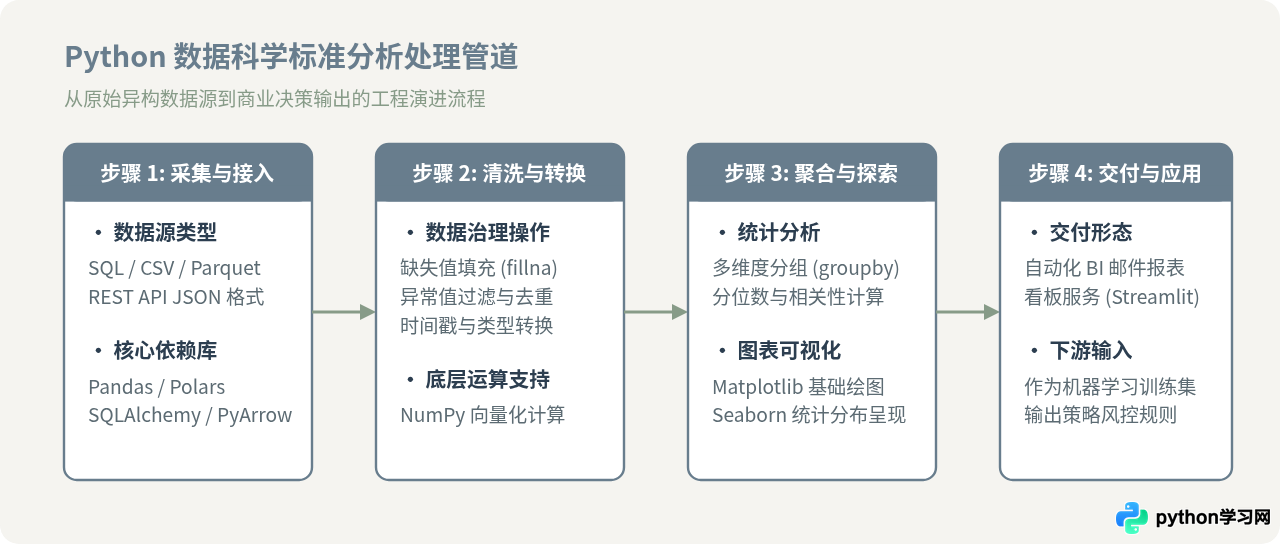
数据科学是 Python 生态最稳固的支柱领域。从商业智能指标归因、用户行为路径分析,到金融风控与实验指标量化,Python 提供了完整的工具闭环。数据科学工程的核心任务是将松散、多源、可能存在缺失或脏值的原始数据,转化为可信赖的分析结论与决策图表。
1. 核心库分工与协作机制
Python 数据科学的高效,源自底层各专门库的高度解耦与无缝协作:
- NumPy:提供底层连续内存布局的
ndarray结构,绝大多数数学运算以预编译的 C/Fortran 代码执行,避免 Python 解释器的循环开销。 - Pandas:建立在 NumPy 之上,提供类似于 SQL 表格的
DataFrame,专注于标签索引、复杂对齐、空值处理和分组透视。在千万级以下的数据规模中,是生产环境事实上的标准操作框架。 - Polars:作为现代替代方案,采用 Rust 构建且基于 Apache Arrow 内存模型,原生支持多线程并行与延迟计算(Lazy Execution),在内存紧张的大数据集场景中表现卓越。
2. 实战代码示例:结构化数据的清洗与分组聚合
# 环境依赖: pip install pandas numpy
import pandas as pd
import numpy as np

# 1. 模拟原始异构业务数据
raw_data = {
    "order_id": [101, 102, 103, 104, 105, 106],
    "channel": ["Organic", "Paid", "Paid", "Organic", np.nan, "Organic"],
    "amount": [128.5, 340.0, np.nan, 89.9, 520.0, -15.0],
    "order_time": ["2026-03-01", "2026-03-01", "2026-03-02", "2026-03-02", "2026-03-03", "2026-03-03"]
}

df = pd.DataFrame(raw_data)

# 2. 清洗与数据治理: 过滤负向异常值、填补缺失类别与均值数值
clean_df = df[df["amount"] > 0].copy()
clean_df["channel"] = clean_df["channel"].fillna("Unknown")
clean_df["amount"] = clean_df["amount"].fillna(clean_df["amount"].median())
clean_df["order_time"] = pd.to_datetime(clean_df["order_time"])

# 3. 分组聚合统计: 按推广渠道汇总订单数、销售总额与客单均价
summary = clean_df.groupby("channel").agg(
    order_count=("order_id", "count"),
    total_sales=("amount", "sum"),
    average_order_value=("amount", "mean")
).reset_index()

# 输出示例结果:
#    channel  order_count  total_sales  average_order_value
# 0  Organic            2        218.4                109.2
# 1     Paid            2        680.0                340.0
# 2  Unknown            1        520.0                520.0
三、人工智能:从传统机器学习到深度学习与大模型工程
Python 是全球人工智能研发与落地应用的通用语言。无论是学术界的算法突破,还是工业界的模型部署,Python 生态均占据核心地位。在实际工程落地中,人工智能通常划分为两条演进路径:以结构化特征预测为代表的经典机器学习,以及以 Transformer 架构与多模态为代表的深度学习与大语言模型(LLM)工程。
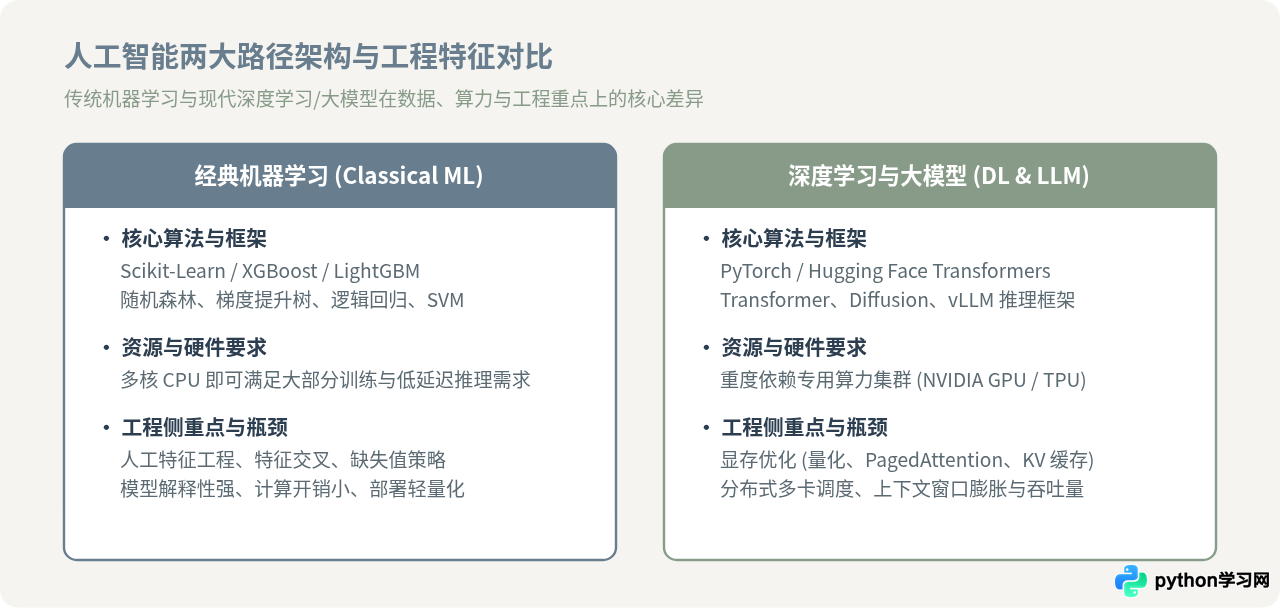
1. 经典机器学习与深度学习的核心差异
理解两者的工程差异,是制定 AI 实施策略的前提条件:
- 特征工程依赖度:经典机器学习(如 XGBoost、Scikit-Learn)的高度有效性建立在人工构建的领域特征上,其模型结构本身无法从原始非结构化信号中自发提取高阶语义。而深度学习(如 PyTorch、CNN、Transformer)通过多层非线性张量计算直接完成“端到端”(End-to-End)的特征抽取。
- 算力与部署边际成本:经典模型单次推理通常只需数毫秒级 CPU 算力,可在常规 Web 后端容器中无缝运行。深度模型和大模型则带来显存占用、显卡互联带宽及高昂的基础设施成本,工程上需要采用量化技术(如 AWQ、GPTQ)和专门的推断加速运行时(如 vLLM、TensorRT-LLM)。
2. 实战代码示例:利用 Scikit-Learn 完成标准化分类建模
以下代码演示了经典机器学习中从特征拆分、标准化预处理到模型评估的标准工程闭环:
# 环境依赖: pip install scikit-learn
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report

# 1. 构造包含 1000 样本、10 维数值特征的模拟二分类数据
X, y = make_classification(n_samples=1000, n_features=10, random_state=42)

# 2. 严格切分训练集与测试集,防止数据泄露 (Data Leakage)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 3. 特征缩放: 仅在训练集上 fit 参数,并 transform 到测试集
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 4. 训练随机森林分类模型
clf = RandomForestClassifier(n_estimators=100, max_depth=6, random_state=42)
clf.fit(X_train_scaled, y_train)

# 5. 输出评估报告
predictions = clf.predict(X_test_scaled)
print(classification_report(y_test, predictions))
四、三大领域技术选型与实战决策指南
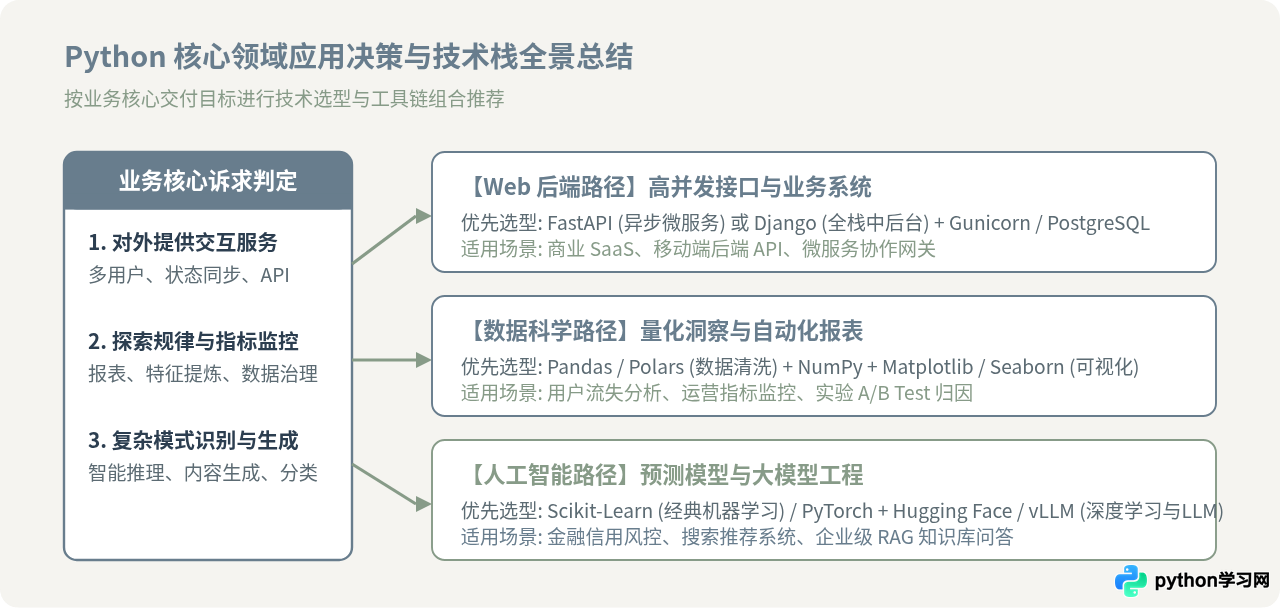
在实际项目架构设计中,许多复杂系统往往是这三大领域的有机结合:Web 服务作为交互入口提供 API,后台数据科学管道提取用户行为特征,再由 AI 服务返回推荐或生成内容。为了在面对具体业务诉求时准确选择技术路径,需要从核心约束维度进行对照评估。
| 评估维度 | Web 开发 | 数据科学与分析 | 人工智能工程 |
|---|---|---|---|
| 典型产物 | RESTful API、微服务集群、管理后台 | 商业指标报表、特征数据集、交互看板 | 分类/预测模型、检索增强 (RAG)、生成式服务 |
| 主流技术栈 | FastAPI, Django, Gunicorn, PostgreSQL | Pandas, NumPy, Polars, Matplotlib | PyTorch, Scikit-Learn, Transformers, vLLM |
| 性能核心瓶颈 | I/O 阻塞、数据库查询开销、高并发连接 | 单机内存限制、大数据集序列化开销 | 显存容量 (VRAM)、GPU 算力吞吐、延迟控制 |
| 测试与验证重点 | 接口合约、单元覆盖、压力测试、数据一致性 | 统计分布合理性、空值边界、指标回测 | 准确率/召回率、幻觉率、延迟与长尾耗时 |
3. 落地建议
在实际项目落地时,建议遵循以下两条原则:
- 避免过早引入复杂架构:如果业务问题通过规则过滤或 Scikit-Learn 经典分类模型即可取得可接受的精度,不要急于引入需要昂贵 GPU 资源的深度神经网络或大模型微调方案。轻量级模型在推理开销与可维护性上具备显著优势。
- 明确分工边界:利用 FastAPI 或 Django 负责网络 I/O、权限控制与协议序列化,将数据密集型计算与模型推理逻辑封装为独立模块或 RPC 节点,避免在 Web 处理主循环中产生高负载阻塞。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















