


做Python爬虫工作是否需要精通前端技术
深入解答做Python爬虫工作是否需要精通前端技术,厘清爬虫工程与前端全栈开发的关注边界,剖析DOM定位、网络抓包、异步数据流及JavaScript逆向的核心技术诉求,提供实用定向学习路径。
做 Python 爬虫工作不需要“精通”前端技术,但必须对前端的“数据传输机制与代码执行逻辑”建立精准的定向理解。爬虫的核心诉求是分析通信协议、提取结构化数据以及突破防爬逻辑,而不是构建高可用、跨端兼容或视觉优良的网页界面。盲目学习前端工程化会浪费大量精力;将注意力集中在 HTTP 通信、DOM 树解析、浏览器开发者工具使用以及 JavaScript 逆向调试上,才是爬虫工程师最具性价比的技术投资。
一、明确界限:爬虫工程与前端全栈的技能诉求差异
许多初学者在刚开始接触爬虫时容易陷入一个认知误区:既然爬虫要抓取网页,是不是必须把 HTML、CSS、JavaScript、Vue、React 以及 Webpack 从头到尾学个精通?答案是否定的。前端工程师与爬虫工程师虽然都与浏览器和 Web 页面打交道,但两者的工程目标完全相反。
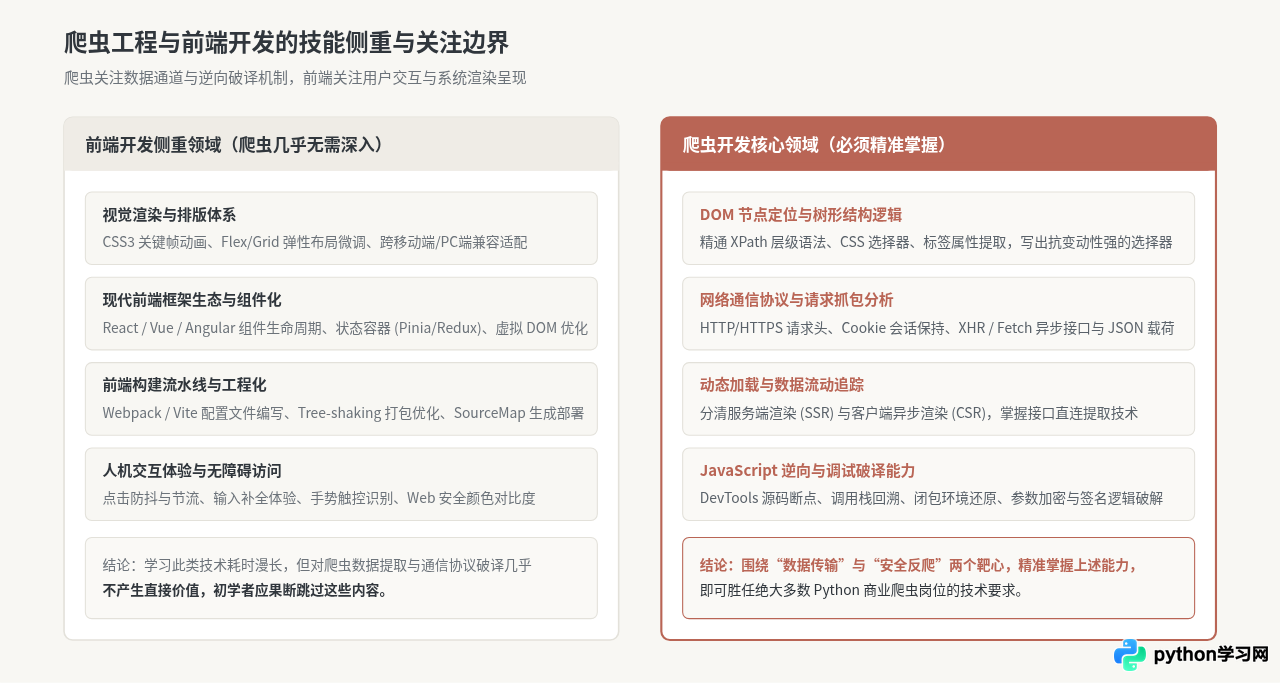
前端开发的核心任务是“构造与呈现”。前端工程师关注的是组件设计模式、全局状态管理、复杂页面的渲染性能(如防抖节流与减少重排重绘)、CSS 视觉特效以及多端屏幕适配。而爬虫开发的核心任务是“拆解与还原”。爬虫工程师从不关心按钮的圆角半径是多少像素,也不在乎下拉菜单的动画过渡是否平滑,关心的只有三件事:数据最初从哪个网络接口返回、请求参数是如何生成的、数据最终以何种结构挂载在文档树中。
| 技能维度 | 前端开发者的关注重心 | Python 爬虫工程师的关注重心 |
|---|---|---|
| HTML / 结构 | 语义化标签、无障碍访问 (a11y)、SEO 标签排布 | DOM 节点层级、XPath 与 CSS Selector 唯一路径提取 |
| CSS / 样式 | Flex/Grid 布局、CSS 动画、Sass/Less、多端响应式兼容 | 仅需了解基础类名与属性选择器规则,无需掌握排版细节 |
| JavaScript / 交互 | 业务逻辑实现、框架组件生命周期、前端状态管理 | 异步请求触发机制、数据加解密算法还原、JS 逆向分析 |
| 工程化与工具 | Webpack/Vite 打包编译、Babel 转译、代码规范与 CI/CD | Chrome DevTools 抓包与断点调试、AST 反混淆工具 |
从上表可以看出,爬虫工程师需要的是一个经过高度剪裁的“逆向视角前端知识库”。如果耗费数月时间去深入钻研 CSS 动画框架或 React 内部 Fiber 架构的运行机制,对于提升爬虫实战能力几乎没有直接帮助。
二、基础阶段:静态解析与网络通信的底线要求
在面对传统服务端渲染(SSR)的网页或格式规范的内容站时,爬虫的工作重心在于获取 HTML 文档并从中抽取出需要的信息。这个阶段所需的前端知识非常有限,主要由两部分构成:基础 DOM 树理解与定位语法。
1. 理解 DOM 树结构而非编写 HTML
学习 HTML 时,不需要记住每个标签在浏览器里如何显示,只需要知道文档是由一个具有严格层级关系的节点树(Document Object Model)构成的。每个节点具备标签名(tag name)、属性(id、class、href、data-*)以及子节点或文本内容。
在提取数据时,爬虫主要依托两种定位器语法:XPath 与 CSS Selector。精通这两种语法是爬虫工程师的基本功:
- XPath:支持沿节点层级向上(
parent::)或向下遍历,支持谓词过滤(例如//div[contains(@class, 'article-title')])与文本精确匹配,在处理复杂树形结构时极其稳健。 - CSS Selector:基于前端类名与 ID 的级联选择语法(例如
div.content > p:first-child),解析速度通常更快,语法更紧凑。
# 示例:利用 lxml 与 Python 提取结构化内容
from lxml import etree

html_content = """
<div class="product-card" id="item-9821">
    <h3 class="title">Python 网络爬虫权威实战</h3>
    <span class="price-symbol">¥</span><span class="price">89.00</span>
    <a href="/detail/9821" class="btn-buy">购买</a>
</div>
"""

tree = etree.HTML(html_content)
# 通过 XPath 精确提取价格数字,避免误采符号
price = tree.xpath("//div[@id='item-9821']//span[@class='price']/text()")[0]
title = tree.xpath("//h3[@class='title']/text()")[0]
print(f"商品: {title}, 价格: {price}")
# 输出:商品: Python 网络爬虫权威实战, 价格: 89.00
在这个环节,写出优秀爬虫的关键在于“编写具备高容错率的定位表达式”。前端开发者可能经常更换 CSS 类名或重新包裹外层容器,如果爬虫依赖形如 /html/body/div[2]/div[1]/p 这样的绝对路径,一旦前端改版就会全面崩溃。具备基本前端 DOM 知识的爬虫工程师,会优先寻找具有业务稳定性的语义锚点属性进行相对定位。
三、核心阶段:现代异步 Web 的抓包与数据流排查
随着单页应用(SPA)与前后端分离架构的普及,大量网站的前端只提供一个空壳 HTML 页面,具体内容完全通过客户端发起异步请求(Fetch / XHR)动态拉取并渲染。很多初学者一看到页面动态变化,就盲目启动 Selenium 或 Playwright 无头浏览器去模拟点击。这种做法不仅执行效率极低、资源消耗巨大,而且极易被反爬指纹识别。
真正成熟的爬虫工程师,首先会利用 Chrome 开发者工具(F12)的 Network 面板进行流量审计。事实上,80% 以上所谓的“动态网页”,其本质不过是前端向后端 API 接口发起了一个返回标准 JSON 数据的 HTTP 请求。
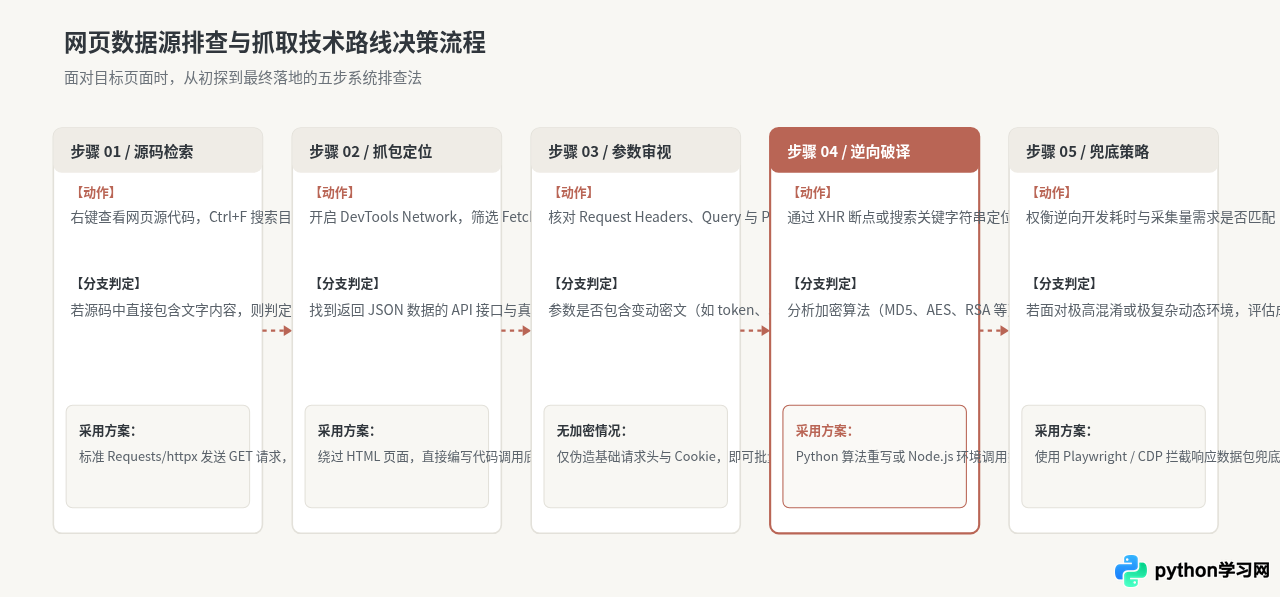
在排查异步请求时,爬虫开发者最常使用的技能并不是写前端代码,而是使用浏览器开发者工具进行“反向定位”:
- 网络过滤器(Filter):通过
Fetch/XHR快速过滤掉无意义的图片、CSS 与字体请求。 - 复制为 cURL:在 Network 面板的请求条目上右键选择
Copy as cURL (bash),然后通过在线工具或 Python 脚本直接将其转换为标准的requests.get()代码,几秒钟即可验证接口的可用性。 - 标头分析(Headers):重点分析
Cookie、User-Agent、Referer、Origin以及自定义 Header(如X-Requested-With或Authorization)。
四、关键分水岭:爬虫必须深啃的 JavaScript 逆向能力
如果说基础 DOM 解析与抓包还算比较初级,那么 JavaScript 逆向分析 则是决定一个爬虫工程师是否合格、能否迈入中高级阶段的关键分水岭。
商业网站为了防范自动化抓取,通常会对请求参数加入动态校验机制,例如在请求头或 URL Query 中附带一段加密哈希值(通常命名为 _signature、sign、token 等)。如果爬虫不能按照目标网站前端 JS 脚本计算出完全一致的合法签名,服务端就会直接返回 403 Forbidden 或验证码拦截。在这个场景下,爬虫工程师对 JavaScript 语言的理解深度要求,甚至在某些特定维度上超过了普通的前端初级工程师。
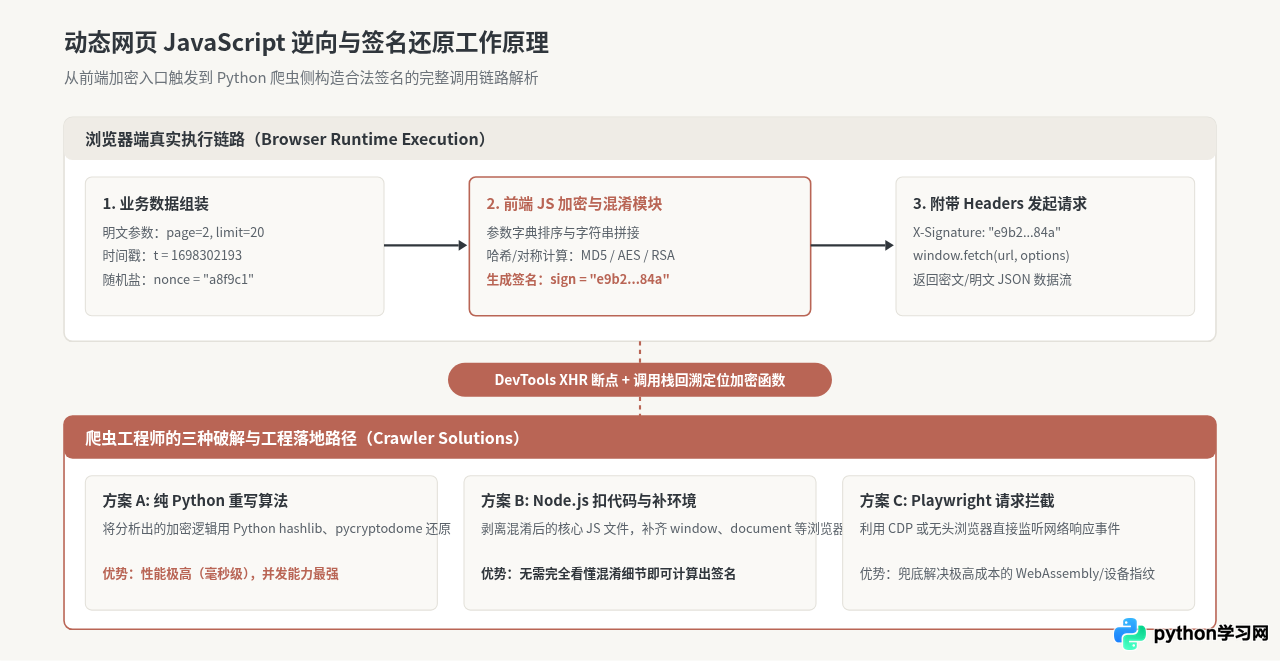
要胜任这部分工作,爬虫工程师需要具体掌握哪些 JavaScript 知识?
- 闭包与作用域链:混淆代码(如 JSFuck、OB 混淆)极其喜欢使用自执行函数(IIFE)和多层闭包将核心变量隐藏起来。只有理解作用域与变量提升规则,才能看懂变量在何时被赋值与重写。
- 原型与原型链(Prototype):很多反爬逻辑会通过挂载在
Function.prototype或Object.prototype上的钩子函数来检测开发者工具是否打开,或者拦截某些标准 API 调用。 - 异步执行模型:理解 JavaScript 事件循环(Event Loop)、
Promise链式调用与async/await的语法,清楚数据何时从网络返回并被解密函数处理。 - 常见标准加密算法:识别 MD5(固定 32 位十六进制)、SHA 系列、Base64 编码规则、AES(CBC/ECB 模式、IV 偏移量、Padding 填充)、RSA(公钥加密、模数指数)。
- DevTools 断点调试技巧:掌握 XHR/fetch 断点、DOM 子树修改断点、Event Listener 断点以及利用
Call Stack(调用栈)逆向回溯上层调用者的技能。
虽然 JS 逆向要求对语言特性的理解很深,但这依然不等于精通前端开发。前端开发者关注的是“如何用最优雅的架构组织 JS 代码”,而逆向者关注的是“如何在一段面目全非的混淆代码中找出产生特定输出的那 50 行核心运算”。
五、Python 爬虫工程师的前端技能精简学习路径
针对计划从事或正在从事 Python 爬虫工作的读者,我们建议将有限的时间投入到最核心的环节,按照如下四个层级有针对性地学习:
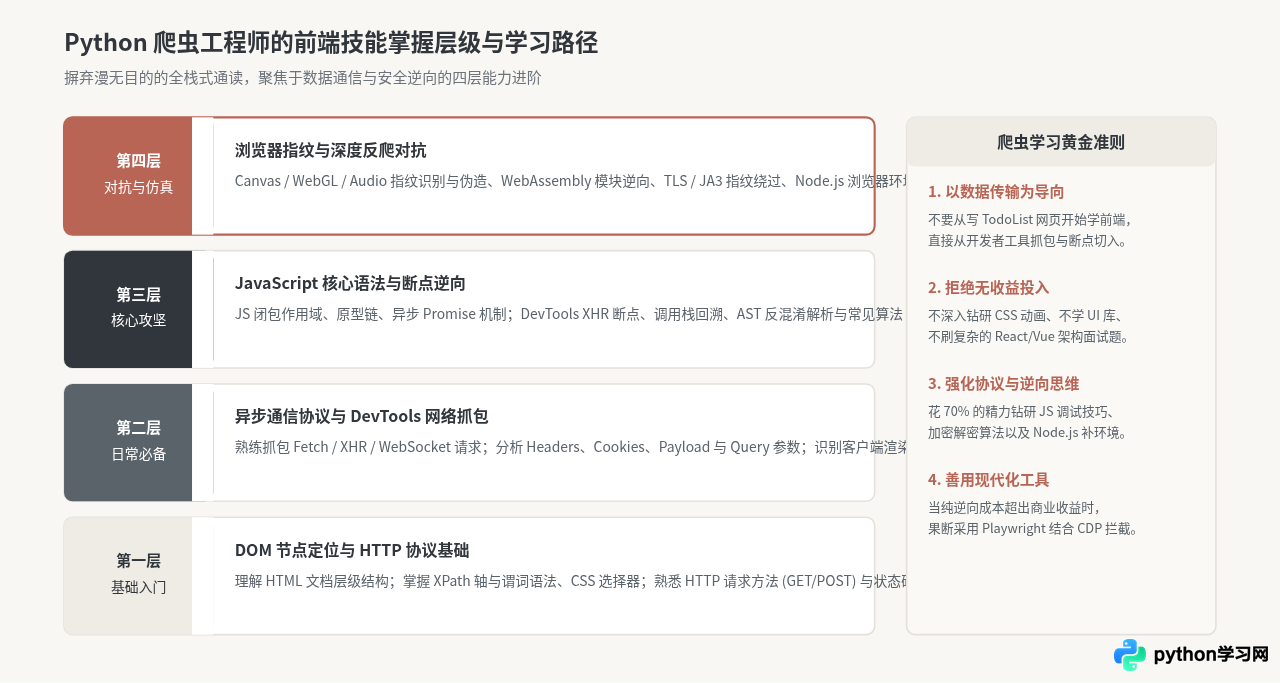
六、总结
回到最初的问题:做 Python 爬虫工作是否需要精通前端技术?
如果你所理解的“前端技术”指的是构建完整企业级网站所需的前端全栈生态(包含样式编写、UI 框架深度应用、前端工程化打包与跨端适配),那么答案是完全不需要精通,甚至连中等水平都不必达到;
但如果你所指的是“网页如何在浏览器中与服务端交换数据、浏览器内部如何解析执行代码”,那么答案是必须精准定向掌握。一名优秀的 Python 爬虫工程师,在 HTTP 协议细节、浏览器网络抓包、DOM 定位语法以及 JavaScript 逆向断点调试方面的理解深度,必须足够扎实与敏锐。明确这一技能边界,能够帮助你在学习爬虫的道路上避开大量无效的沉没成本,将时间高效转化为实战解决能力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















