


Python离散积分结果为NaN或错误的排查方法
针对Python中使用NumPy与SciPy进行离散数值积分时返回NaN、数值出现负数或严重偏差的问题,提供系统化排查步骤、底层数学原因分析、代码诊断示例与防御式编写方案。
在利用 Python 进行科学计算与工程数据分析时,离散数值积分通常借助 numpy.trapz、scipy.integrate.trapezoid、scipy.integrate.simpson 或 cumulative_trapezoid 实现。若计算结果返回 NaN,核心原因在于被积数组或自变量网格中潜藏无效值(NaN、Inf)导致浮点异常;若积分数值出现严重偏差(如符号反转为负、数量级偏差千百倍或单调累积曲线波动),主要根因是自变量数组未单调递增导致步长为负、未传递自变量数组导致默认步长 dx=1.0 失真,或在非均匀网格上误用高阶方法。排查的根本路径在于依序执行“输入数据清洗”、“坐标轴单调与量纲验证”以及“算法与边界对齐”。
一、系统排查流程与快速定位
面对非预期的积分结果,盲目更换积分库往往无法解决问题。建议先通过诊断脚本对数据特征进行分层断言。离散积分本质上是加权求和,任何单一区间的浮点污染都会蔓延至全局结果。
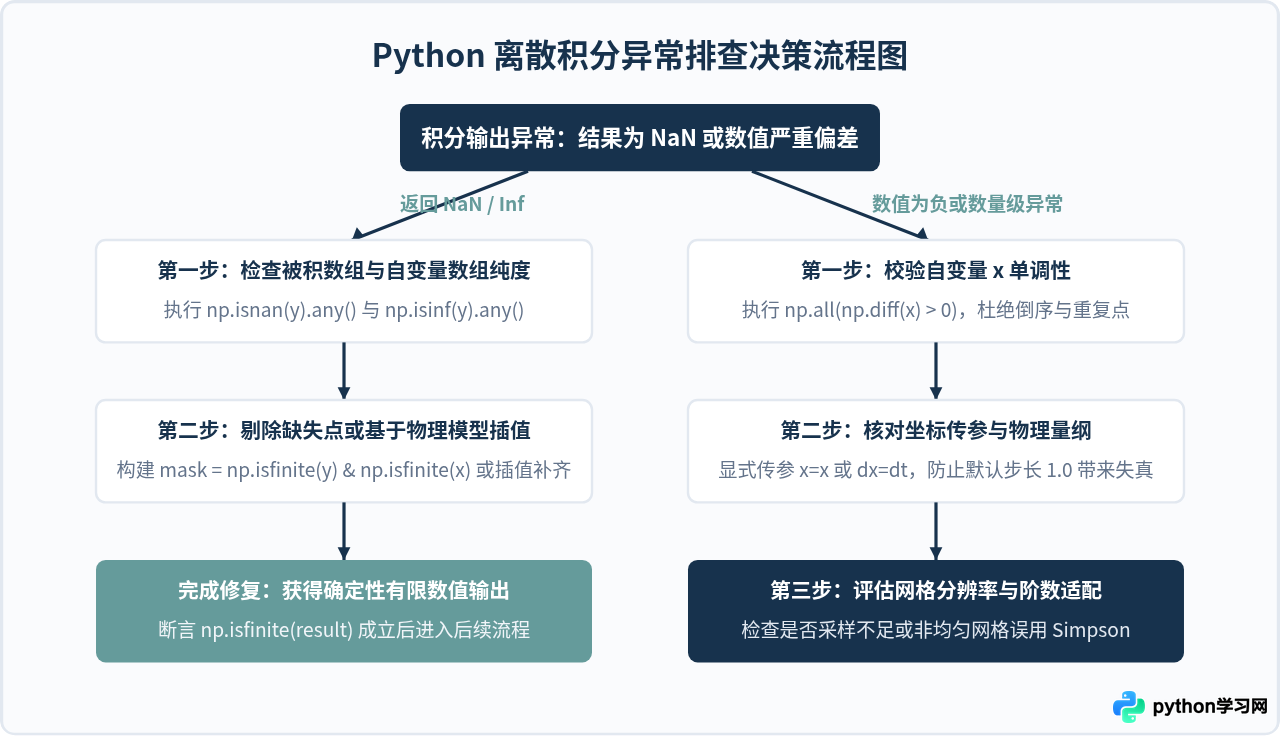
在编写处理代码前,可先运行以下诊断代码片断,快速打印关键排查项的健康状态:
import numpy as np

def diagnose_discrete_integral(x, y):
    print("=== 离散积分数据健康检查 ===")
    has_nan_y = np.isnan(y).any()
    has_inf_y = np.isinf(y).any()
    print(f"y 数组包含 NaN: {has_nan_y}, 包含 Inf: {has_inf_y}")

    if x is not None:
        has_nan_x = np.isnan(x).any()
        has_inf_x = np.isinf(x).any()
        print(f"x 数组包含 NaN: {has_nan_x}, 包含 Inf: {has_inf_x}")

        dx = np.diff(x)
        is_strictly_increasing = np.all(dx > 0)
        has_duplicates = np.any(dx == 0)
        has_negative_dx = np.any(dx < 0)
        print(f"x 是否严格单调递增: {is_strictly_increasing}")
        print(f"x 是否含重复坐标点: {has_duplicates}")
        print(f"x 是否存在逆向负步长: {has_negative_dx}")
    else:
        print("警告: 未提供 x 坐标数组,将默认使用 dx=1.0 计算!")
二、原因一:数组包含 NaN 或 Inf 导致的浮点污染
离散梯形积分的数学表达式为:
$$\int_a^b f(x)dx \approx \sum_{i=0}^{n-1} \frac{y_i + y_{i+1}}{2} \cdot (x_{i+1} - x_i)$$
在 IEEE 754 浮点数计算标准下,任何有限数值与 NaN 相加均产生 NaN。因此,即使长达数十万行的数组中仅有一个元素为 np.nan,累加求和的结果就会整体变为 NaN。类似地,如果输入中存在除零计算产生的 Inf,当正负无穷相加时同样会产生未定义操作(Inf - Inf = NaN)。
排查与修复方法
当确认数据中存在非有限值时,不可直接调用 trapezoid,需根据数据采集的物理背景选择处理策略:
- 非均匀点直接剔除(推荐):若数据为离散采样点,且自变量支持非均匀网格,可直接使用布尔索引同时过滤自变量与因变量。
- 规则网格线性插值:若算法要求保留固定的时间步长,可利用已有的有效点对无效点做插值填补。
import numpy as np
from scipy.integrate import trapezoid

# 模拟含有缺失点的数据
x_raw = np.linspace(0, 10, 100)
y_raw = np.sin(x_raw)
y_raw[45] = np.nan  # 偶发丢包

# 错误做法: 直接积分将得到 nan
bad_res = trapezoid(y_raw, x=x_raw)
print("直接积分结果:", bad_res)  # 输出: nan

# 正确做法 1: 同步剔除无效样本点
valid_mask = np.isfinite(x_raw) & np.isfinite(y_raw)
x_clean = x_raw[valid_mask]
y_clean = y_raw[valid_mask]
clean_res = trapezoid(y_clean, x=x_clean)
print("清洗后积分结果:", clean_res)

# 正确做法 2: 对缺失点实施线性插值
y_interp = np.interp(x_raw, x_clean, y_clean)
interp_res = trapezoid(y_interp, x=x_raw)
print("插值后积分结果:", interp_res)
三、原因二:自变量 x 未排序或存在重复坐标
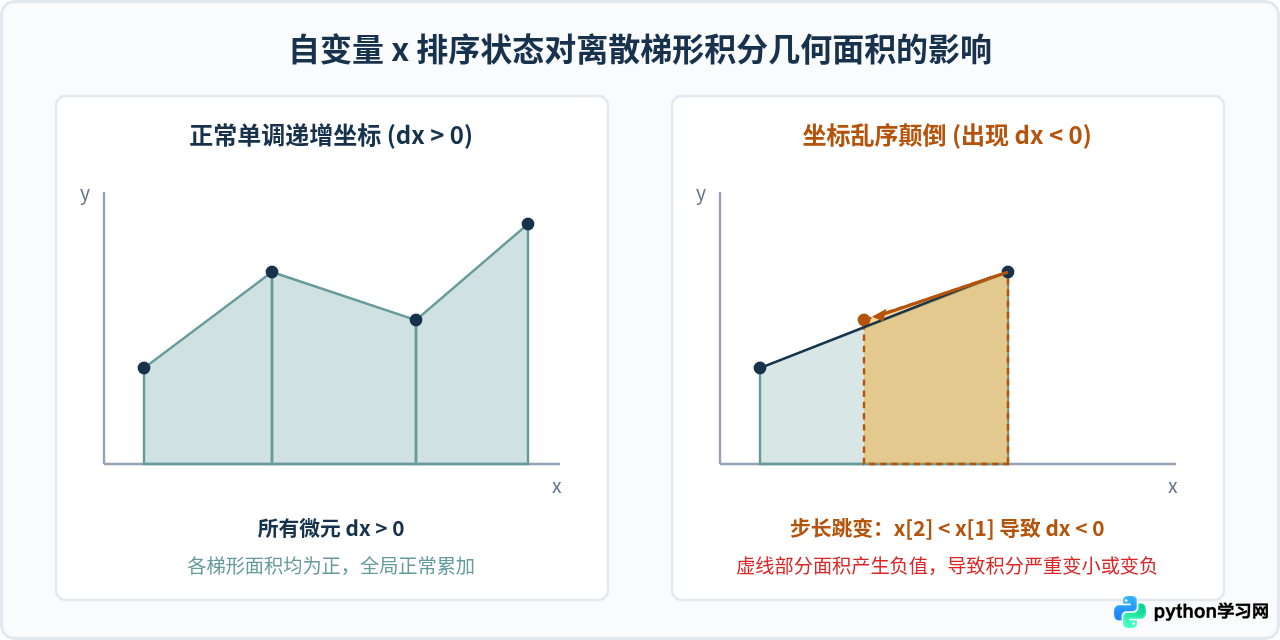
这是导致积分数值严重偏离理论值、甚至出现错误负数的最隐蔽原因。离散积分工具假设数组是沿积分路径前进的。在物联网时序数据或多传感器合并数据中,若未经严格排序,时间戳可能会发生前后颠倒。
当 $x_{i+1} < x_i$ 时,计算得到的微元步长 $\Delta x_i = x_{i+1} - x_i$ 为负数。原本正向的几何面积在此时变成了负数并参与全局累加,造成大面积数值相互抵消,甚至令全为正值的函数积分结果变为负数。
排查与排序修复方案
确保自变量严格单调递增,并在排序时保持 $x$ 与 $y$ 的对应关系同步。若存在重复点($dx = 0$),虽然数学上该单点区间面积为 0,但在辛普森法中会破坏等距网格假设,因此建议合并或剔除重复项。
import numpy as np
from scipy.integrate import trapezoid

# 模拟未排序的离散实验数据
x_unsorted = np.array([0.0, 1.2, 0.8, 2.5, 3.1])
y_unsorted = np.array([1.0, 3.0, 2.0, 4.0, 5.0])

# 错误计算: 出现 dx < 0
wrong_val = trapezoid(y_unsorted, x=x_unsorted)
print("未排序积分结果:", wrong_val)  # 结果偏小或发生符号畸变

# 正确做法: 使用 argsort 严格重排
sort_indices = np.argsort(x_unsorted)
x_sorted = x_unsorted[sort_indices]
y_sorted = y_unsorted[sort_indices]

# 检查是否存在重复坐标
dx = np.diff(x_sorted)
if np.any(dx == 0):
    # 处理重复值: 保留唯一值并对 y 做均值或去重
    _, unique_idx = np.unique(x_sorted, return_index=True)
    x_sorted = x_sorted[unique_idx]
    y_sorted = y_sorted[unique_idx]

correct_val = trapezoid(y_sorted, x=x_sorted)
print("正序积分结果:", correct_val)
四、原因三:漏传 x 坐标引发的默认步长与量纲灾难
在调用 scipy.integrate.trapezoid(y) 或 numpy.trapz(y) 时,很多初学者仅传入因变量数组 y。查看官方文档可以发现:
x 或 dx 参数时,函数默认设定采样间隔为 dx = 1.0。
这一机制经常在实际物理工程中造成灾难性的数量级错误:
- 高频采样场景:例如以 1000 Hz 采集加速度计算速度,实际采样周期是 $\Delta t = 0.001\text{ s}$。若未指定时间数组,每个微元都放大了 1000 倍,最终积分值直接虚高 3 个数量级。
- 非等间距场景:若自变量网格为对数分布、自适应密集分布或非均匀采集,按默认均匀步长 1.0 计算将彻底破坏曲线权重分布。
import numpy as np
from scipy.integrate import trapezoid

# 采样频率 1000 Hz, 采集 1 秒
fs = 1000
dt = 1.0 / fs
t = np.arange(0, 1.0, dt)
signal = 5.0 * np.sin(2 * np.pi * 5 * t) + 2.0  # 含有直流偏置 2.0 的信号

# 理论直流偏置在 1 秒内的积分为 2.0 * 1.0 = 2.0
# 错误做法: 忽略 x 或 dx
res_default = trapezoid(signal)
print(f"漏传坐标时的积分值: {res_default:.2f}")  # 输出约 2000.0 (放大 1000 倍!)

# 正确做法: 显式指定 x 或 dx
res_correct_x = trapezoid(signal, x=t)
res_correct_dx = trapezoid(signal, dx=dt)
print(f"显式传递 x 的积分值: {res_correct_x:.4f}")  # 输出约 2.0000
print(f"显式传递 dx 的积分值: {res_correct_dx:.4f}")  # 输出约 2.0000
五、原因四:算法适用性与采样密度失真
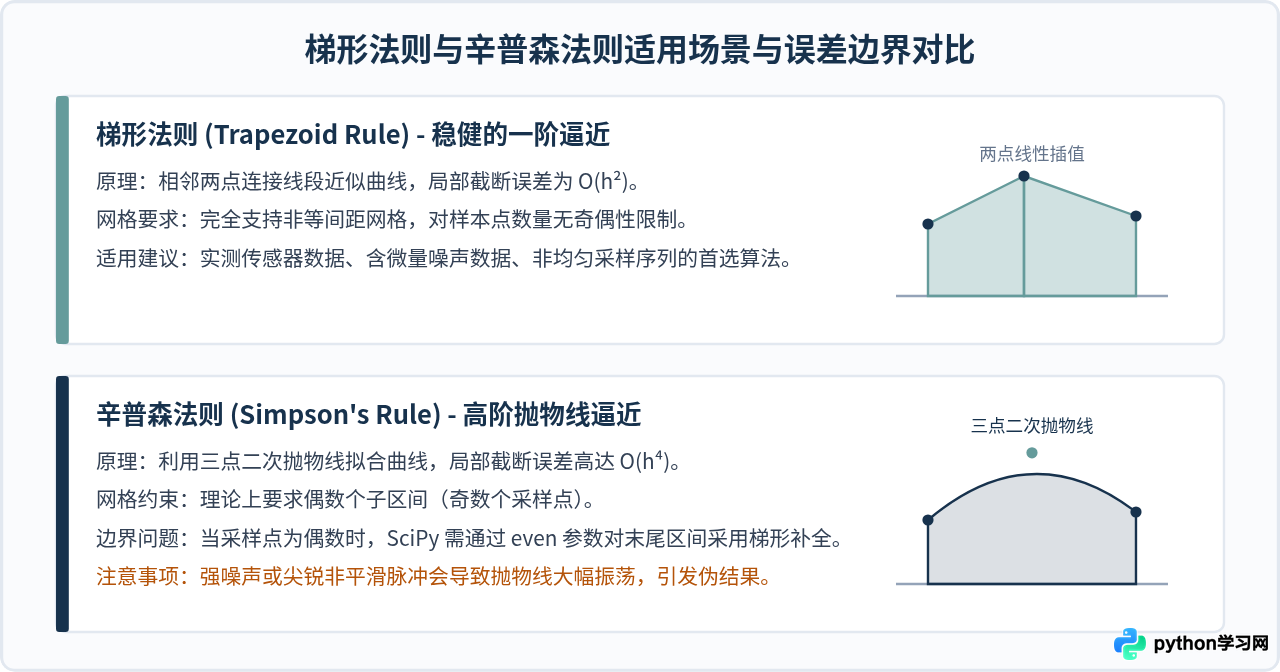
除梯形法外,scipy.integrate.simpson(辛普森法则)经常用于追求更高精度的场景。然而高阶方法对输入网格和离散质量有更苛刻的数学约束。
辛普森算法的偶数点排查(even 参数)
当离散数组的点数为偶数时,子区间数量为奇数,无法完整构成“三点成对”的二阶抛物线。在旧版 SciPy 中甚至会抛出警告或错误,而在现代版本中,scipy.integrate.simpson 提供了 even 参数(可选 'avg'、'first'、'last'):
even='avg':对首端或末端区间分别做梯形补偿后取加权平均,计算最为稳健。even='last':前 $N-1$ 个点做辛普森积分,最后一个区间使用梯形积分补全。even='first':首个区间做梯形积分,剩余点做辛普森积分。
from scipy.integrate import simpson
import numpy as np

# 偶数个采样点 (例如 10 个点,9 个区间)
x = np.linspace(0, np.pi, 10)
y = np.sin(x)

# 显式指定 even 参数,避免不可控的默认行为
res_simpson = simpson(y, x=x, even='avg')
print("Simpson (even='avg') 结果:", res_simpson)
六、原因五:累积积分(cumulative_trapezoid)的数组错位
在工程中,若不仅需要总积分值,还需要获取连续的时程曲线,通常会使用 scipy.integrate.cumulative_trapezoid。此处存在一个极易引发代码隐式崩溃的机制:
cumulative_trapezoid(y, x) 默认返回的数组长度为 len(y) - 1!因为每个输出元素代表前 $i$ 个微区间的面积和,默认不包含起始点面积 0。
若直接将输出结果与原始输入 $x$ 数组绘制曲线或执行点对点算术运算(例如 diff = y - cum_int),Python 将直接抛出 ValueError: operands could not be broadcast together with shapes。而在复杂流水线中,若发生切片错位广播,就会造成数值整体漂移与累积误差。
正确配置 initial 参数
为了保持输出数组与输入坐标在长度与物理意义上严格一致,必须显式传递 initial=0:
from scipy.integrate import cumulative_trapezoid
import numpy as np

t = np.linspace(0, 5, 6)
v = 2.0 * t  # 加速度为常数 2,速度线性增长

# 默认调用: 长度缺失
s_default = cumulative_trapezoid(v, x=t)
print("原始长度:", len(t), "默认累积结果长度:", len(s_default))  # 6 和 5

# 正确规范: 设置 initial=0 确保对齐
s_aligned = cumulative_trapezoid(v, x=t, initial=0)
print("设置 initial=0 后的长度:", len(s_aligned))  # 6
print("起点位移保证为零:", s_aligned[0])  # 0.0
七、工程防御式编码与全景总结
为了在生产环境与科学计算脚本中杜绝 NaN 与离奇错误数值,建议编写通用的防御式积分封装函数。下表总结了五类典型故障与针对性处理措施:
| 异常现象 | 排查核心指标 | 典型根因 | 标准修复方案 |
|---|---|---|---|
结果恒为 NaN |
np.isnan(y).any() |
数据中潜藏缺失值、传感器断流或浮点除零 | 基于 np.isfinite() 构建双向有效掩码,或使用 np.interp 插值 |
| 结果出现负数或大幅变小 | np.any(np.diff(x) <= 0) |
自变量时间戳未排序,产生负步长抵消真实面积 | 调用 np.argsort(x) 同步对 $x$ 和 $y$ 实施全局严格升序排列 |
| 结果产生成百上千倍偏差 | 调用签名中缺少 x 或 dx |
函数隐式使用 dx=1.0 计算,脱离实际物理采样周期 |
显式传入 x=x 坐标序列或指定 dx=dt 物理步长 |
| 高阶积分非预期波动 | len(x) % 2 与噪声水平 |
非均匀网格误用 Simpson,或偶数点边界处理失配 | 切换回稳健的 trapezoid,或指定 even='avg' |
| 累积曲线发生索引广播报错 | len(result) != len(y) |
cumulative_trapezoid 默认未包含初始原点 |
显式指定 initial=0 保证与输入时间轴完全对齐 |
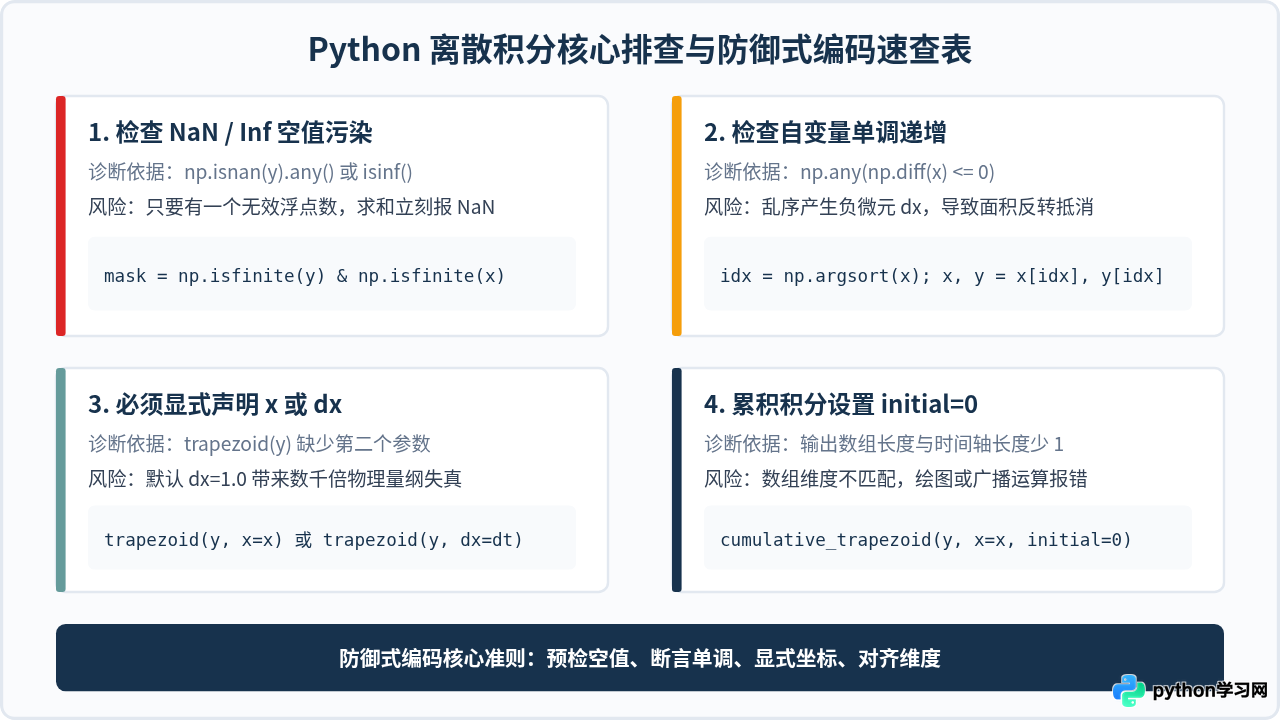
工业级安全积分封装函数
在长期运行的自动化处理脚本或生产管线中,建议采用统一的封装函数收拢异常逻辑:
import numpy as np
from scipy.integrate import trapezoid

def robust_discrete_integral(y, x=None, dx=None, method='trapezoid'):
    """
    具备数据清洗、单调排序及量纲校验的健壮离散积分封装函数
    """
    y_arr = np.asarray(y, dtype=float)

    # 1. 坐标轴初始化与有效性判定
    if x is not None:
        x_arr = np.asarray(x, dtype=float)
        if len(x_arr) != len(y_arr):
            raise ValueError(f"x 与 y 长度不一致: {len(x_arr)} vs {len(y_arr)}")

        # 过滤 NaN 与 Inf
        valid_mask = np.isfinite(x_arr) & np.isfinite(y_arr)
        if not np.any(valid_mask):
            raise ValueError("有效采样点数量为 0,无法计算积分")

        x_clean = x_arr[valid_mask]
        y_clean = y_arr[valid_mask]

        # 强制单调递增排序
        sort_idx = np.argsort(x_clean)
        x_clean = x_clean[sort_idx]
        y_clean = y_clean[sort_idx]

        # 去除重复坐标
        diff_x = np.diff(x_clean)
        if np.any(diff_x == 0):
            _, unique_idx = np.unique(x_clean, return_index=True)
            x_clean = x_clean[unique_idx]
            y_clean = y_clean[unique_idx]

        return trapezoid(y_clean, x=x_clean)
    else:
        # 未指定 x 序列时,检查 dx 是否合理
        valid_mask = np.isfinite(y_arr)
        y_clean = y_arr[valid_mask]
        step = 1.0 if dx is None else float(dx)
        return trapezoid(y_clean, dx=step)
通过先清洗数据、验证单调自变量、显式声明步长并遵循算法适用边界,即可从根本上消除 NaN 与非预期偏差,保证数值计算的确定性与可靠性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















