


Python数据库不必要的高精度对存储与JSON序列化的影响
深入解析在Python数据库开发中滥用超高精度DECIMAL字段对磁盘存储、B+树索引、内存缓存以及JSON序列化带来的性能与体积损耗,并给出科学选型与工程优化方案。
DECIMAL(38, 18) 或 NUMERIC(36, 18))。这种做法看似万无一失,却在物理存储层造成了不可忽视的数据与索引膨胀,并在 Python 应用层给 JSON 序列化带来了严重的兼容断点、网络载荷激增与计算开销。本文将剖析其内在机制,并给出兼顾精确度与吞吐性能的工程落地实践。
一、底层存储的隐形膨胀:数据库中定点数的物理布局
在关系型数据库(如 MySQL InnoDB 或 PostgreSQL)中,DECIMAL(或 NUMERIC)并非采用 CPU 原生的 64 位浮点表示,而是通过分段二进制编码或字节数组存储的变长/固定打包定点数。以 MySQL 为例,InnoDB 引擎将十进制数字划分为每 9 位数字一组,每组使用固定的 4 字节二进制整数保存,剩余的余数位再按 1 至 4 字节分别保存。
当开发者随手定义了一个 DECIMAL(38, 18) 字段时,该字段包含 20 位整数部分和 18 位小数部分。整数部分需要 9 + 9 + 2 位,分别消耗 4 + 4 + 1 = 9 字节;小数部分需要 9 + 9 位,消耗 4 + 4 = 8 字节。也就是说,即使该字段仅存储数字 1.00,单行也要硬性消耗 17 字节的物理存储空间。相比之下,标准的 DOUBLE 仅需 8 字节,存放分/厘的 BIGINT 仅需 8 字节,而合理定义的 DECIMAL(10, 2) 仅需 5 字节。
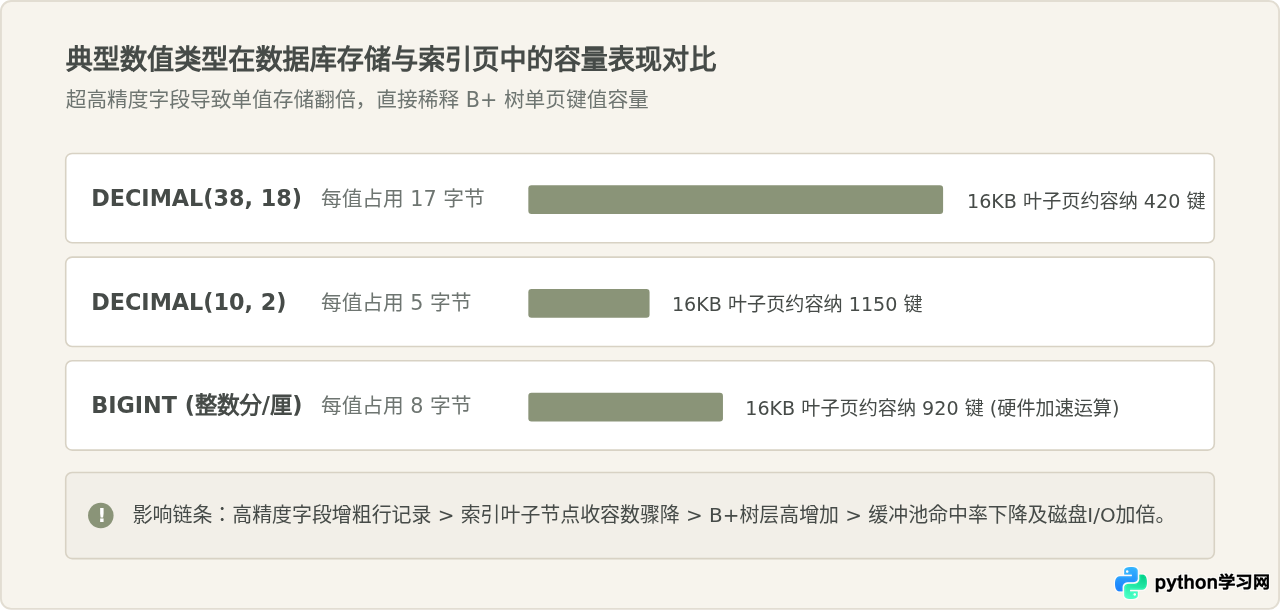
单行多耗费十余字节在百万或千万级数据量下会被显著放大。更严重的影响发生在索引与内存层面:InnoDB 的缓冲池(Buffer Pool)以 16KB 页为基本单位缓存数据与索引。超长的高精度字段作为联合索引或查询条件时,单页容纳的索引节点数量减少超过 50%,导致 B+ 树层级更早增加,索引点查和范围扫描时需要载入更多的磁盘物理页,从而削弱了数据库的并发吞吐能力。
二、Python 应用层的冲击:Decimal 对象的序列化陷阱
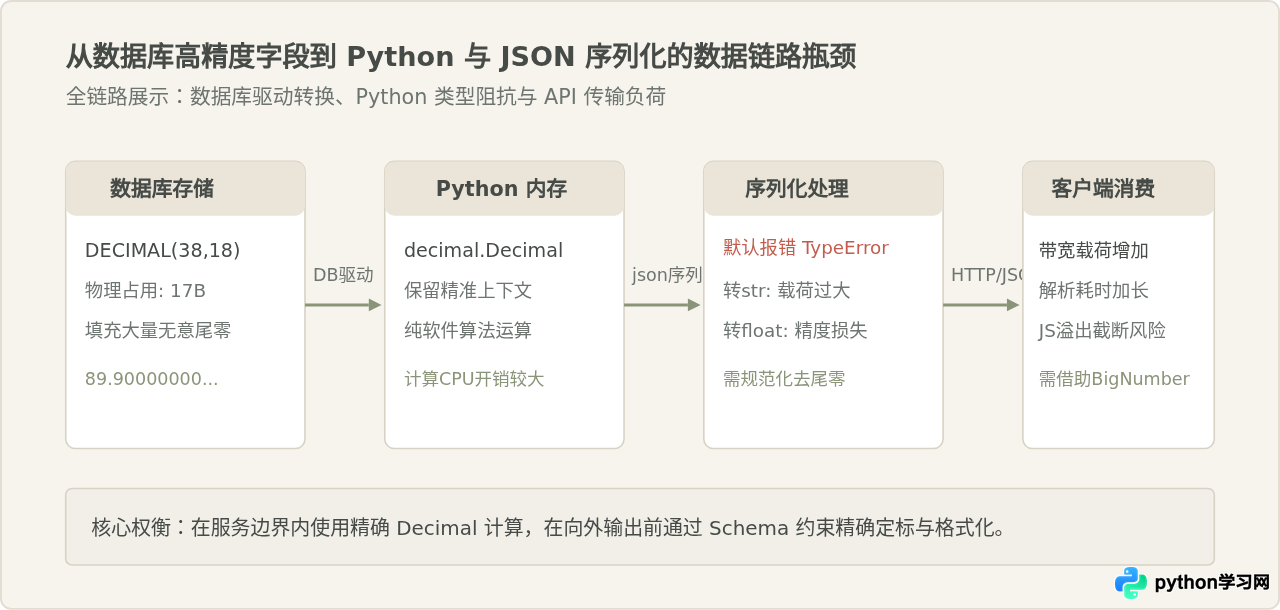
数据库存储只是第一道关口,当数据通过 Python 驱动(如 psycopg2、asyncpg、PyMySQL)查询出来后,驱动程序为了防止在向 Python 浮点数(float)转换时发生精度截断或二进制舍入误差,会严谨地将所有 DECIMAL 字段映射为 Python 标准库中的 decimal.Decimal 对象。
然而,Python 标准库的 json.dumps() 默认并不支持 Decimal 类型,直接执行会导致程序抛出异常:
import json
from decimal import Decimal

payload = {"order_id": 1001, "price": Decimal("89.900000000000000000")}

# 直接序列化会引发 TypeError
try:
    json.dumps(payload)
except TypeError as e:
    print(f"序列化失败: {e}")
    # 输出: 序列化失败: Object of type Decimal is not JSON serializable
面对这个报错,很多项目常常选择两种粗放的应对方案,而这两种方案都带来了明显的副作用:
-
方案 A:使用
default=str强制转为字符串。
这种做法虽能快速消除报错,但在 JSON 中会原封不动地保留高精度的全部尾零(例如"89.900000000000000000")。当 API 批量返回成百上千条记录时,冗长的尾零让 JSON 文本体积膨胀 200% 至 400%,既增加了网络带宽开销,也迫使前端消费方必须引入繁重的额外类型解析逻辑。 -
方案 B:使用
default=float强制转为浮点数。
该操作彻底颠覆了最初在数据库定义高精度定点数的初衷。IEEE 754 双精度浮点无法精确表示部分十进制小数,会导致类似0.1 + 0.2 = 0.30000000000000004的精度抖动,并可能在前端呈现给用户时造成对账误解。
三、常见认知偏差辨析:为什么“精度给足最稳妥”并不成立
这种观点在工程中十分常见,其合理之处在于:对于科学测量、加密货币原生单位(例如以太坊的 Wei,1 ETH = 10^18 Wei)或高频外汇利息结转,确实需要 18 位甚至更高的精确度。在未知业务扩展边界的前提下,超大范围看起来能够防御数值溢出。
然而在绝大多数常规商业系统中,这个说法必须得到修正:
- 定点数并非零成本伸缩:关系型数据库中定点数列的物理占用是根据声明的 (M, D) 参数提前确定的。即便字段只存了整数
100,存储和缓存依旧按定义的上限进行块划分与字节填充。 - 前端 JavaScript 的数值上限困境:即便后端使用高精度并序列化为数值输出,前端如果使用标准的
JSON.parse(),超过Number.MAX_SAFE_INTEGER(9007199254740991) 的数值就会发生截断或舍入错乱。 - Python 计算效率衰减:Python 的
Decimal算术是基于软件层面模拟的任意精度算法,其执行性能明显慢于依托 CPU 原生 ALU/FPU 硬件指令执行的整数和浮点数运算。
四、工程治理实战:从表结构设计到高性能序列化
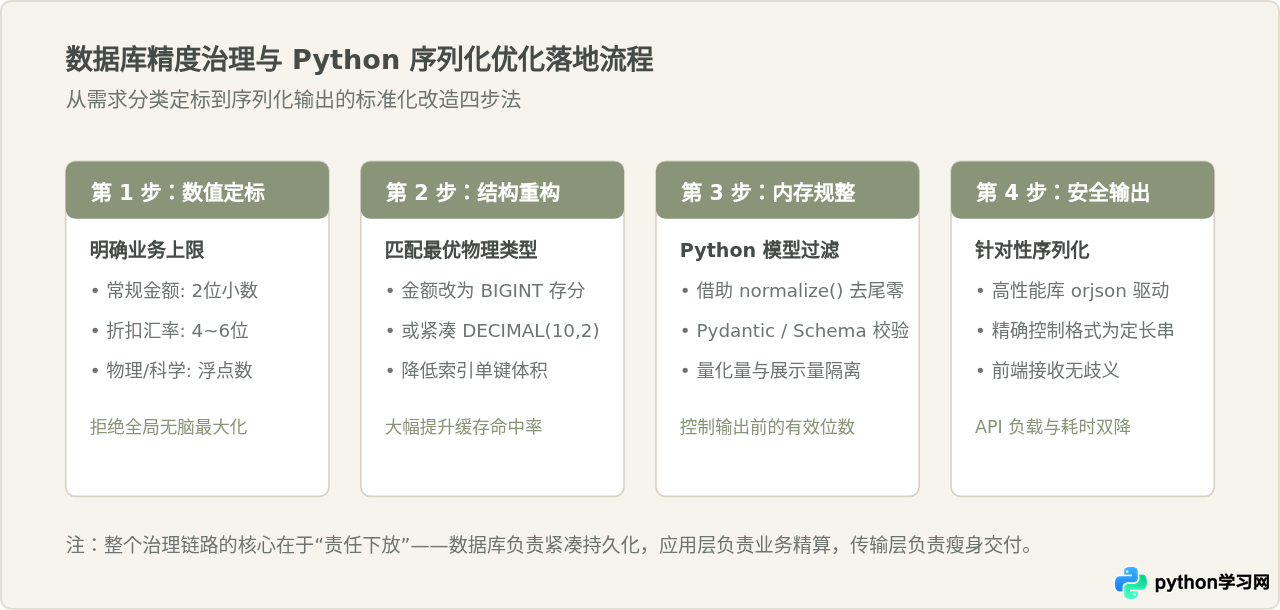
要根治不必要的高精度带来的负面影响,需要在数据库建模、业务模型层以及输出序列化层三个环节建立协同规范。
1. 数据库层方案:采用收紧的定点数或整数放大法
对于电商、仓储和一般的交易流水,首选推荐采用“分/厘为基准的整型存储(BIGINT)”。将单位定义为“分”(保留两位小数)或“厘”(保留三位小数),存取时通过简单的乘除常数完成转化。这不仅彻底规避了底层 DECIMAL 软件模拟的计算开销,还使索引大小从 17 字节直降到 8 字节,并且可以直接由原生 json.dumps() 极速编码。
若业务强依赖小数展示,应将字段定标收窄为真实需要的范围,例如 DECIMAL(12, 2),绝对避免无意义的超大精度声明。
2. Python 序列化层的规范实践
当数据库中因历史原因仍存在带有多余尾零的 Decimal 字段,或业务运算必须保持高定标时,在序列化输出至前端 API 前,应利用 Decimal.normalize() 去除无意义尾零,并结合专用编码器输出规范化格式:
import json
from decimal import Decimal

def serialize_decimal(val: Decimal, max_digits: int = 4) -> str:
    """
    去除无效尾零,并将科学计数法还原为标准定点字符串表示
    """
    if not isinstance(val, Decimal):
        raise TypeError(f"期望 Decimal 类型,收到 {type(val)}")

    # 规整化并去除无意义尾零
    normalized = val.normalize()
    # 转换为字符串并规避科学计数法展示
    sign, digits, exponent = normalized.as_tuple()
    if exponent >= 0:
        return str(normalized)

    # 超过预定有效位数的可按需定量控制
    return f"{normalized:f}"

# 示例数据对比
raw_data = {
    "sku": "A-8902",
    "cost_price": Decimal("129.500000000000000000"),
    "discount": Decimal("0.850000000000000000")
}

# 优化前粗暴方案:使用 default=str
loose_output = json.dumps(raw_data, default=str)
print("粗暴转换结果:", loose_output)
# 结果: {"sku": "A-8902", "cost_price": "129.500000000000000000", "discount": "0.850000000000000000"}

# 优化后:精确保留有效数字并剔除无效尾零
cleaned_data = {
    k: serialize_decimal(v) if isinstance(v, Decimal) else v
    for k, v in raw_data.items()
}
optimized_output = json.dumps(cleaned_data)
print("规范化结果:  ", optimized_output)
# 结果: {"sku": "A-8902", "cost_price": "129.5", "discount": "0.85"}
在生产环境中,推荐配合现代高性能 JSON 序列化库 orjson。orjson 原生支持通过 OPT_PASSTHROUGH_DECIMAL 选项自定义 Decimal 的编码策略,能带来数倍于标准库的吞吐量提升,且天然支持精准的内存直写。
五、选型与权衡决策指南
在日常系统重构和新表设计时,应根据数值的语义场景匹配最适宜的数据类型与序列化策略:
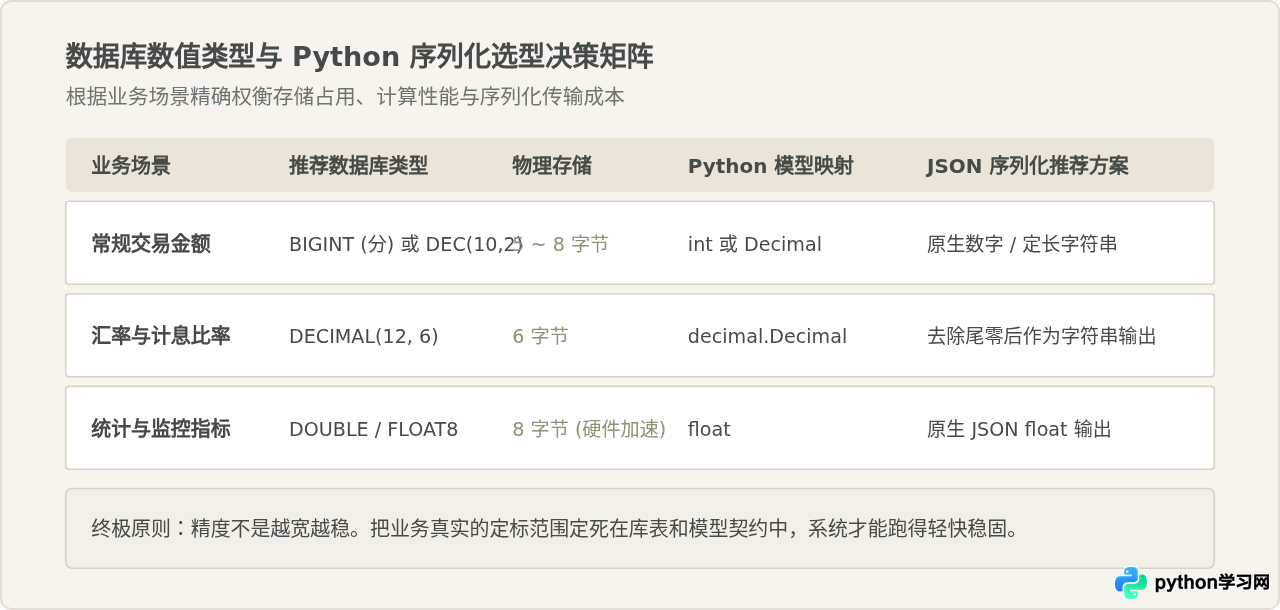
六、总结
数据库中的数值精度设计不应是随意的防御性妥协。过大的精度声明会使每条记录无谓膨胀,削弱 InnoDB 缓冲池的利用效率与 B+ 树的聚簇密度;进入 Python 环境后,Decimal 带来的不可原生序列化问题、粗暴转字符串带来的网络带宽浪费,以及潜在的浮点舍入隐患,都会转化为长期的系统维护负担。
通过在库表设计阶段严谨界定 DECIMAL 标度或使用 BIGINT 整数放大法,并在 Python API 层规范去尾零逻辑与高性能专用序列化器,我们不仅能够保证核心业务数值的绝对精准,还能让系统维持更优的吞吐量与极低的网络交互载荷。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















