


Python基础语法核心:变量、数据类型与控制流详解
全面解析Python基础语法的核心脉络,涵盖变量绑定机制、可变与不可变数据类型特征、条件分支与循环控制流的执行原理与实操避坑指南。
假设你正在编写一段脚本,用来统计一批电商订单的金额、筛选出超过规定额度的大额消费,并按照用户级别打上分类标记。在这一常见开发场景中,保存计算结果需要使用变量,描述订单明细需要搭配数值、字符串与列表等数据类型,而逐步检查订单状态并做出决策则完全仰赖条件分支与循环控制流。学好 Python 并不需要一开始就通读庞杂的标准库,理解“变量如何引用数据”、“不同类型在内存中的行为表现”以及“控制流如何调配程序走向”这三大支柱,即可搭建起稳固的编程逻辑骨架。
一、变量本质与内存引用模型
在许多编译型语言(如 C/C++)中,变量常被比作一个具有固定大小和类型的“抽屉”,赋值就是把数值放进抽屉里。但在 Python 的底层设计中,变量的本质是一个名称标签(Reference/Pointer),所有具体的数据(如整数、字符串、列表)都作为独立的对象存放在堆内存中。通过赋值操作符 =,你只是把一个名字贴到了某个对象上。
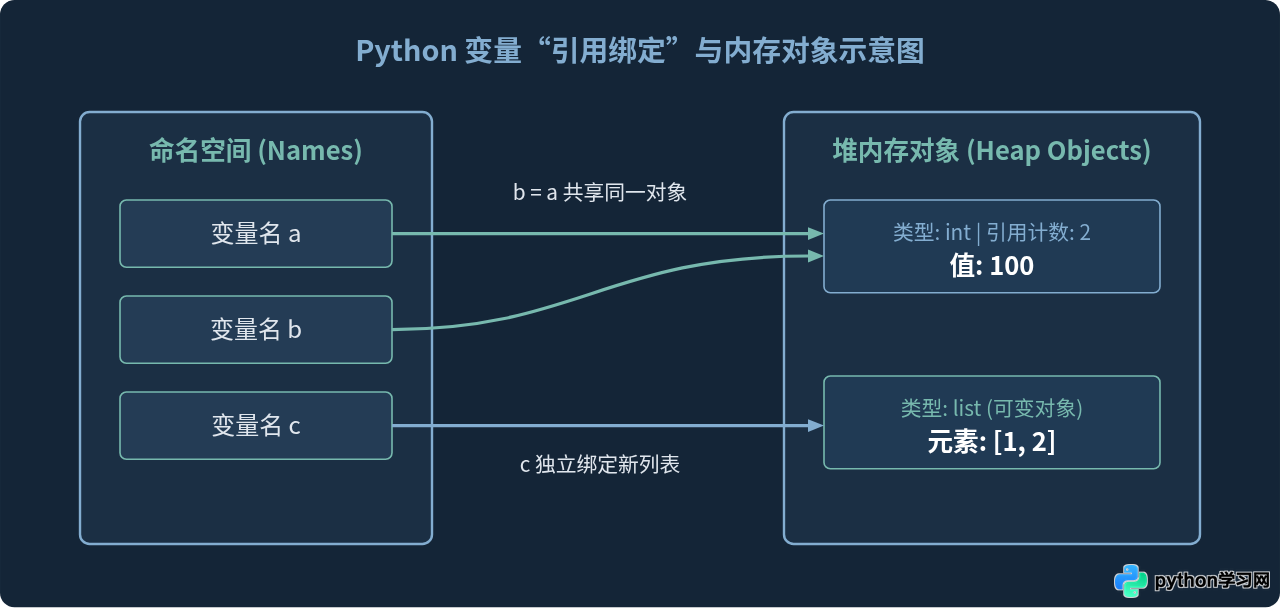
我们可以通过 Python 内置函数 id() 获取对象在内存中的唯一身份标识,以此验证引用机制:
# 引用绑定示例
a = 100
b = a

print("a 的内存地址:", id(a))  # 示例输出: 140728925430880
print("b 的内存地址:", id(b))  # 示例输出: 140728925430880 (地址完全相同)

# 对 a 进行重新赋值
a = a + 1
print("a 运算后的新地址:", id(a))  # 示例输出: 140728925430912 (生成了新对象 101)
print("b 的地址与值:", id(b), b) # 示例输出: 140728925430880, 值为 100避坑提示:由于 int 是不可变对象,执行 a = a + 1 时并不会修改原本 100 的内容,而是创建了新对象 101 并将变量名 a 重新绑定过去。变量 b 仍旧牢牢指向原来的 100。
二、核心数据类型分类与特征映射
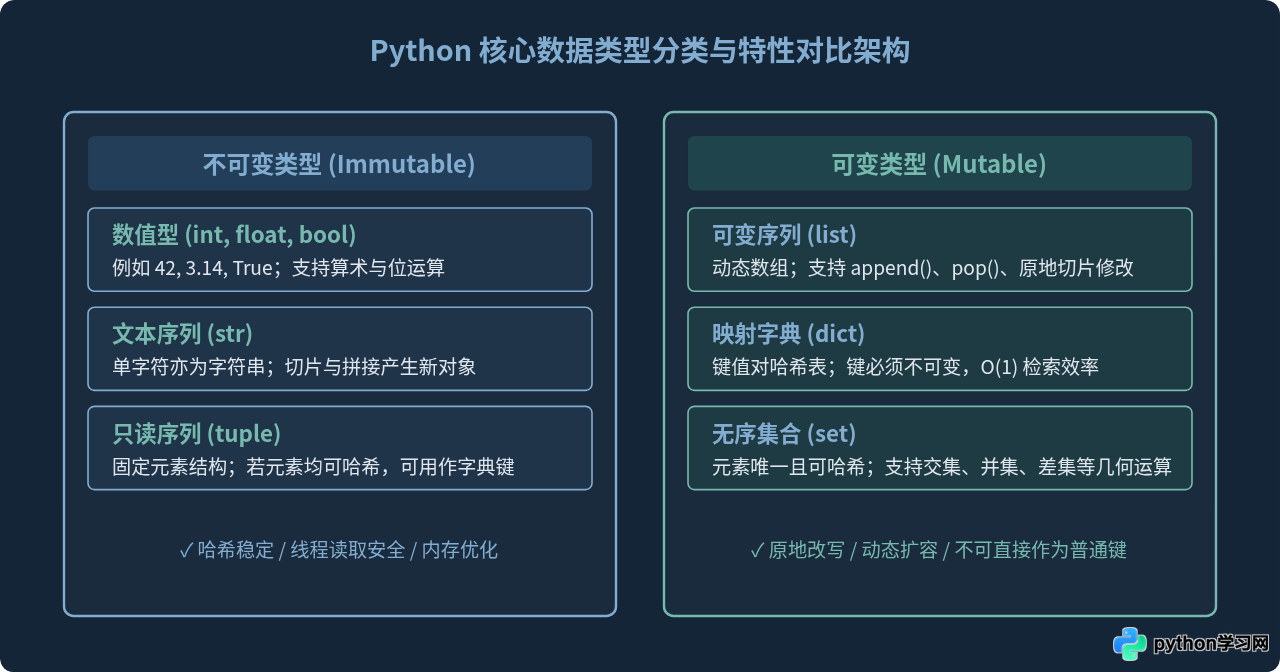
Python 中的数据类型繁多,但最根本的分类标准是可变性(Mutability)。数据类型是否可变,直接决定了其在函数传参、集合哈希以及字典键匹配中的行为特征。
1. 数据类型的典型操作示例
以下代码展示了不同数据类型的基础声明与常用操作:
# 1. 字符串与列表的基础转换
raw_input = "apple,banana,cherry"
fruits = raw_input.split(",")   # 拆分为 list: ['apple', 'banana', 'cherry']
fruits.append("orange")         # 原地扩容列表

# 2. 字典的使用与键的安全检索
user_profile = {
    "username": "alex",
    "role": "admin",
    "login_count": 5
}
# 推荐使用 get() 避免 KeyError
department = user_profile.get("department", "Default-Ops")

# 3. 集合快速去重
numbers = [1, 2, 2, 3, 4, 4, 5]
unique_numbers = set(numbers)   # 结果为 {1, 2, 3, 4, 5}
2. 可变对象的别名修改陷阱
当多个变量指向同一个可变对象(如列表或字典)时,通过其中一个变量修改内容,另一个变量看到的数据也会同步改变:
list_a = [10, 20, 30]
list_b = list_a                 # 共享同一列表对象的引用
list_b.append(40)               # 原地修改

print("list_a:", list_a)        # 输出: [10, 20, 30, 40]
print("list_b:", list_b)        # 输出: [10, 20, 30, 40]

# 若需要独立副本,应使用浅拷贝或深拷贝:
list_c = list_a.copy()          # 创建浅拷贝新对象
list_c.append(50)
print("list_a 保持不变:", list_a) # 输出: [10, 20, 30, 40]
print("list_c 独立新增:", list_c) # 输出: [10, 20, 30, 40, 50]
三、控制流机制:条件判断与循环执行
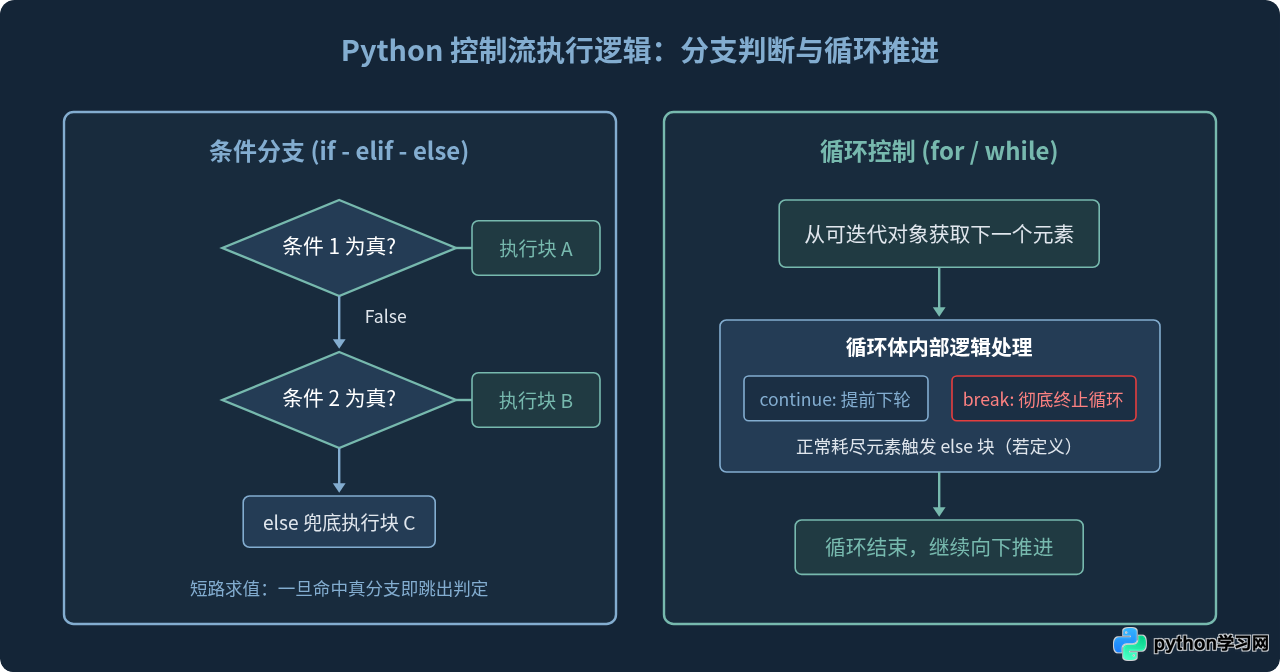
控制流决定了代码执行的先后顺序与条件分支。Python 通过严格的缩进(通常为4个空格)来界定代码块,替代了传统语言中的花括号。
1. 条件判断与短路求值
Python 的逻辑运算符包括 and、or、not。在计算布尔表达式时,Python 会利用短路求值(Short-circuit evaluation)提升效率并规避潜在异常:
# 短路求值示例
data = None

# 如果不使用短路,直接访问 data.get 会触发 AttributeError
if data is not None and data.get("status") == "success":
    print("请求处理成功")
else:
    print("数据为空或状态异常")  # 示例输出: 数据为空或状态异常
2. 循环结构:for、while 与 break/continue 控制
for 循环专为遍历序列或可迭代对象而生,而 while 循环适合在未知循环次数、仅依赖条件成立与否的场景下使用:
# 循环控制综合示例
batch_records = [85, -1, 92, 0, 78, 100, -5]
valid_sum = 0

for score in batch_records:
    if score < 0:
        print(f"检测到异常负值: {score},跳过本次处理")
        continue  # 跳过当前迭代,直接进入下一个循环

    if score == 100:
        print("检测到满分记录,触发预警并停止批处理")
        break     # 立即终止整个循环

    valid_sum += score

print("累计有效分数:", valid_sum)  # 示例输出: 累计有效分数: 255
循环的 else 子句特性:在 Python 中,for 或 while 循环后可以携带一个 else 语句块。只有当循环正常迭代完毕、未被 break 打断时,else 块才会执行。这在搜索目标元素的场景中非常优雅,无需额外维护布尔标记位。
四、综合实践:订单自动化分类与统计器
为了将变量引用、复合数据结构(列表套字典)与控制流机制融会贯通,我们实现一个精简的订单流自动化处理函数。该示例模拟真实业务场景中的数据过滤、累加及结构化归档:
# 订单自动化处理示例
orders = [
    {"order_id": 1001, "amount": 260.0, "status": "paid"},
    {"order_id": 1002, "amount": 0.0, "status": "canceled"},
    {"order_id": 1003, "amount": 890.5, "status": "paid"},
    {"order_id": 1004, "amount": 45.0, "status": "refunded"},
    {"order_id": 1005, "amount": 1200.0, "status": "paid"},
]

vip_threshold = 500.0
total_revenue = 0.0
categorized_orders = {
    "normal": [],
    "vip": []
}

for item in orders:
    # 状态过滤:仅统计已支付订单
    if item["status"] != "paid":
        continue

    amount = item["amount"]
    total_revenue += amount

    # 业务分流逻辑
    if amount >= vip_threshold:
        categorized_orders["vip"].append(item["order_id"])
    else:
        categorized_orders["normal"].append(item["order_id"])

print("已支付订单总营收: ¥", round(total_revenue, 2))
print("普通订单 ID 列表:", categorized_orders["normal"])
print("VIP 大额订单 ID 列表:", categorized_orders["vip"])

# 示例输出:
# 已支付订单总营收: ¥ 2350.5
# 普通订单 ID 列表: [1001]
# VIP 大额订单 ID 列表: [1003, 1005]
五、知识架构与核心避坑指南总结
掌握 Python 语法并不在于死记硬背每个 API,而在于建立一条清晰的逻辑推演路径:从“声明引用”到“选择数据类型”,再到“运用控制流编织执行路径”。
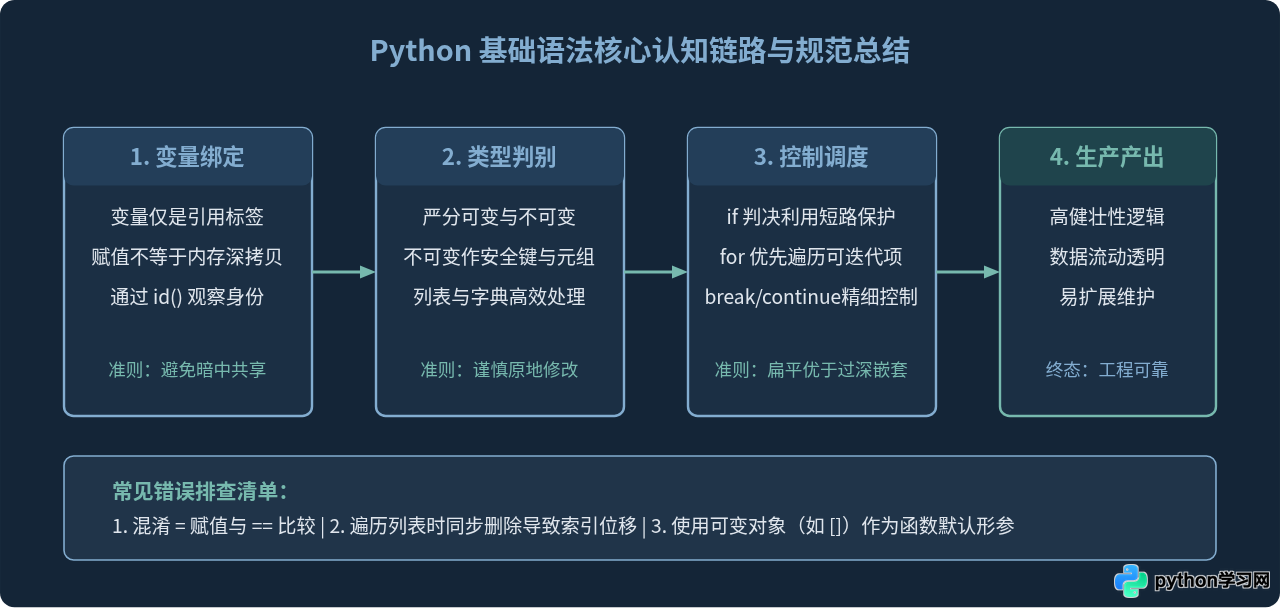
核心避坑总结表
| 语法模块 | 高频踩坑点 | 根本原因 | 推荐解决方案 |
|---|---|---|---|
| 变量与内存 | 函数内部修改入参列表影响了外部原数据 | 可变对象按引用传递,函数内操作的是同一份堆内存数据 | 传入副本 func(data.copy()) 或在函数内创建独立对象 |
| 数据类型 | 使用 dict[key] 频繁抛出 KeyError |
直接下标访问无法处理预期外的键缺失 | 改用 dict.get(key, default) 设置安全默认值 |
| 数据类型 | 尝试将列表作为字典的 Key 报错 TypeError: unhashable type |
可变对象内容随时变化,无法生成确定哈希值 | 将列表转换为元组 tuple(my_list) 后再作为键 |
| 控制流 | 在 for item in list 循环体内直接执行 list.remove(item) |
删除元素引起底层数组长度和游标偏移,产生漏检现象 | 使用列表推导式生成新列表,或逆序遍历 reversed(list) |
| 控制流 | while 循环条件中的递增变量遗漏导致死循环 |
终止条件永远无法满足,占满单核 CPU | 优先使用有界 for 循环,或在 while 顶部明确步进机制 |
掌握了变量的引用模型、理清了可变与不可变类型的适用边界,并熟练运用条件分支与循环控制,你便已经打通了 Python 编程最关键的核心脉络。以此为基石,后续深入学习面向对象、生成器、装饰器以及各类第三方工程框架时,都能顺理成章、事半功倍。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















