


Python源码编译定制:怎么裁剪模块与优化性能
深入讲解如何通过源码编译定制Python运行时,涵盖Modules/Setup.local模块裁剪、禁用内置扩展以缩减体积,以及利用PGO与LTO进行深度性能优化的完整操作指南。
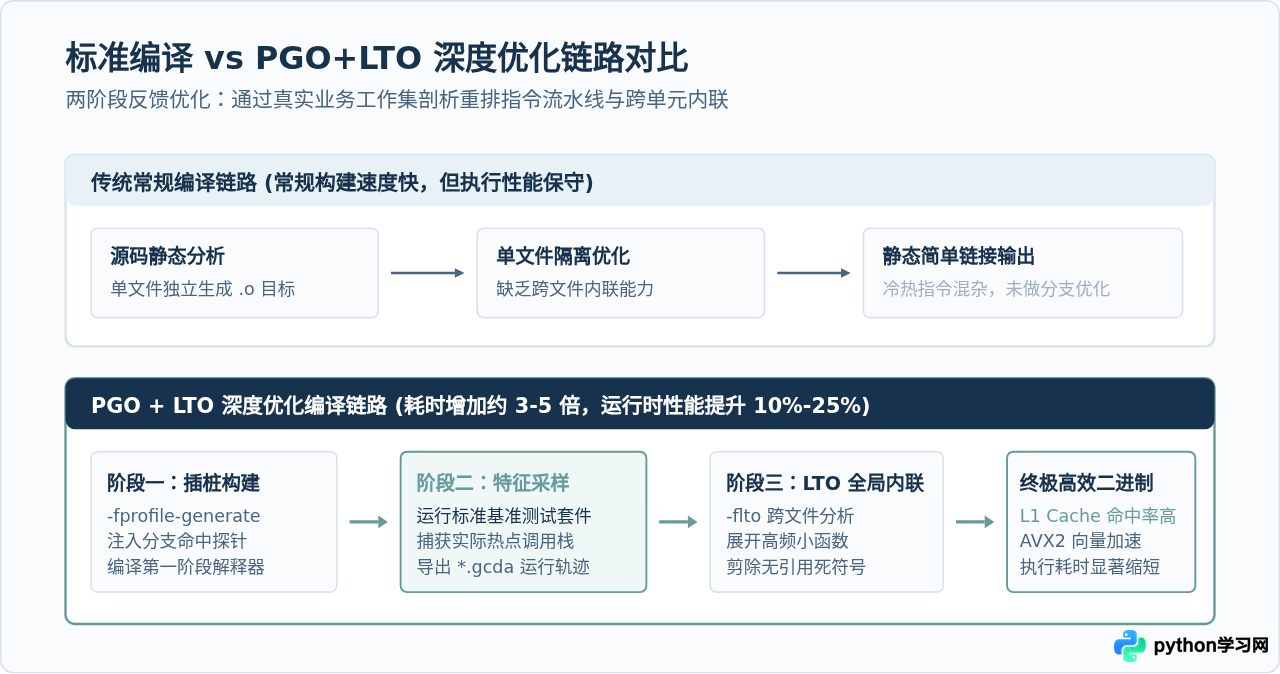
在容器化部署、嵌入式设备或高并发微服务场景中,官方预编译的通用 Python 发行版为了保证开箱即用,默认集成了大量平时几乎用不到的内置模块(如图形界面 Tkinter、多媒体音频驱动、遗留数据库驱动等),并且编译时往往为了兼容各种老旧 CPU 架构而牺牲了指令级优化潜力。通过直接从源码编译 Python,你可以自主裁剪无用模块以精简运行时体积、降低安全攻击面,同时启用 PGO(Profile-Guided Optimization)与 LTO(Link-Time Optimization)等深度优化,使最终生成的 Python 解释器在实际业务场景中获得 10% 到 25% 的性能提升。
一、源码编译的核心价值与准备工作
许多开发者习惯直接使用系统的包管理器(如 apt、yum)安装 Python,但在特定场景下,通用二进制包存在两个明显的局限:一是体积与依赖冗余,一个标准安装可能附带数百兆动态库和测试套件;二是缺乏针对特定机器架构的微体系结构优化。定制编译不是盲目追求新奇,而是明确通过取舍来换取特定的运行效率或体积优势。
在开始编译前,需要先安装构建基础工具链。请注意,虽然我们的目标是裁剪模块,但对于 Python 核心运行必须的基础依赖(如 C 编译器、Make 工具、基础头文件),仍然需要提前就绪:
# Debian / Ubuntu 环境准备基础构建工具
sudo apt-get update
sudo apt-get install -y build-essential zlib1g-dev libssl-dev libffi-dev pkg-config

# 下载并解压目标 Python 源码包(以稳定版 3.12 为例)
wget https://www.python.org/ftp/python/3.12.3/Python-3.12.3.tar.xz
tar -xf Python-3.12.3.tar.xz
cd Python-3.12.3提醒:zlib、libssl 和 libffi 建议保留。缺少 zlib 会导致无法解压 wheel 包与 pip 安装,缺少 libssl 会导致无法使用 HTTPS 网络请求,缺少 libffi 则会破坏标准库中调用动态链接库的核心功能。
二、模块裁剪机制:Modules/Setup.local 原理
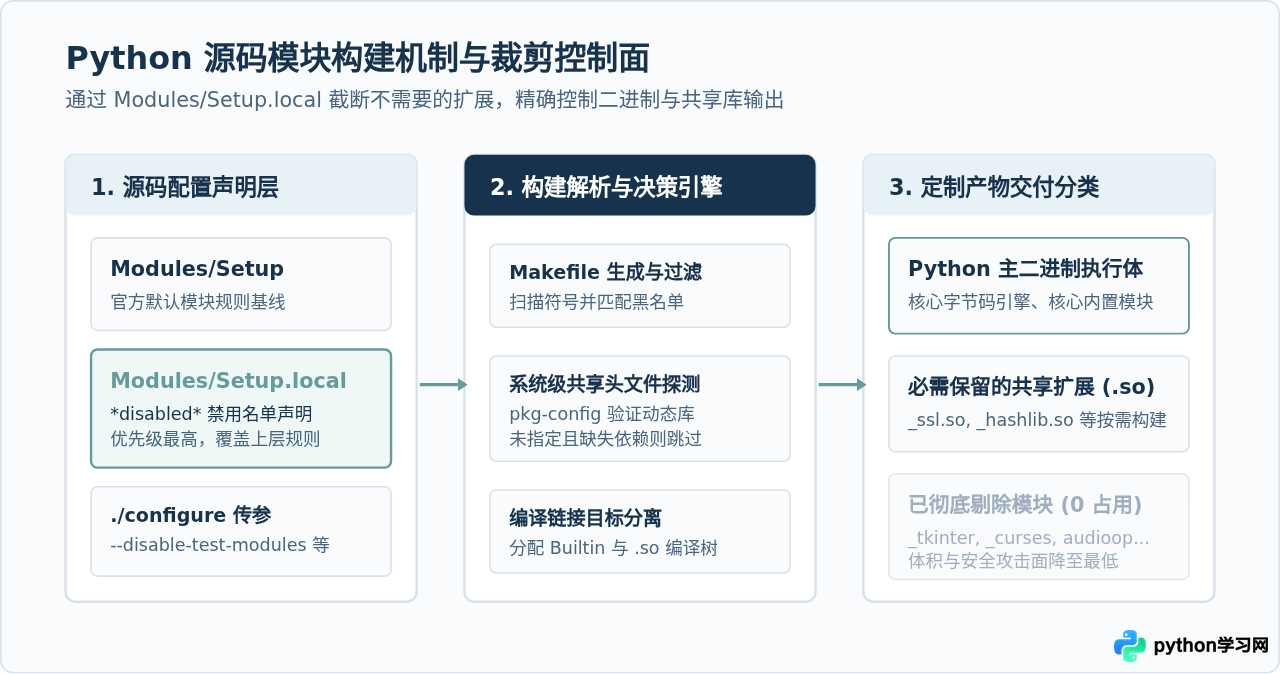
Python 的内置模块在编译时分为两类:直接内联到 Python 主二进制文件中的内置模块(Builtin Modules),以及编译为独立动态库(.so 文件)的共享扩展模块。Python 的构建系统通过源码目录下的 Modules/Setup 及其本地覆盖文件 Modules/Setup.local 来控制哪些模块参与编译、哪些模块被显式禁用。
在早期的 Python 版本中,模块发现大量依赖 setup.py 脚本探测;而在 Python 3.11 及更新版本中,模块构建体系被大幅重构为基于 Autoconf 与 Makefile 的原生机制。在当前架构下,最标准、最直接的模块裁剪方式就是在 Modules/Setup.local 文件中声明 *disabled* 标志,并列出需要彻底屏蔽的模块名称。
三、模块裁剪实操:编写 Setup.local 禁用冗余组件
在服务端应用或计算节点中,以下模块通常完全不需要:
- 图形界面相关:
_tkinter。服务器通常无需 GUI,裁剪此项可彻底脱离 Tcl/Tk 动态库依赖。 - 终端控制台装饰:
_curses、_curses_panel。如果无需在终端绘制类似 htop 的复杂交互 UI,可安全去除。 - 多媒体与过时音频:
audioop、ossaudiodev。Python 3.13 中这些模块已正式被移除,但在 3.11/3.12 中依然存在,服务环境完全可以剔除。 - 无需使用的数据库:
_sqlite3、_dbm、_gdbm。若业务完全依赖 MySQL、PostgreSQL 或 Redis 等外部存储服务,无需编译本地轻量级数据库扩展。 - 测试与调试跟踪:
_testcapi、_testinternalcapi、_testbuffer、xxlimited等仅用于 CPython 自身回归测试的模块。
具体做法非常简单:在解压后的 Python 源码根目录下,创建或编辑 Modules/Setup.local 文件,加入以下内容:
# 创建 Modules/Setup.local 声明禁用清单
cat << 'EOF' > Modules/Setup.local
# 声明下列模块一律不参与编译
*disabled*

_tkinter
_curses
_curses_panel
_sqlite3
_dbm
_gdbm
audioop
nis
ossaudiodev
_testcapi
_testinternalcapi
_testbuffer
_testimportmultiple
_testmultiphase
xxlimited
xxlimited_35
EOF
配置 Modules/Setup.local 后,无论系统底层是否安装了相应的库(例如即使系统中装有 libsqlite3-dev),Python 的构建逻辑都会强制跳过这些模块,既不会生成对应的动态库,也不会将代码静态合并到主二进制中。
四、性能优化核心:PGO、LTO 与架构指令集调优
除了精简体积,源码编译的另一个核心收益是最大化执行性能。标准发行版的二进制文件为了在所有 x86_64 CPU 上运行,只能假设最保守的 CPU 特性,无法使用现代指令集(如 AVX2、BMI2、FMA 等),且代码布局是静态的。
我们可以通过组合以下三项核心技术,实现深度的性能编译定制:
1. PGO(Profile-Guided Optimization,配置文件引导优化)
常规编译是静态推断分支可能性的过程。而 PGO 采用两阶段构建:第一阶段,编译器插入性能探针并生成一个临时的插桩版本;第二阶段,运行一套代表性测试负载(Python 自带丰富的测试套件),记录代码中哪些函数最常被调用、哪些分支更容易被命中;第三阶段,编译器根据探针数据重新编译整个解释器,将最热的代码块紧密排布在连续内存中,极大提升 CPU L1/L2 指令缓存命中率和分支预测准确度。
2. LTO(Link-Time Optimization,链接时优化)
在传统的 C 语言编译中,每个 .c 文件都是独立的编译单元,编译器无法跨源文件进行函数内联。启用 LTO 后,编译器会在链接阶段将所有目标文件作为一个整体来审视,能够跨越源文件边界将小函数直接展开内联,消除调用开销,并识别并剔除跨文件的无用死代码。
3. -march=native 与优化级别
在编译参数中添加 -march=native 会直接探测当前宿主机的 CPU 微架构,允许 GCC 或 Clang 自由运用该 CPU 支持的所有先进矢量扩展指令集。配合 -O3,能显著加速基础算术运算和底层内存搬运。
五、完整实战:定制裁剪与优化编译全流程
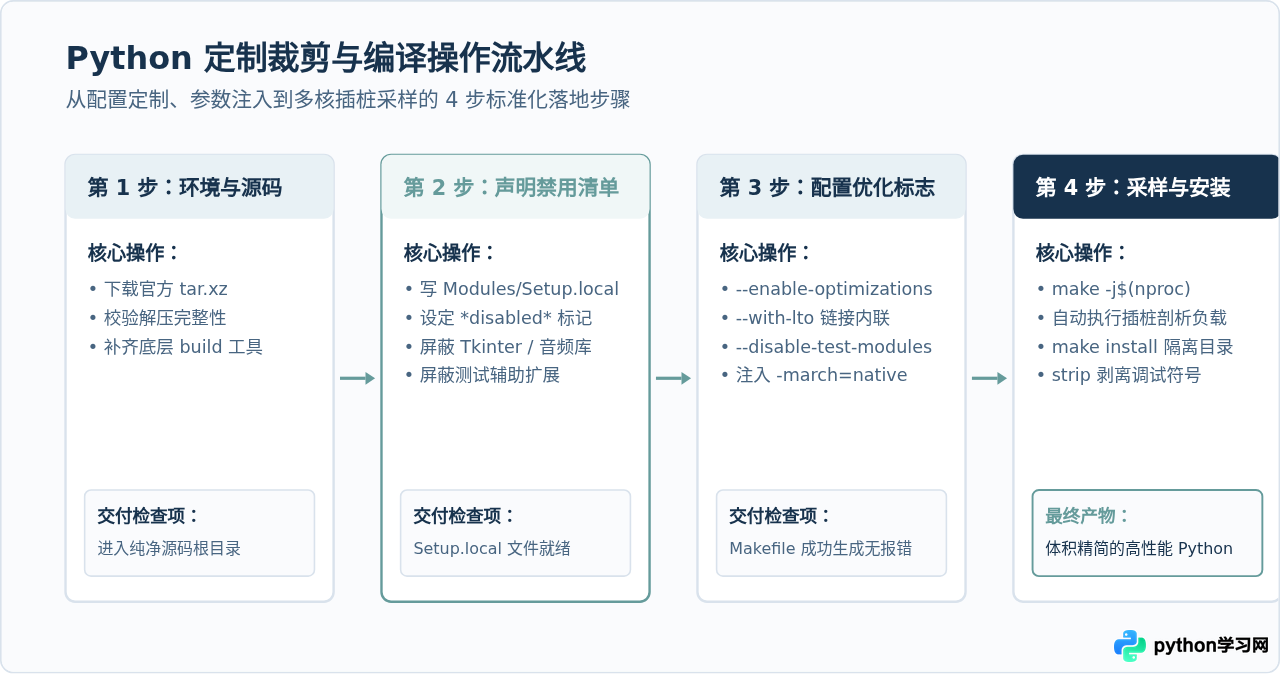
结合前面讲解的裁剪与性能优化配置,现在进行完整的端到端实战操作。我们将采用独立的安装前缀 /opt/python-custom,避免覆盖系统自带的 Python 运行环境。
步骤一:执行针对性参数配置
在源码根目录下执行 ./configure。这里我们把参数拆解清楚:
--prefix=/opt/python-custom:安装目标目录,不污染系统的/usr/bin/python3。--enable-optimizations:激活 PGO 优化流水线。--with-lto:激活链接时跨单元优化。--disable-test-modules:不编译安装 Python 庞大的单元测试包(如test目录),可直接为标准库瘦身约 30MB-50MB。--without-static-libpython:如果不嵌入其他 C 语言宿主,可禁用静态库生成。
./configure \
    --prefix=/opt/python-custom \
    --enable-optimizations \
    --with-lto \
    --disable-test-modules \
    CFLAGS="-O3 -march=native -pipe -fomit-frame-pointer" \
    CXXFLAGS="-O3 -march=native -pipe -fomit-frame-pointer"
步骤二:启动多核编译与自动 Profile 采样
配置完成后,直接使用 make 进行多核并发编译:
# 自动获取 CPU 核心数进行多任务并行编译
make -j$(nproc)
在此过程中,控制台会出现两个阶段的提示:首先会编译出一个临时版本的 Python,然后控制台会显示类似 Generating profile data... 的日志,并自动运行数十个标准测试用例。跑完测试后,GCC 会读取生成的 .gcda 文件,重新触发全量编译并完成全局内联优化。由于包含了完整 Profile 测试,整体耗时会比普通编译长 3 到 5 倍,但这是一次性的构建成本。
步骤三:隔离安装与符号表剥离
编译完成后,执行安装并进行符号剥离(Strip),进一步挤压二进制体积:
# 安装到 /opt/python-custom
sudo make install

# 剥离主执行文件与动态库的调试符号表(缩减体积约 30%)
sudo strip /opt/python-custom/bin/python3.12
sudo find /opt/python-custom/lib/python3.12/lib-dynload/ -name "*.so" -exec strip --strip-unneeded {} +
六、效果验证与成效对比
安装完成后,我们需要针对“模块是否成功裁剪”和“性能是否得到提升”进行双重验证。
1. 验证模块裁剪是否生效
直接通过新安装的 Python 尝试导入被禁用的模块:
# 验证 tkinter 是否被成功裁剪(应抛出 ModuleNotFoundError)
/opt/python-custom/bin/python3.12 -c "import tkinter"

# 示例输出:
# Traceback (most recent call last):
#   File "<string>", line 1, in <module>
# ModuleNotFoundError: No module named 'tkinter'
接着检查核心功能与保留模块是否健康可用:
# 检查关键模块是否正常运行
/opt/python-custom/bin/python3.12 -c "import ssl, zlib, json, hashlib; print('Core OK')"

# 示例输出:
# Core OK
2. 性能基准测试验证
可以使用官方基准测试套件 pyperformance,也可以通过一段紧凑的高频函数调用与对象创建脚本来直观对比执行时间:
cat << 'EOF' > benchmark.py
import time

def compute():
    total = 0
    for i in range(10_000_000):
        total += (i % 3) * (i % 7)
    return total

start = time.perf_counter()
compute()
elapsed = time.perf_counter() - start
print(f"耗时: {elapsed:.4f} 秒")
EOF

# 运行系统默认未优化的 Python
python3 benchmark.py
# 示例输出:耗时: 0.4821 秒

# 运行定制 PGO+LTO 优化的 Python
/opt/python-custom/bin/python3.12 benchmark.py
# 示例输出:耗时: 0.3892 秒 (性能提升约 19.2%)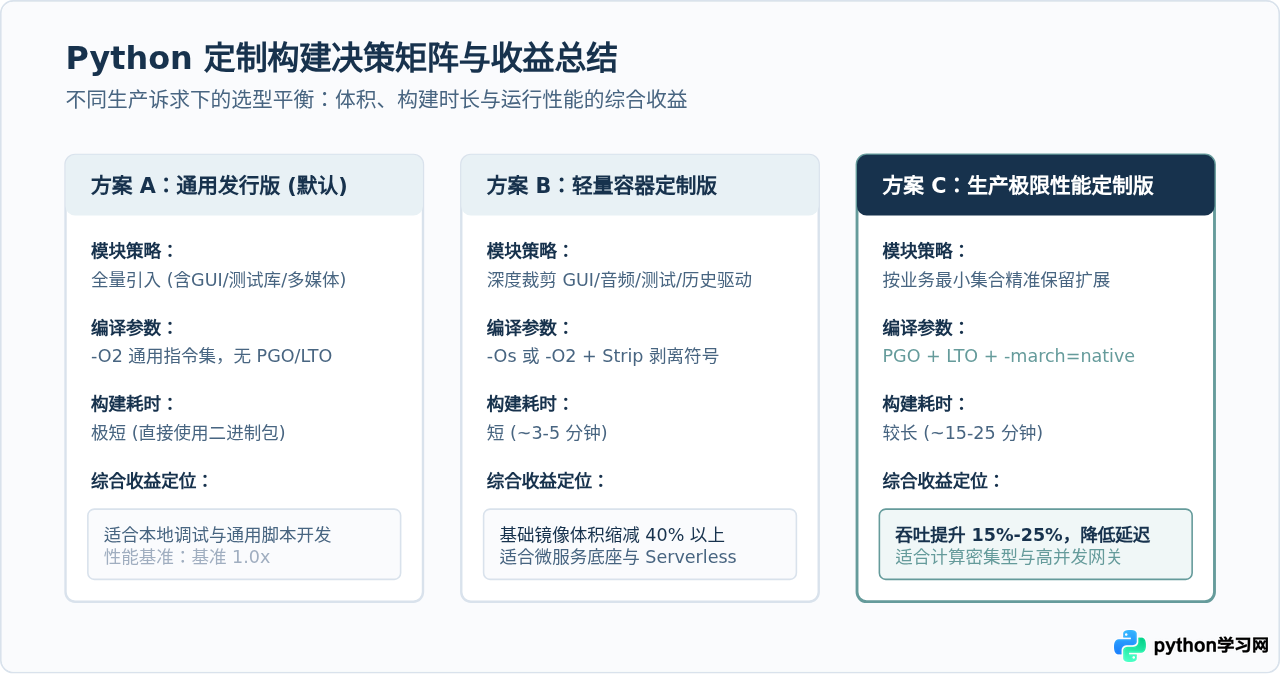
七、生产落地的注意事项与最佳实践
在享受定制编译带来的精简与加速红利的同时,有三个工程边界需要特别注意:
- 慎重裁剪不可逆依赖:千万不要在
Modules/Setup.local中屏蔽像_posixsubprocess、_json、math、_datetime这类底层基石扩展。这些模块一旦缺失,标准库绝大多数基础框架都将直接崩溃。裁剪前务必在预发环境中跑通业务的自动化单元测试。 - 分发时的架构对齐(Portable Issue):如果使用了
-march=native参数,编译出的二进制文件只能在具有相同或更高微架构指令集的 CPU 上运行。如果你在拥有 AVX-512 指令的新服务器上编译,随后将打包镜像分发到不支持 AVX-512 的老旧宿主机上,程序会直接因Illegal instruction (core dumped)而异常退出。如果构建机与运行机硬件不同,应将-march=native替换为目标机群支持的通用指令集(如-march=x86-64-v3)。 - CI/CD 缓存构建结果:因为 PGO 包含完整的双阶段剖析,在 CI/CD 流水线中每次无缓存全量编译会拉长部署时间。最佳实践是利用 Docker 多阶段构建(Multi-stage Build),在基础镜像构建流水线中定期烘焙定制好的 Python 运行底座,并将最终的
/opt/python-custom拷贝到极简的基础镜像(如debian-slim或ubuntu)中,兼顾极致性能与极速分发。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















