


Python常用字符串方法指南:split、join与replace用法
系统讲解Python中最常用的三个字符串处理方法:split、join与replace。深入分析参数细节、底层工作机制、字符串不可变性以及常见边界陷阱,并提供丰富的工程示例。
split()、join() 与 replace() 分别承担了将单值解构为集合、将序列聚合成字符串以及在原模式上局部更新的核心职责。掌握三者的参数边界、底层不可变性原理与配合范式,能够有效避免隐藏的数据清洗缺陷并写出性能更优的代码。
一、split():字符串解构与切分控制
split() 方法用于将一个完整的字符串按照指定规则拆分为多个子字符串,并以列表(list)的形式返回。掌握该方法的核心在于理解其两个参数:sep(分隔符)和 maxsplit(最大拆分次数)。
1. 基础语法与核心参数
str.split(sep=None, maxsplit=-1)- sep(分隔符):指定用于拆分的字符或字符串。如果未指定或传入
None,Python 将启动“连续空白折叠算法”。 - maxsplit(最大拆分次数):指定最多执行多少次拆分。默认值为
-1,表示不限制拆分次数;若传入正整数N,则最终返回的列表中最多包含N + 1个元素。
2. sep=None 与指定字符分隔符的关键差异
这是初学者最容易踩坑的边界行为:不传 sep 与显式传入 sep=' '(单个空格)存在本质区别。
- 默认
sep=None:会自动将连续的任意空白字符(包括空格、制表符\t、换行符\n)视为一个整体分隔符,并且会自动丢弃字符串首尾的所有空白。 - 显式指定
sep=' ':严格执行单空格匹配。如果遇到连续两个空格,中间将被视为空字符串""并保留在结果中;同时首尾的空格也会导致切分出空字符串。
# 默认 sep=None:自动忽略首尾空白,折叠连续空白
text_a = "   Python    is    concise   "
print(text_a.split())
# 示例输出: ['Python', 'is', 'concise']

# 显式指定 sep=' ':严格按单空格切分,产生空字符串项
print(text_a.split(' '))
# 示例输出: ['', '', '', 'Python', '', '', '', 'is', '', '', '', 'concise', '', '', '']
3. 利用 maxsplit 控制拆分深度
在解析配置项、日志行或键值对时,往往只需要提取前面的固定字段,而将剩余的整段内容原封不动地保留。此时通过 maxsplit 可以高效完成提取,避免拆分过多产生冗余项。
# 典型场景:解析冒号分隔的日志记录(时间:级别:详细信息,详细信息本身可能含冒号)
log_entry = "2026-10-17 08:30:00:INFO:User connection failed: timeout after 30s"
parts = log_entry.split(':', maxsplit=2)
print(parts)
# 示例输出: ['2026-10-17 08', 'INFO', 'User connection failed: timeout after 30s']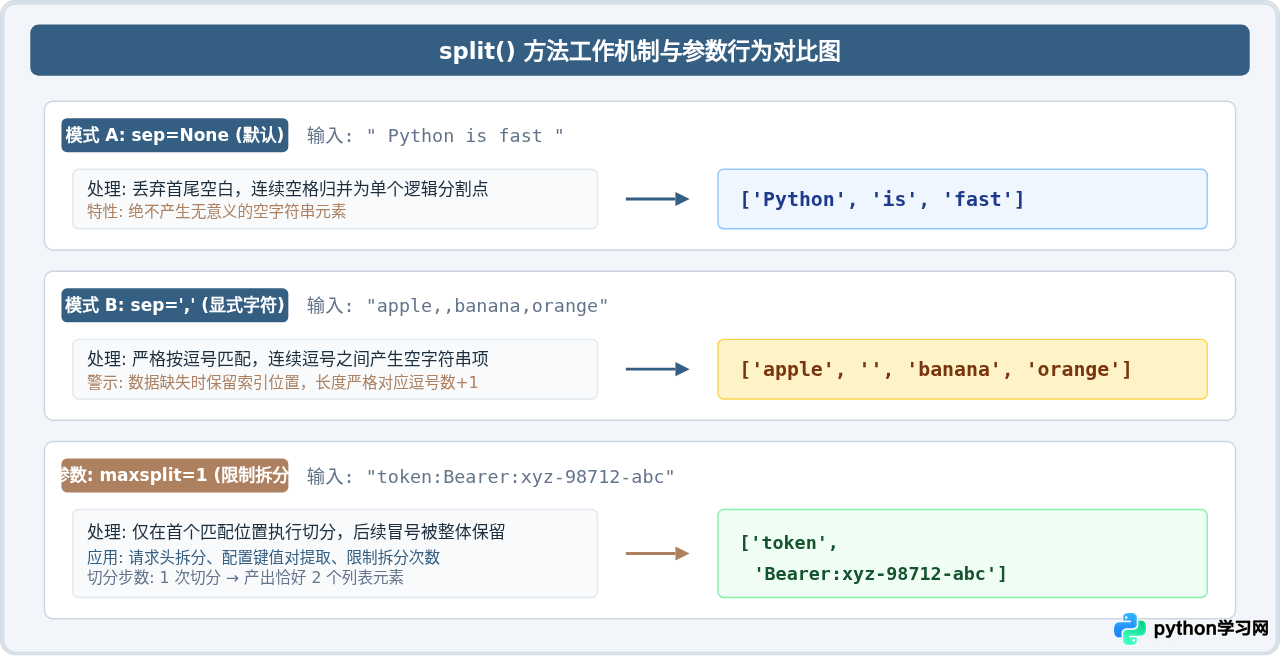
二、join():序列聚合与高效字符串构造
join() 方法是 split() 的逆操作,用于将包含多个字符串的可迭代对象(如列表、元组、集合)连接为一个由指定分隔符串联的新字符串。
1. 为什么是 sep.join(iterable) 而不是 list.join(sep)?
许多初学者容易对 join() 的调用语法感到困惑。Python 将其设计为字符串对象的方法,主要有两大原因:
- 通用可迭代支持:
join()的参数可以是任何可迭代对象(列表、元组、生成器表达式、集合等),而不局限于列表。如果绑定在列表类上,元组和生成器就无法直接复用。 - 连接符本身是字符串:调用主体是作为粘合剂的“分隔符字符串”(哪怕是空字符串
""),由它来决定如何组装传入的数据序列。
sep = ", "
items = ["Python", "Rust", "Go"]
result = sep.join(items)
print(result)
# 示例输出: Python, Rust, Go
2. 严格的类型约束(TypeError 规避)
join() 要求可迭代对象内部的所有元素必须是字符串类型(str)。若序列中存在数字、布尔值或 None,解释器会立即抛出 TypeError: sequence item X: expected str instance, Y found。
raw_numbers = [101, 204, 308, 404]

# 错误写法:直接调用将引发异常
# result = "-".join(raw_numbers)  # 抛出 TypeError

# 正确写法:使用生成器表达式或 map 进行预处理类型转换
result = "-".join(str(num) for num in raw_numbers)
print(result)
# 示例输出: 101-204-308-404
3. 性能深度:为什么避免在循环中使用加号(+)拼接?
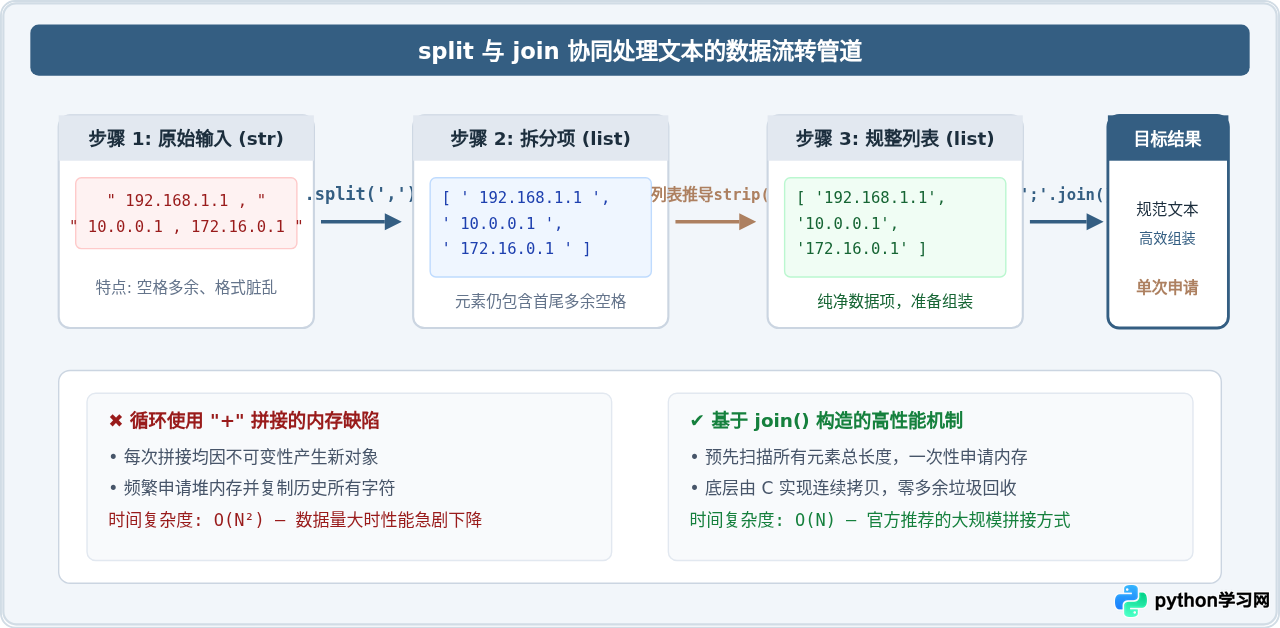
在 Python 中,字符串属于不可变对象。每次使用 + 操作符拼接两个字符串时,操作系统必须分配一块全新的内存,并将原有字符串和新字符串的内容完整拷贝进去。在长循环中累计拼接会造成高达 O(N^2) 的时间复杂度。
相比之下,join() 会先在底层统一计算所有子字符串的总长度,一次性申请足额内存空间,然后顺序填入各元素与分隔符,时间复杂度为线性的 O(N)。因此,在大批量数据重组时,将数据暂存至列表中最后调用 join() 是标准的最佳实践。
三、replace():模式替换与不可变性认知
replace() 方法用于检索并替换字符串中的指定子串。由于 Python 字符串是不可变(immutable)对象,理解该方法运行机制的核心在于明确:它永远不会修改原字符串,而是构建并返回一个全新的字符串对象。
1. 基础语法与核心参数
str.replace(old, new[, count])- old:被替换的目标子字符串。
- new:用于替换的新子字符串。
- count(可选):替换的最大次数。默认替换全部匹配项;若指定具体数值,则仅替换前
count次出现的目标。
2. 致命误区:忽略返回值
在其他某些语言中(如存在字符数组的原地修改),开发者可能习惯了直接调用方法。但在 Python 中,如果不将 replace() 的结果重新赋给变量,该操作将没有任何效果。
sentence = "hello world, hello Python"

# 错误示范:没有接收返回值
sentence.replace("hello", "hi")
print(sentence)
# 示例输出仍为: hello world, hello Python

# 正确示范:接收新创建的字符串对象
updated_sentence = sentence.replace("hello", "hi")
print(updated_sentence)
# 示例输出: hi world, hi Python
3. 使用 count 参数进行精确替换
当需要更新格式标记或仅替换首次出现的关键词时,count 参数非常关键。例如仅将第一个版本号更新,或替换首个分隔符以做局部标记。
path_url = "https://example.com/api/v1/user/v1/profile"

# 仅替换首个匹配的 'v1' 为 'v2',避免误伤后面的字段
new_url = path_url.replace("v1", "v2", 1)
print(new_url)
# 示例输出: https://example.com/api/v2/user/v1/profile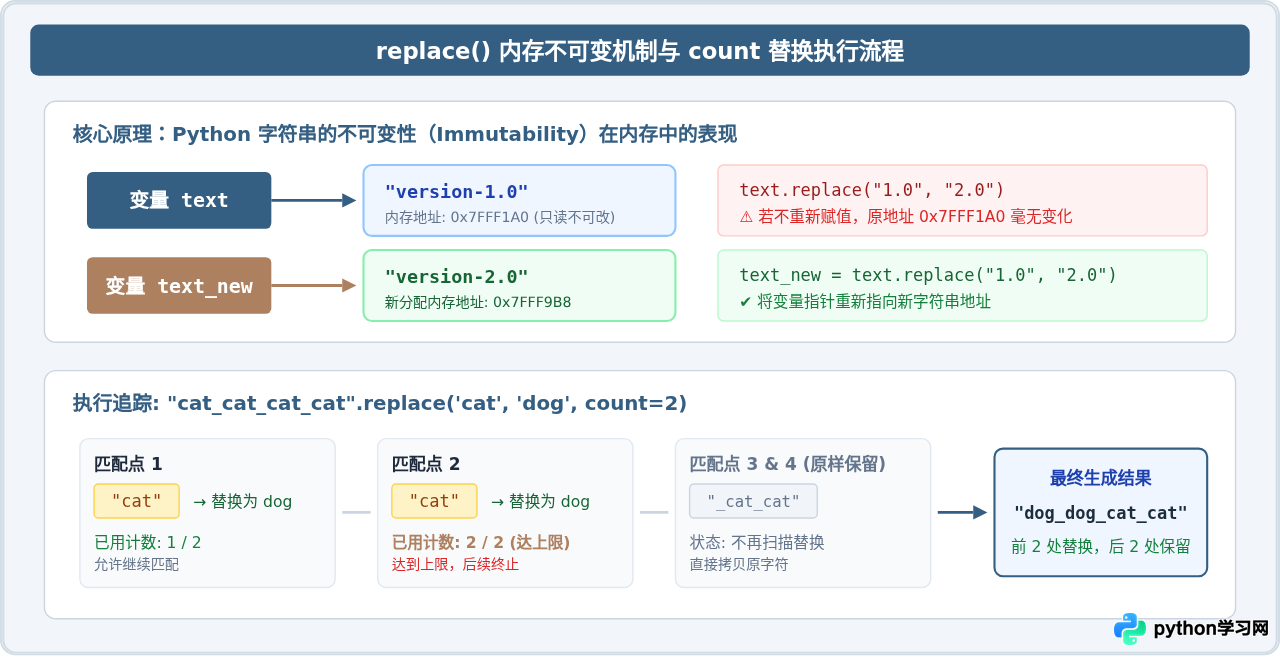
四、综合工程实战:三大方法的组合应用
在真实项目中,单一方法往往不足以解决复杂的格式清洗问题。通过将 split、join 与 replace 组合使用,可以以极简洁的代码实现健壮的数据清洗流。
场景一:规范化多重不规则空白
在处理网页爬虫抓取的正文或用户输入的文本时,经常存在大量空格、制表符与换行混杂的情况。最 Pythonic 的清洗方式便是利用 split() 自动折叠空白,再通过 join() 使用单一标准空格拼接。
raw_input = "  数据采集   \t\n  包含 多余空格   与制表符   "

# 优雅清洗:先 split() 丢弃所有形式的不规则空白,再用单空格 join()
normalized = " ".join(raw_input.split())
print(normalized)
# 示例输出: 数据采集 包含 多余空格 与制表符
场景二:URL 查询参数解析与规范化重构
在没有第三方库的环境下快速提取和格式化查询参数字符串:
query_string = "tag=python&sort=recent&page=1&filter=active"

# 步骤 1: split('&') 将键值对分离
param_pairs = query_string.split("&")

# 步骤 2: 解析为字典以便处理
params = {}
for pair in param_pairs:
    if "=" in pair:
        key, value = pair.split("=", 1)
        params[key] = value

# 步骤 3: 业务修改与重新组合(将 sort 改为 popular,并加入新参数)
params["sort"] = "popular"
params["verified"] = "true"

# 步骤 4: join 重构为标准查询字符串
rebuilt_query = "&".join(f"{k}={v}" for k, v in params.items())
print(rebuilt_query)
# 示例输出: tag=python&sort=popular&page=1&filter=active&verified=true
场景三:简单模板变量的安全替换
虽然复杂模板通常借助 jinja2 或格式化字符串,但在一些配置渲染中,使用 replace 具备极高的直观性与确定性。
template = "Dear {user}, your verify code is {code}. Valid for {minutes} min."

replacements = {
    "{user}": "Alice",
    "{code}": "839201",
    "{minutes}": "5"
}

rendered = template
for placeholder, value in replacements.items():
    rendered = rendered.replace(placeholder, value)

print(rendered)
# 示例输出: Dear Alice, your verify code is 839201. Valid for 5 min.
五、核心方法速查对比与选型指南
在选择具体方法时,可以根据输入输出的数据形态进行快速判断。下表总结了三个方法的关键特性:
| 方法 | 调用主体 | 输入参数核心 | 返回值 | 典型应用场景 | 主要避坑点 |
|---|---|---|---|---|---|
split() |
str |
sep=None, maxsplit=-1 |
list[str] |
文本分词、解析CSV/日志行、截取前缀 | 不传 sep 会合并连续空白;传入 sep=' ' 会保留空串 |
join() |
str (连接符) |
iterable[str] |
str |
列表转字符串、生成路径、高效组装大文本 | 序列内部元素必须全为 str,否则抛出 TypeError |
replace() |
str |
old, new, count=-1 |
str (新对象) |
修正错别字、模板占位符替换、掩码脱敏 | 字符串不可变,调用后必须重新赋值接收返回值 |
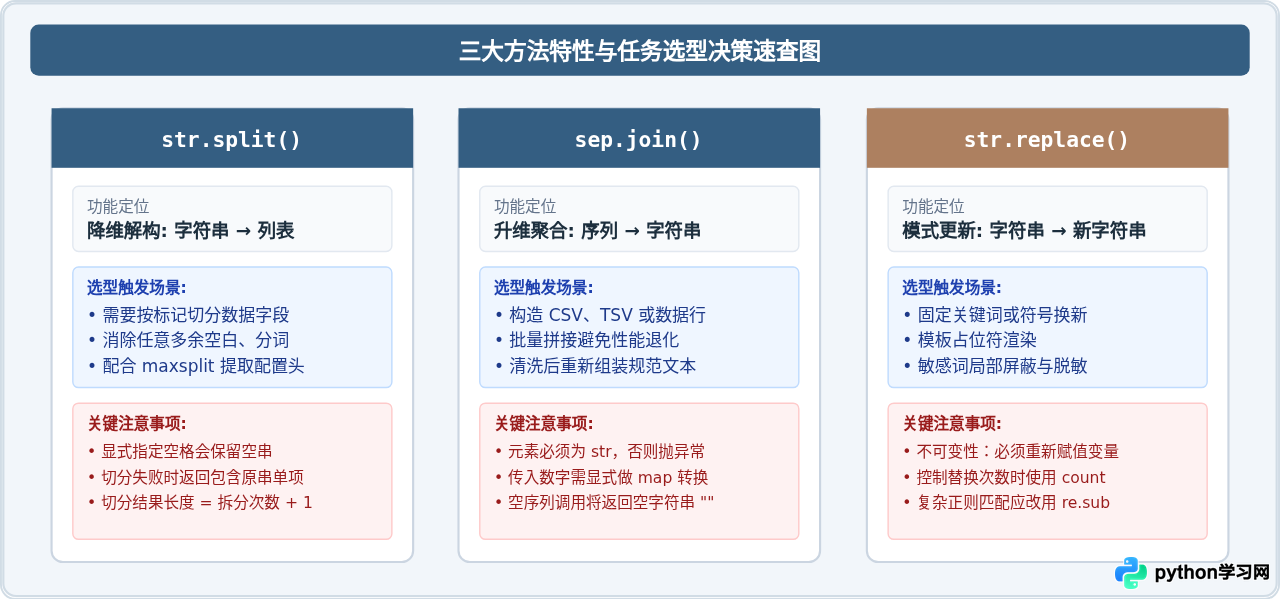
综上所述,split()、join() 和 replace() 是 Python 字符串操作的基石。在编写文本处理逻辑时,优先考虑利用 split() 的空白折叠特性进行分词,利用 join() 构建大批量拼接流程以保障执行效率,并牢记字符串的不可变特性以正确使用 replace() 的返回值。掌握好这三项工具的内部机制,即可在绝大多数日常文本任务中编写出清晰、高效且稳定的 Python 程序。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















