


Python字符串怎么换行:\n、三引号与join用法对比
全面对比Python中实现字符串换行的三种核心方法:\n转义字符、三引号多行字符串与str.join()拼接。深入解析各自语法、缩进处理、底层机制及选型依据。
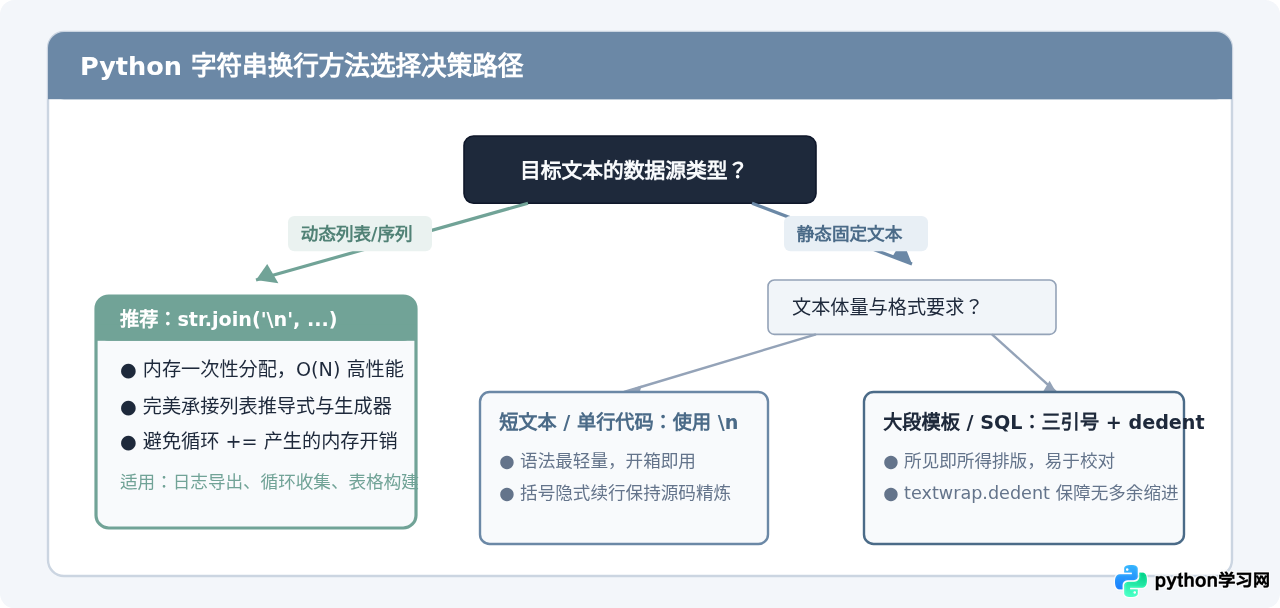
\n、使用三引号(""" 或 ''')多行字符串,以及使用 str.join() 方法拼接列表。核心选型逻辑非常清晰:单行紧凑文本优先用 \n,固定大段模板文本适合三引号,而动态生成的多行数据则应当采用 join。
一、转义字符 \n:最直接的换行标记
\n(ASCII码10,Line Feed)是编程中最通用的换行符。当Python解释器在双引号或单引号字符串中遇到 \n 时,会将其转换为换行指令,在终端或文本输出中体现为光标移至下一行的行首。
1. 基础用法与输出对比
# 使用 \n 实现换行
text = "第一行内容\n第二行内容\n第三行内容"
print(text)这种方式非常直观,无需改变代码的行级结构即可在目标文本中嵌入换行位置。但如果在单行代码中连续写入过长的内容,会导致Python源文件单行过长,违反PEP 8代码规范。此时可以利用Python的小括号隐式续行特性来排版源码:
# 括号内的连续字面量会自动合并,通过显式写入 \n 保留输出换行
query = (
    "SELECT id, name, created_at\n"
    "FROM users\n"
    "WHERE status = 'active'"
)
print(query)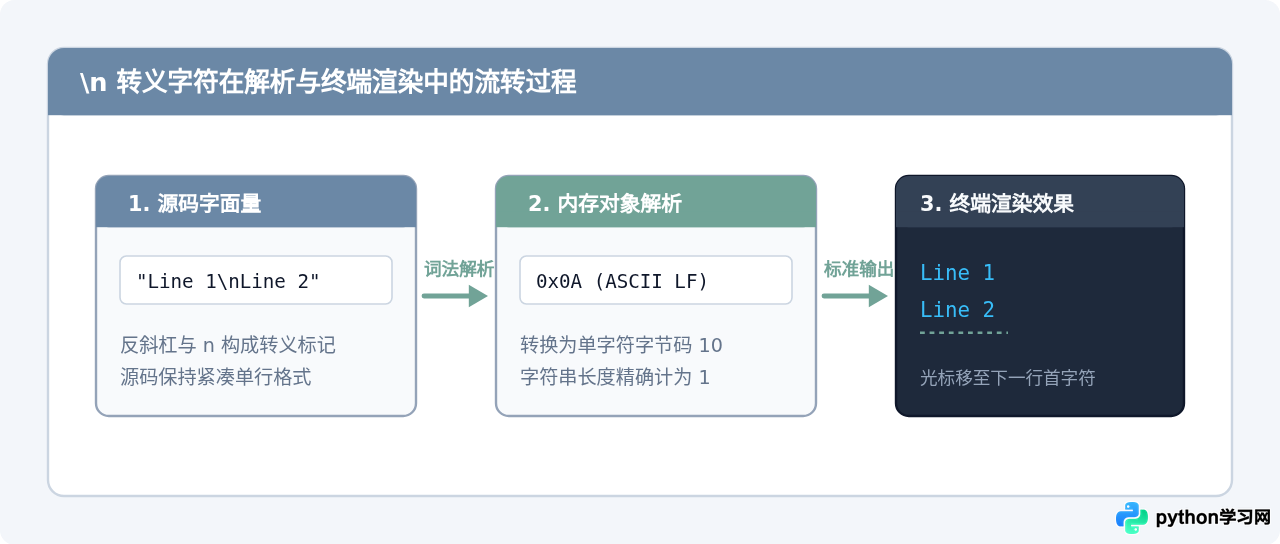
2. 使用 \n 的关键注意点
- 原始字符串(Raw String)陷阱:如果字符串前缀带有
r,例如r"hello\nworld",反斜杠将失去转义意义,被视作普通字符,\n不会产生换行效果。 - 平台兼容性:Windows历史上使用
\r\n,而Unix/Linux/macOS使用\n。在现代Python 3中,常规文本模式的文件写入与读取已默认具备通用换行符转换机制,因此直接使用\n即可保证最佳跨平台兼容性。
二、三引号多行字符串:直观排版与缩进处理
Python允许使用连续三个双引号(""")或三个单引号(''')声明多行字符串。在三引号内按下的回车换行,会被直接保留在字符串内容中。
1. 基础语法与所见即所得
template = """欢迎访问文档中心:
1. 阅读开发入门
2. 配置环境变量
3. 启动本地服务"""

print(template)
2. 核心挑战:代码缩进污染文本内容
当三引号位于函数、类或循环体内部时,为了遵循代码缩进规范,开发者通常会在每行前打上空格。但这会导致代码缩进被原样计入字符串内容,造成输出文本整体偏右:
def get_message():
    message = """
        尊敬的客户:
        您的验证码为 8899。
        请在5分钟内完成验证。
    """
    return message

print(get_message())
解决该问题的标准做法是引入Python内置模块 textwrap.dedent(),它可以自动检测并剥除所有行的公共最长前导空格,既维持了Python源码在函数内的整齐缩进,又确保了字符串输出内容顶格对齐:
import textwrap

def get_message_clean():
    # 首尾添加反斜杠或 strip() 可以避免首末两行产生空行
    message = textwrap.dedent("""\
        尊敬的客户:
        您的验证码为 8899。
        请在5分钟内完成验证。""")
    return message

print(get_message_clean())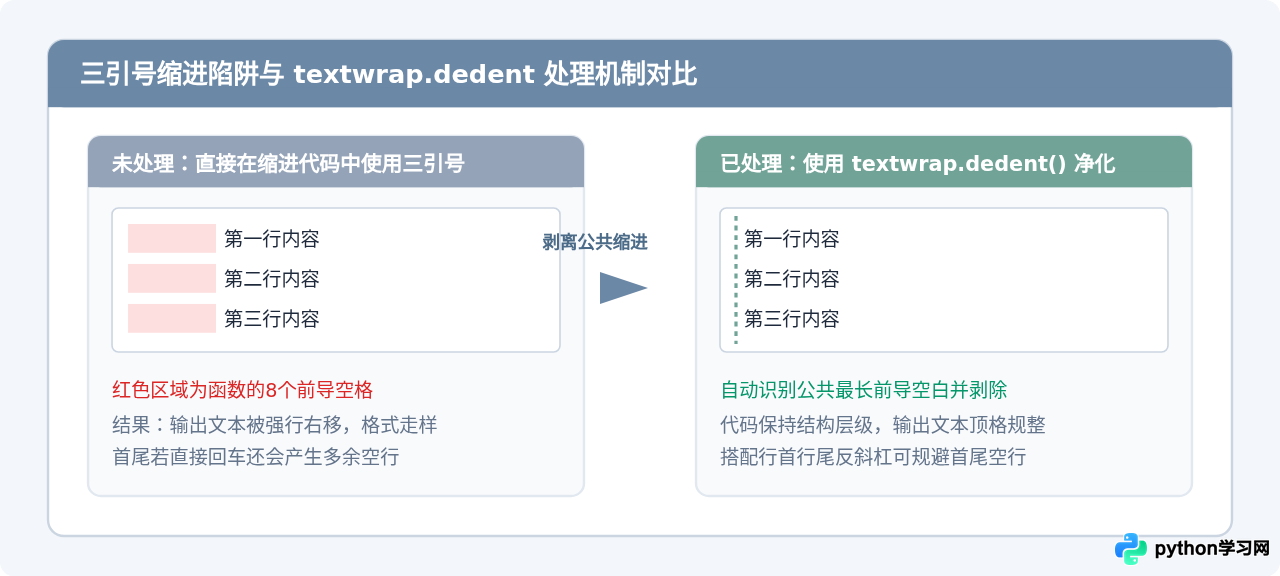
三、str.join() 方法:动态列表的高效换行组装
当要输出的多行字符串并非硬编码在源程序中,而是来自于循环计算、数据库查询结果、日志序列或从文件逐行读取的数据时,join() 是最符合Python工程化规范的换行拼接方式。
1. 基础用法与核心模式
str.join() 接收一个可迭代对象(如 list、tuple、生成器表达式),并使用指定的分隔符将每个元素串联起来。当以 '\n' 作为分隔符时,即可在各元素之间插入换行符:
# 动态数据列表
fruits = ["苹果(Apple)", "香蕉(Banana)", "橙子(Orange)"]

# 使用换行符连接列表各项
result = "\n".join(fruits)
print(result)2. 为什么不用 += 循环拼接换行?
在初学阶段,部分读者可能会倾向于使用 += 在循环中逐行追加:
# 低效的反模式:多次重新分配内存
content = ""
for item in dataset:
    content += item + "\n"  # 每次循环都会创建新的中间字符串对象
由于Python中的字符串是不可变对象(Immutable),每次执行 += 都会在内存中创建新的字符串对象并复制之前的所有字符,时间复杂度会恶化至 \(O(n^2)\)。而 str.join() 在底层由C语言实现,它会预先计算所有元素与分隔符所需的总内存字节数,完成一次性内存分配后连续填入数据,达到 \(O(n)\) 的线性性能。
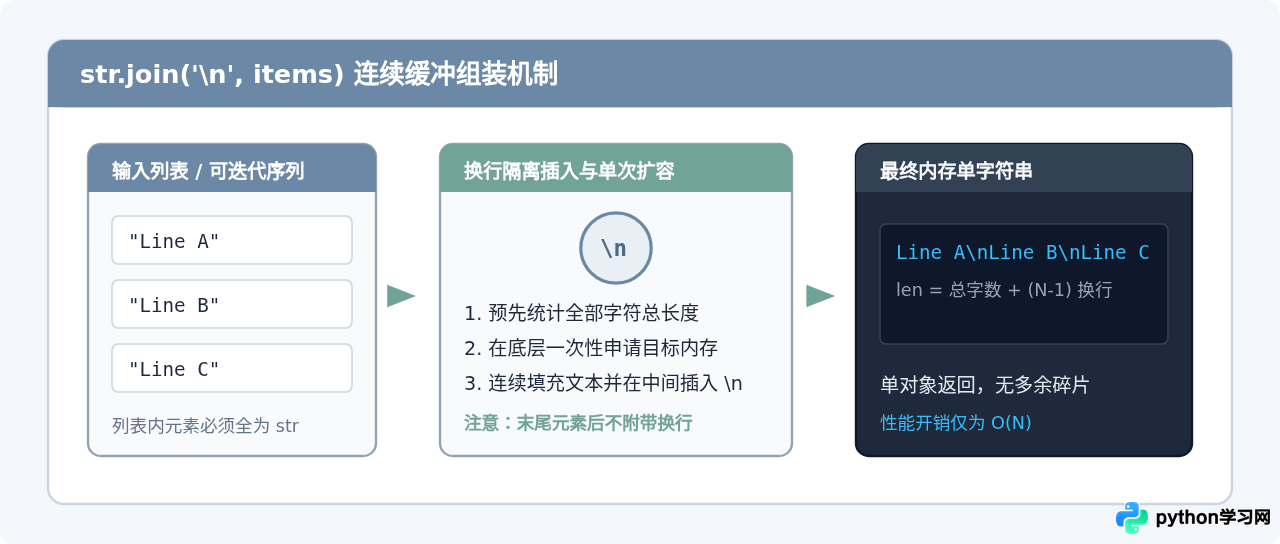
str.join() 仅在元素之间插入换行符。也就是说,最后一行末尾并不会自带换行符。如果输出目标(如生成符合POSIX标准的文件)要求最后一行必须换行结尾,需要在末尾显式补足:result = '\n'.join(lines) + '\n'。
四、三种换行方式核心特性与选型对比
为了在实际开发中快速选出最恰当的方法,可以从应用场景、代码维护性与输入形式等几个维度进行横向对比:
| 对比维度 | 转义字符 \n | 三引号多行字符串 | str.join() 方法 |
|---|---|---|---|
| 基本语法形式 | "line1\nline2" |
"""line1 |
"\n".join(list_data) |
| 主要适用场景 | 简短固定文本、日志格式化输出、单行表达式 | 大段固定模板、函数Docstring、嵌入SQL或HTML代码 | 循环产生的动态数据、读取文件行集合、批量生成结构化报告 |
| 代码缩进敏感度 | 不敏感(不改变代码外部缩进) | 高度敏感(需借助 textwrap.dedent 去除多余前导空格) |
不敏感(列表定义与生成逻辑独立) |
| 动态扩展性 | 较弱(适合硬编码字面量) | 中等(可搭配 f-string 插值) | 极高(原生支持任意可迭代数据源) |
| 末尾换行控制 | 完全由开发者在末尾是否写 \n 决定 |
取决于最后一行是否有换行符 | 默认只在行间插入,末尾不带换行,需按需补加 |
五、常见问题排查与避坑指南
1. 为什么用括号写了多行字符串,打印出来却完全没有换行?
这是许多初学者经常遇到的现象。在Python中,在括号内将多个相邻的字符串字面量分行书写时,解释器会自动进行字面量隐式拼接(Implicit String Concatenation),中间不会插入任何字符:
# 误区示范:虽然在代码编辑器中分了三行,但没有写换行符
message = (
    "第一行"
    "第二行"
    "第三行"
)
print(message)
# 实际输出为:第一行第二行第三行
解决方法:括号仅仅起到语法上的续行作用,字符串内部如需换行,必须在行末显式写入 \n:
# 正确写法:显式包含 \n
message = (
    "第一行\n"
    "第二行\n"
    "第三行"
)
2. 在三引号开头紧跟换行导致多出一个空行,该如何消除?
当在三引号下一行开始书写正文时,三引号后面的回车会算作一个真实的空行:
# 第一行直接产生一个空行
text = """
这是内容第一行
这是内容第二行
"""
解决方法:在三引号后紧接一个反斜杠 \。在Python语法中,行尾的反斜杠表示“转义换行符”,解释器会忽略这一行回车,从而让文本从视觉上的下一行开始顶格,且不产生前置空行:
# 首行使用反斜杠消除首部空行,尾部紧贴三引号避免尾部空行
text = """\
这是内容第一行
这是内容第二行"""
3. 从外部文件读取的行使用 join 拼接时产生“双重换行”?
当使用 file.readlines() 读取文本文件时,每一行末尾通常已经自带了文件原本的换行符 \n。如果直接对其执行 '\n'.join(lines),就会在已有的换行符后面再增加一个换行符,表现为空行倍增。
解决方法:在使用 join 前,先对每一项剥离末尾换行符:
clean_lines = [line.rstrip('\r\n') for line in lines]
result = "\n".join(clean_lines)
六、总结与实践建议
掌握Python字符串换行的关键在于理解源码层面的排版可读性与运行期字符串内容的解耦:
- 编写业务提示信息、日志模版或单行代码时,优先使用
\n;若字符串较长,借助圆括号隐式合并来维持代码优雅。 - 编写说明文档(Docstring)、SQL查询语句或复杂的HTML/Markdown模板时,使用三引号多行字符串,并搭配
textwrap.dedent()消除代码缩进的影响。 - 处理集合、列表、文件批处理或网络返回的多行数据时,坚决使用
'\n'.join(iterable),兼顾算法效率与内存安全。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















