


Python有什么用:数据分析、AI开发与自动化办公全景解析
全面解析Python在自动化办公、数据分析与人工智能开发三大核心领域的实际用途、技术工具栈与具体应用流程,帮助初学者与从业者清晰理解Python的实用价值。
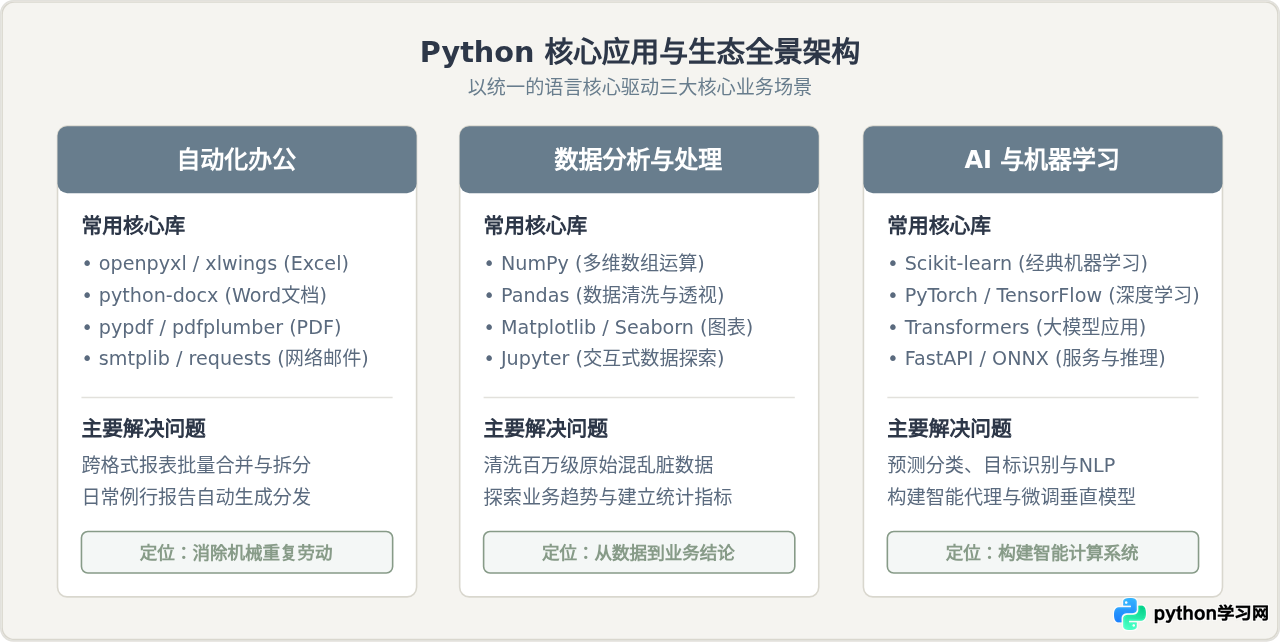
Python 的核心价值在于语法清晰且拥有极其丰富的第三方生态库,能够以极低的代码成本充当底层计算能力与具体业务需求之间的桥梁。在众多技术方向中,Python 最为成熟、应用最广泛的三大支柱领域分别是自动化办公、数据分析与人工智能开发。本文将逐一拆解这三大方向的具体应用场景、核心工具链、标准工作流程与选型依据,帮助读者建立系统、切实的认知。
一、自动化办公:消除机械重复的生产力利器
自动化办公是 Python 对非纯技术人员及业务人员最快见效的场景。日常办公中充斥着大量的机械化操作:汇总数十个部门提交的 Excel 表格、按模板批量填充客户通知书并导出 PDF、从内网系统抓取每日销售数据并发送邮件汇报。这些工作如果完全由人工完成,不仅耗时耗力,而且在复制粘贴的过程中极易出现人为失误。
Python 在此领域的优势在于,它几乎为所有的常用办公文档格式和通信协议都提供了对应的成熟接口库:
- 电子表格处理(Excel/CSV):使用
openpyxl读写.xlsx文件的单元格、公式和样式;使用pandas高效处理百万级扁平表格。 - 文字文档与排版(Word):使用
python-docx自动替换合同或报告模板中的关键段落、生成标准段落格式。 - 版面固定与合并(PDF):使用
pypdf完成多份文档合并、加注文字水印,或者使用pdfplumber提取表格文本。 - 流程调度与分发:通过内置的
smtplib与email模块自动发送带附件的工作邮件,结合schedule实现定时无人值守运行。
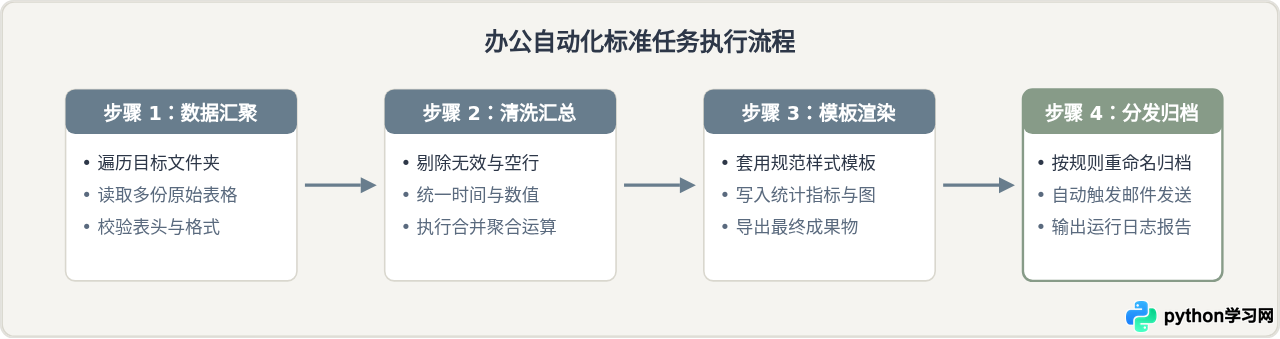
实战示例:批量合并多个 Excel 部门报表
以下代码演示如何使用 pandas 将当前目录下指定文件夹中所有部门的月度数据合并为一张总表,并自动剔除缺失关键工号的无效行:
import os
import pandas as pd

def merge_department_reports(input_folder, output_file):
    # 查找所有 xlsx 文件
    excel_files = [f for f in os.listdir(input_folder) if f.endswith('.xlsx') and not f.startswith('~$')]
    all_data = []

    print(f"检测到 {len(excel_files)} 个报表文件,开始合并...")
    for filename in excel_files:
        file_path = os.path.join(input_folder, filename)
        # 读取指定工作表
        df = pd.read_excel(file_path)
        # 记录数据来源部门
        df['来源文件'] = filename
        all_data.append(df)

    if not all_data:
        print("未找到有效数据,终止操作。")
        return

    # 纵向拼接并清洗
    merged_df = pd.concat(all_data, ignore_index=True)
    # 删除员工编号为空的异常行
    cleaned_df = merged_df.dropna(subset=['员工编号'])

    # 保存结果
    cleaned_df.to_excel(output_file, index=False)
    print(f"合并完成,共保留有效记录 {len(cleaned_df)} 条,已保存至:{output_file}")

# 示例调用
# merge_department_reports('./reports_2026', './2026年度汇总表.xlsx')
~$ 开头的临时锁文件,并在读取前明确指定 dtype={'员工编号': str} 等字段类型,防止前导零(如 00123)被自动转换为数字而丢失信息。
二、数据分析:从海量杂乱数据中提炼商业洞察
如果说办公自动化的重点是“文件的流转与排版”,那么数据分析的核心则是“数据的洞察与计算”。在互联网运营、金融风控、制造业质量监控和市场研究中,数据往往存在体量大、结构脏、来源复杂的特点。
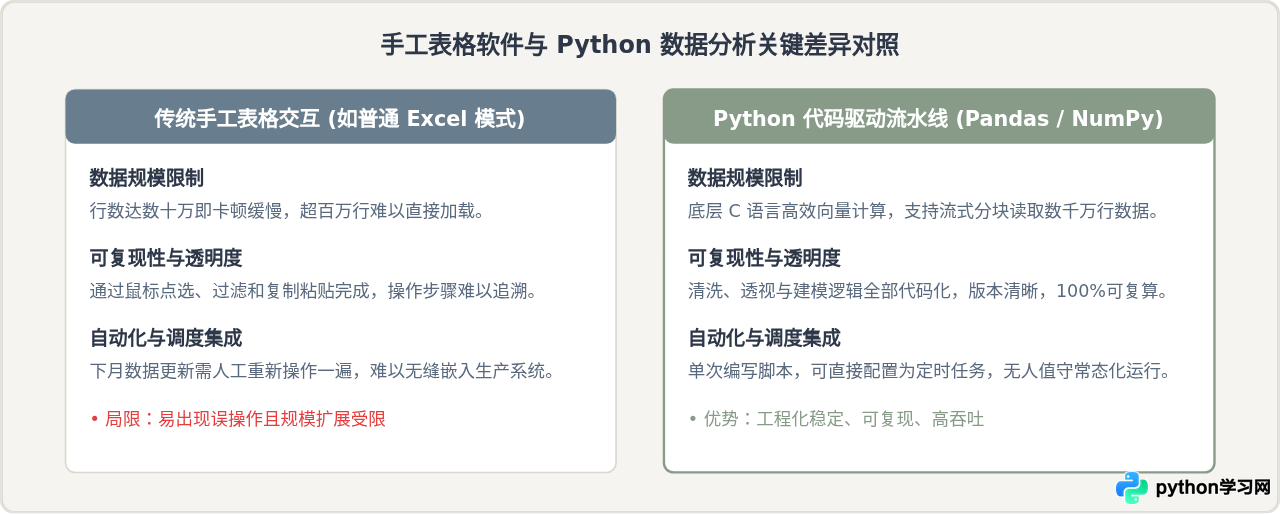
核心差异对比:传统手工表格操作 vs Python 代码驱动分析
初学者常有疑问:既然 Excel 已经有数据透视表和图表功能,为什么还要专门学习 Python 做数据分析?两者的关键差异在于处理边界、自动化重现性与扩展能力。
典型应用步骤与工具搭配
- 探索性数据分析(EDA):利用
Jupyter Notebook进行交互式探索,快速查看均值、标准差、分位数及空值分布。 - 特征工程与清洗:使用
Pandas处理缺失值插补、日期格式标准化、类别编码与数据去重。 - 统计建模与假设检验:使用
SciPy或statsmodels进行方差分析、相关性检验或时间序列平稳性检验。 - 业务指标可视化:通过
Matplotlib与Seaborn绘制热力图、箱线图、趋势折线图,直观展示数据规律。
三、AI与机器学习:从底层算法到现代大模型工程
在人工智能与前沿机器学习领域,Python 是毫无争议的通用行业语言。无论是最经典的监督学习算法,还是基于深度学习的计算机视觉、自然语言处理以及当今的大语言模型(LLM),绝大部分前沿研究与工业界框架都首选 Python 作为第一开发接口。
Python 本身作为解释型语言,运行速度并不直接媲美 C++ 或 Rust,但它通过优秀的 C/C++ 扩展机制(如 Python C API、pybind11),将高密度的张量乘法、卷积和 GPU 算子编译为底层机器指令,上层则暴露优雅直观的 Python 语法。开发者既能享受高级语言的高效编写体验,又能获得硬件级的极限性能。
AI 开发的技术层次
- 基础机器学习:使用
Scikit-learn。涵盖随机森林、逻辑回归、SVM、PCA降维和网格搜索超参数调优,适合表格类预测与中小规模数据建模。 - 深度学习框架:以
PyTorch和TensorFlow为代表。提供自动微分引擎(Autograd)与 GPU 硬件加速,用于构建深度神经网络、卷积网络(CNN)与注意力机制(Transformer)。 - 大语言模型生态:以 Hugging Face 的
transformers、peft、langchain为核心。支持快速加载预训练大模型、执行微调(Fine-tuning)、知识库检索增强生成(RAG)以及 Agent 智能体协同。
实战示例:使用 Scikit-learn 构建分类预测流水线
以下代码演示一个标准机器学习分类任务的完整工程闭环:划分数据集、特征标准化、模型拟合以及评估准确率指标。
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report, accuracy_score

def train_classifier():
    # 1. 加载样例数据
    data = load_iris()
    X, y = data.data, data.target

    # 2. 划分训练集与测试集 (8:2)
    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.2, random_state=42, stratify=y
    )

    # 3. 特征标准化 (避免量纲偏差)
    scaler = StandardScaler()
    X_train_scaled = scaler.fit_transform(X_train)
    X_test_scaled = scaler.transform(X_test)

    # 4. 实例化模型并训练
    model = RandomForestClassifier(n_estimators=100, random_state=42)
    model.fit(X_train_scaled, y_train)

    # 5. 模型预测与结果评估
    predictions = model.predict(X_test_scaled)
    acc = accuracy_score(y_test, predictions)
    print(f"测试集准确率 (Accuracy): {acc:.4f}\n")
    print("分类详细报告:")
    print(classification_report(y_test, predictions, target_names=data.target_names))

# 执行训练
train_classifier()
四、全景解析与技术选型总结
综上所述,Python 并不是一个局限于某单一工种的专用工具,而是根据使用者的需求深度,呈现出多梯度的能力矩阵:
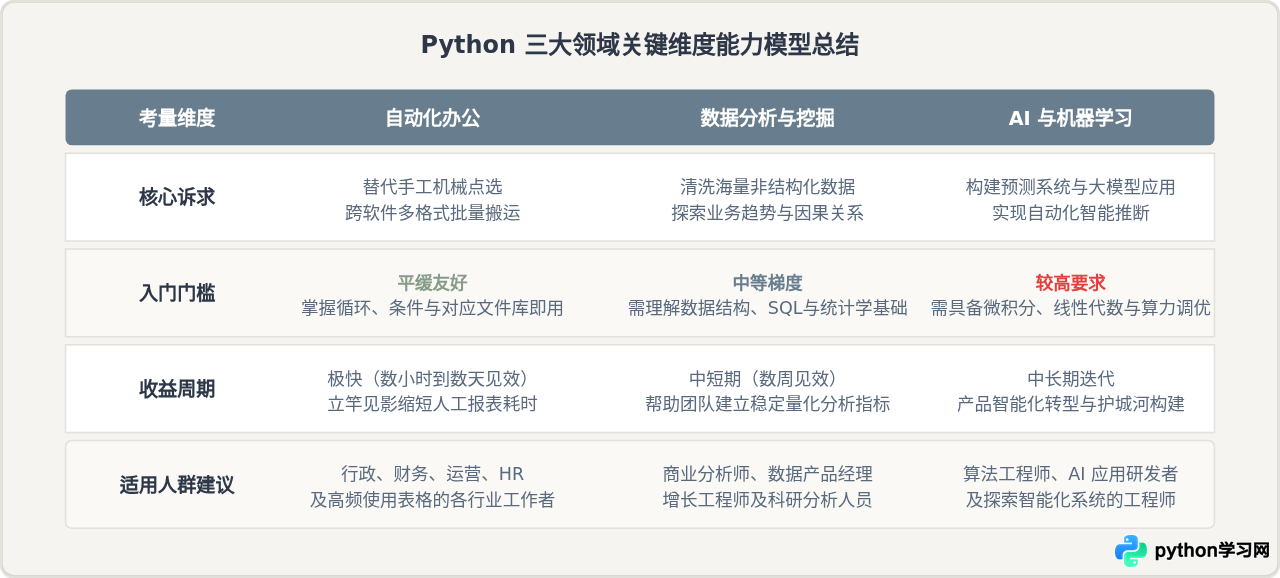
在实际学习与落地规划中,最稳妥的路径是从自动化办公切入,熟悉变量、循环、文件读写及异常处理;在此基础上进阶到数据分析,掌握结构化数据的处理、清洗和统计图形呈现;当需要进一步解决复杂预测或智能化分类需求时,再深入探索AI与机器学习生态。循序渐进的推进策略,能确保每一阶段学到的技能都能即时转化为实际生产力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















