


Python怎么用负数索引从末尾截取字符串?

深入讲解Python如何使用负数索引和切片语法从字符串末尾截取内容,包含正负索引对照、左闭右开区间避坑指南、负步长反转以及工程场景中的实用示例。
在 Python 中,从字符串末尾截取字符的核心手段是结合负数索引使用切片语法 string[start:end]。由于倒数第一个字符对应负索引 -1,只需写成 string[-N:] 即可轻松获取末尾的 N 个字符;而写成 string[:-N] 则能快速剔除尾部多余字符。
一、认识 Python 的双向索引体系
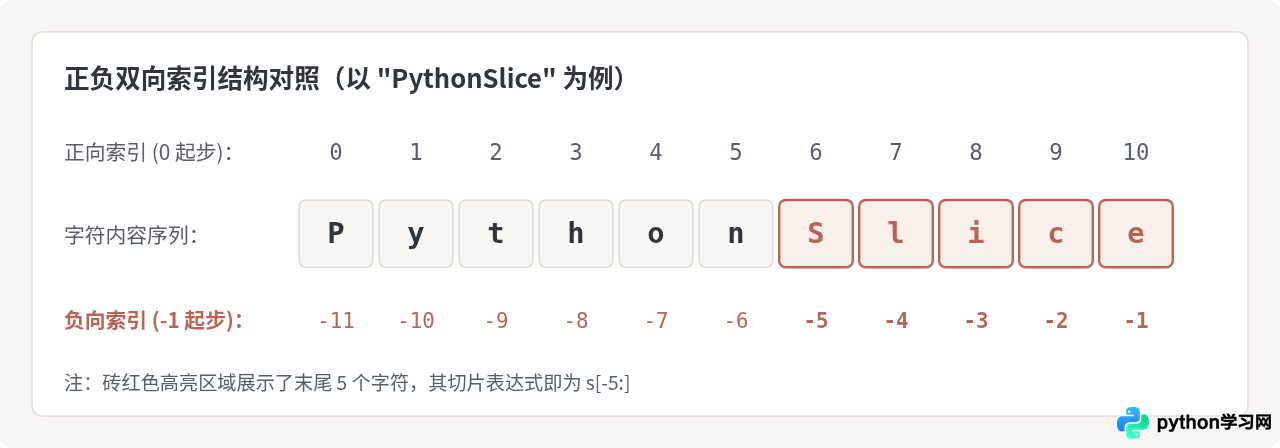
很多初学者习惯于从左向右以 0 为起点递增计数,但在处理末尾内容(例如提取文件后缀、读取尾部状态码、截断签名字符串)时,正向索引往往需要依赖 len() 进行复杂计算。Python 内置支持序列的负数索引机制,从字符串最右侧倒序寻址。
在负数索引中,最右侧最后一个字符固定为 -1,倒数第二个字符为 -2,依此类推,最开头的字符索引为 -len(s)。本质上,负索引 s[-k] 在解释器内部等价于 s[len(s) - k],但无需手动计算长度即可直接表达相对位置。
二、使用负数切片的三大常见实战模式
从末尾截取通常可以归纳为三类业务场景:截取最后 N 个字符、截取尾部某段局部子串、以及去除末尾固定长度的冗余字符。标准切片语法为 string[start:end:step],省略 step 时默认为 1。
1. 截取最后 N 个字符:s[-N:]
如果需要截取尾部 N 个字符,将起始索引设为 -N,结束索引直接留空。结束索引留空代表切片一直延伸至字符串最末尾(包含最后一个字符)。
# 示例代码:截取末尾固定长度内容
filename = "invoice_report_2026.pdf"

# 截取最后 4 个字符
ext = filename[-4:]
print(f"扩展名: {ext}")

# 示例输出:
# 扩展名: .pdf
2. 截取倒数特定区间:s[-start:-end]
当需要截取末尾内部的某一段、且不包含最后几个字符时,可以同时指定两个负数索引。此时必须严格遵守左闭右开原则:start 位置的字符会被包含,而 end 位置的字符不被包含。
# 示例代码:截取倒数第 8 位到倒数第 4 位之间的年份数字
filename = "invoice_report_2026.pdf"

# -8 对应 '2',-4 对应 '.'(不包含 '.')
year = filename[-8:-4]
print(f"提取年份: {year}")

# 示例输出:
# 提取年份: 2026
3. 剔除末尾 N 个字符:s[:-N]
在清理数据时,若想剔除字符串末尾多余的单位、换行符或固定长度后缀,可以将起始位置留空(默认从下标 0 开始),结束位置设为 -N。
# 示例代码:去除尾部单位或后缀
price_str = "12800元/月"
clean_price = price_str[:-3]
print(f"纯数值部分: {clean_price}")

# 示例输出:
# 纯数值部分: 12800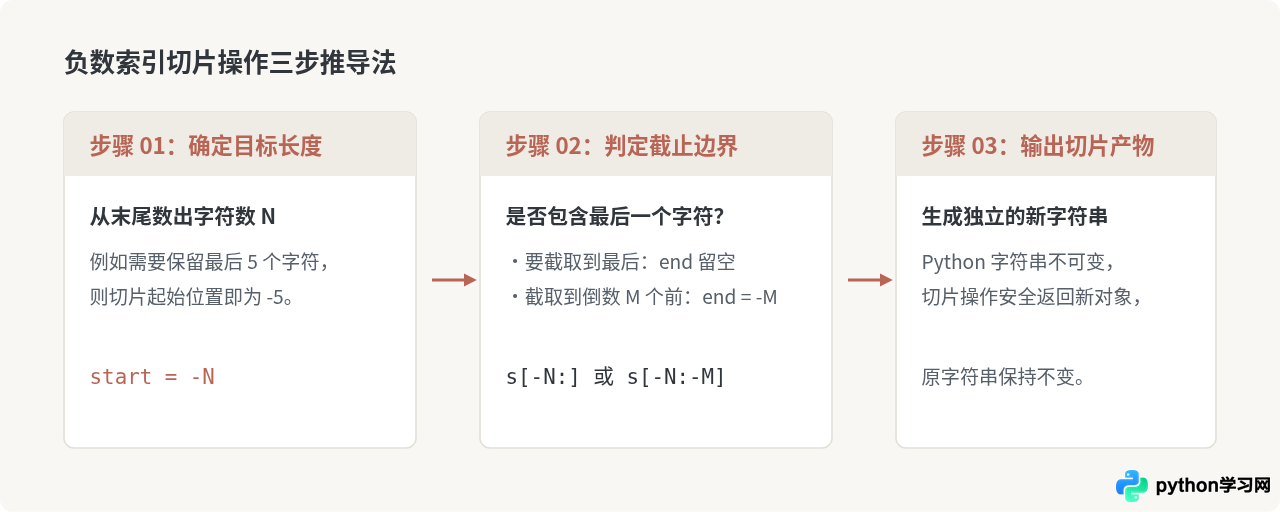
三、容易忽视的重大陷阱:左闭右开与末尾截断
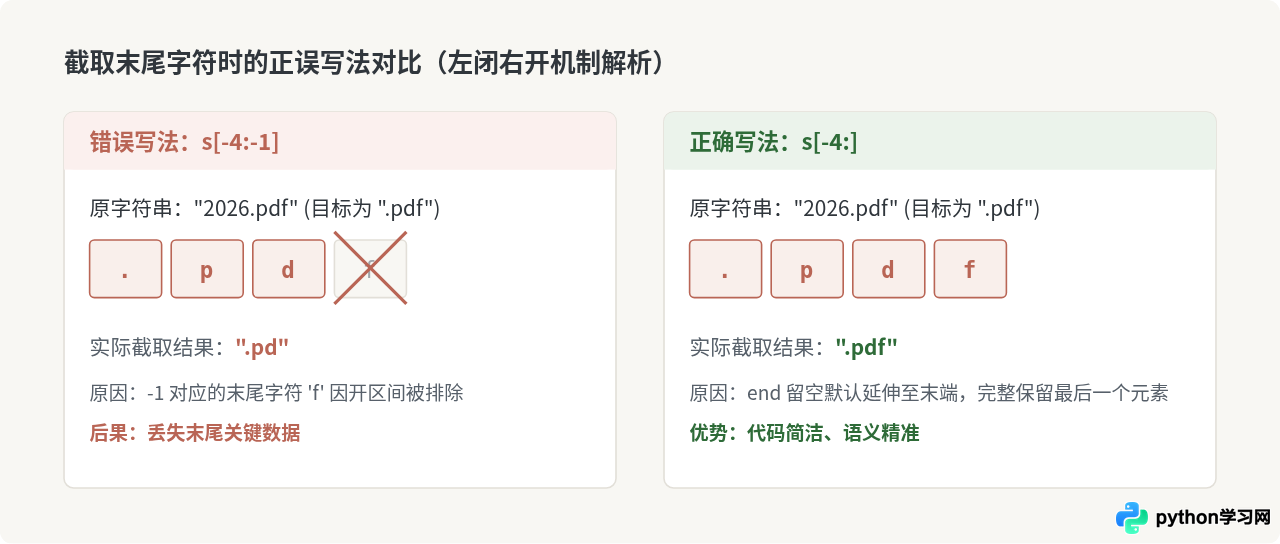
在日常开发中,最常见也是最隐蔽的错误是:试图截取最后 3 个字符,却直觉性地写成了 s[-3:-1]。
由于 Python 切片严格遵循左闭右开(数学表达为 [start, end))规则,切片结果只包含索引在 start <= index < end 之间的字符。当设置 end = -1 时,实际取到的是倒数第 2 个字符为止,最后一个字符被直接丢弃了。
避坑铁律:若目标包含字符串的最末尾字符,end 必须留空(写作 s[-N:]),绝对不能写成 s[-N:-1] 或 s[-N:0](s[-N:0] 会直接返回空字符串 "",因为正数索引 0 位于负数索引的前方,左闭右开区间无法选出任何字符)。
四、进阶延伸:负数步长反向截取
除了将负数用于 start 和 end 之外,切片的第三个参数 step 也可以设置为负数。当 step < 0 时,切片的读取方向将彻底调转(自右向左)。
s[::-1]:最经典的倒序写法,起始和结束均省略,以步长-1反转整个字符串。s[-1:-5:-1]:从倒数第 1 个字符开始,向左倒序截取到倒数第 5 个字符之前(包含倒数第 1、2、3、4 个字符,但顺序是逆序排列)。
# 示例代码:负步长倒序截取
serial_no = "ABCDEF-98765"

# 反转整串
reversed_str = serial_no[::-1]
print(f"反转结果: {reversed_str}")

# 从末尾倒序提取最后 5 位数字
tail_reversed = serial_no[-1:-6:-1]
print(f"末尾倒序截取: {tail_reversed}")

# 示例输出:
# 反转结果: 56789-FEDCBA
# 末尾倒序截取: 56789
五、边界与容错处理
编写生产环境代码时,字符串长度往往是不确定的。必须分清单字符直接索引与切片截取在边界容错上的巨大差异:
- 直接索引易引发异常:使用
s[-1]获取最后一个字符时,若s为空字符串"",程序会直接抛出IndexError: string index out of range。 - 切片具备自动容错机制:切片操作
s[-5:]对索引越界具备天然免疫力。即使原字符串长度仅有 2 个字符(小于 5),它也不会报错,而是优雅地返回整个字符串;如果对空字符串进行切片,则安全返回空字符串。
# 示例代码:索引与切片的越界表现差异
short_text = "Hi"

# 1. 直接索引:若超出范围会抛异常
# print(short_text[-5])  # 会直接报错: IndexError: string index out of range

# 2. 切片截取:安全且不会报错
result = short_text[-5:]
print(f"安全切片结果: '{result}'")

# 示例输出:
# 安全切片结果: 'Hi'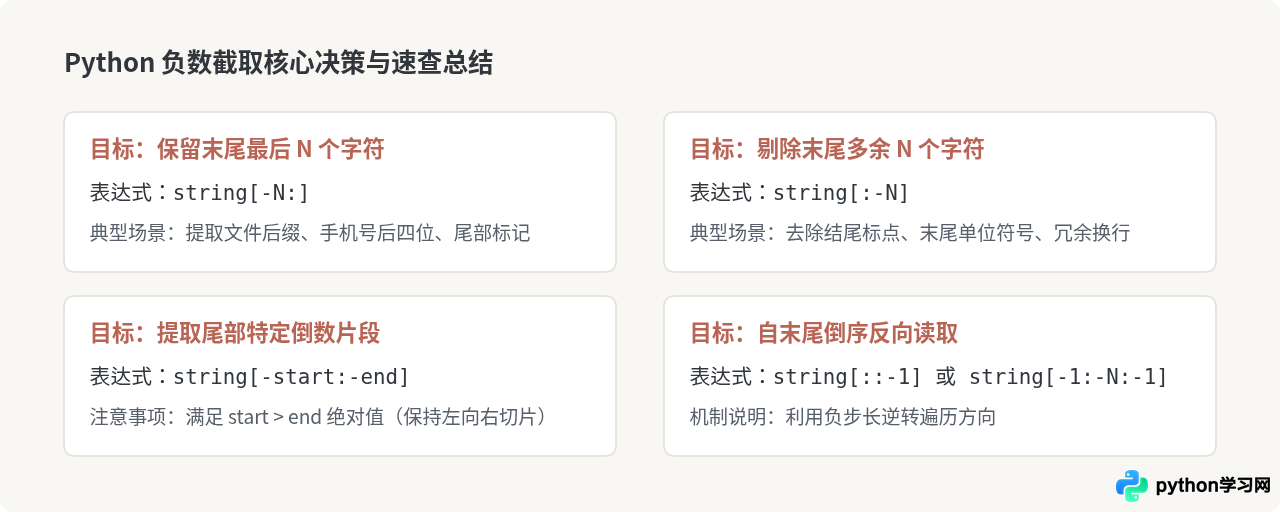
六、语法速查一览表
| 需求场景 | 标准切片语法 | 示例(s = "HelloWorld") | 执行结果 |
|---|---|---|---|
| 截取最后 3 个字符 | s[-3:] |
"HelloWorld"[-3:] |
"rld" |
| 删除末尾 2 个字符 | s[:-2] |
"HelloWorld"[:-2] |
"HelloWor" |
| 截取倒数第 5 到倒数第 2 个 | s[-5:-2] |
"HelloWorld"[-5:-2] |
"Wor" |
| 获取最后一个字符(带容错) | s[-1:] |
"HelloWorld"[-1:] |
"d"(空串返回 "" 不报错) |
| 反转整串字符 | s[::-1] |
"HelloWorld"[::-1] |
"dlroWolleH" |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















