


Python使用csv模块读取CSV文件的基础方法

介绍如何使用Python标准库内置的csv模块读取CSV文件,重点讲解csv.reader与csv.DictReader的基础用法、open函数的关键参数配置、数据类型处理及常见编码与格式问题的排查方法。
在Python中读取CSV(Comma-Separated Values,逗号分隔值)文件,最基础且无需安装任何第三方库的方法是使用Python标准库自带的 csv 模块。通常的解决路径是:先利用内置的 open() 函数以只读模式建立文件对象并规范换行符与编码,再借助 csv.reader 按行读取为列表,或者使用 csv.DictReader 将每行映射为以列头为键的字典。本文将围绕这两个核心读取器展开,提供完整的可运行代码、内部运作机制解析与常见编码格式问题的规避方案。
准备工作与示例数据
csv 是Python内置模块,直接编写 import csv 即可使用。为了便于验证后续的所有代码片段,我们先设定一个名为 users.csv 的测试数据文件。该文件包含一个标题行与三条记录:
name,age,city,score
Alice,24,Beijing,88.5
Bob,30,Shanghai,92.0
Charlie,28,Guangzhou,79.5
在处理该文件时,请确保Python脚本与 users.csv 处于同一工作目录,或者在代码中传入该文件的绝对路径。
方法一:使用 csv.reader 按行读取列表
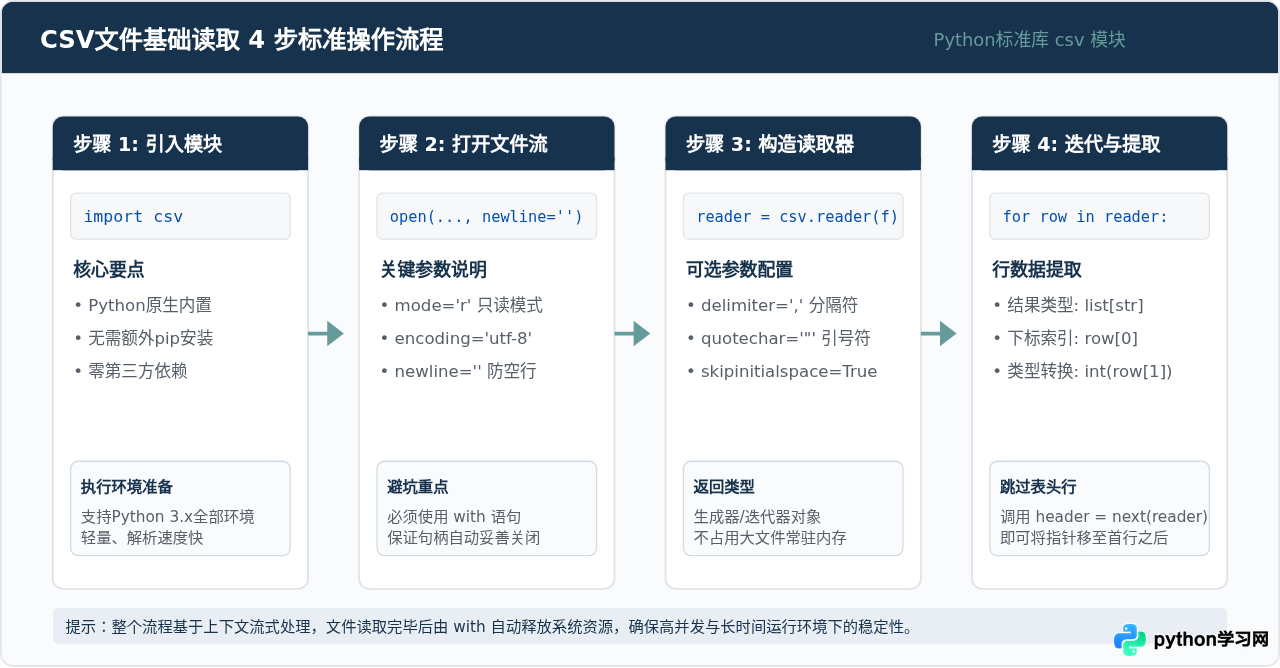
csv.reader 是最基础的读取工具。它接受一个可迭代的文件流对象,并将文件中的每一行数据解析为一个由字符串组成的Python列表(list)。
标准操作步骤
- 导入模块:执行
import csv。 - 打开文件:使用
with open(...)上下文管理器,指定模式为只读'r',编码为'utf-8',并显式传入newline=''。 - 创建解析器:调用
csv.reader(f)返回一个迭代器对象。 - 遍历提取:通过
for row in reader逐行迭代并获取列表元素。
基础代码示例
import csv

# 1. 打开文件并指定换行符与编码格式
with open('users.csv', mode='r', encoding='utf-8', newline='') as file:
    # 2. 构造 reader 读取器对象
    reader = csv.reader(file)

    # 3. 提取表头(可选:使用 next() 提取第一行)
    headers = next(reader)
    print(f"表头字段: {headers}")

    # 4. 逐行遍历数据
    for index, row in enumerate(reader, start=1):
        print(f"第 {index} 行记录: {row}")
执行结果示例:
表头字段: ['name', 'age', 'city', 'score']
第 1 行记录: ['Alice', '24', 'Beijing', '88.5']
第 2 行记录: ['Bob', '30', 'Shanghai', '92.0']
第 3 行记录: ['Charlie', '28', 'Guangzhou', '79.5']在上述代码中,next(reader) 会提前消耗掉第一行(即表头),随后的 for row in reader 循环将直接从真实的数据行开始迭代。如果不调用 next(),第一行表头也会作为普通列表在循环中被打印出来。
方法二:使用 csv.DictReader 读取为键值字典
在实际开发中,按数字索引(例如 row[0]、row[2])提取字段虽然效率高,但存在明显的弊端:一旦CSV文件的列顺序调整或中间插入了新列,索引就会全部错位,导致读取逻辑崩溃。csv.DictReader 正是为了解决该问题而设计的。
csv.DictReader 会自动把文件的第一行识别为字典的键(Keys),随后的每一行数据都会映射为一个字典对象。这样我们就可以直接通过字段名称获取内容,例如 row['name']。
代码示例
import csv

with open('users.csv', mode='r', encoding='utf-8', newline='') as file:
    # 构造 DictReader 读取器
    dict_reader = csv.DictReader(file)

    # 打印自动识别出的所有表头列名
    print(f"识别到的字段列表: {dict_reader.fieldnames}")

    # 直接根据字段名称读取每列数据
    for row in dict_reader:
        user_name = row['name']
        user_age = int(row['age'])  # 转换为整数
        user_score = float(row['score'])  # 转换为浮点数
        print(f"学员: {user_name}, 年龄: {user_age}, 得分: {user_score}")
执行结果示例:
识别到的字段列表: ['name', 'age', 'city', 'score']
学员: Alice, 年龄: 24, 得分: 88.5
学员: Bob, 年龄: 30, 得分: 92.0
学员: Charlie, 年龄: 28, 得分: 79.5csv.DictReader(file, fieldnames=['col1', 'col2', ...]) 显式传入自定义的字段名称列表。此时,DictReader 将不会把第一行作为表头吞掉,而是直接从第一行开始解析为字典。
底层机制:数据流动与流式迭代解析
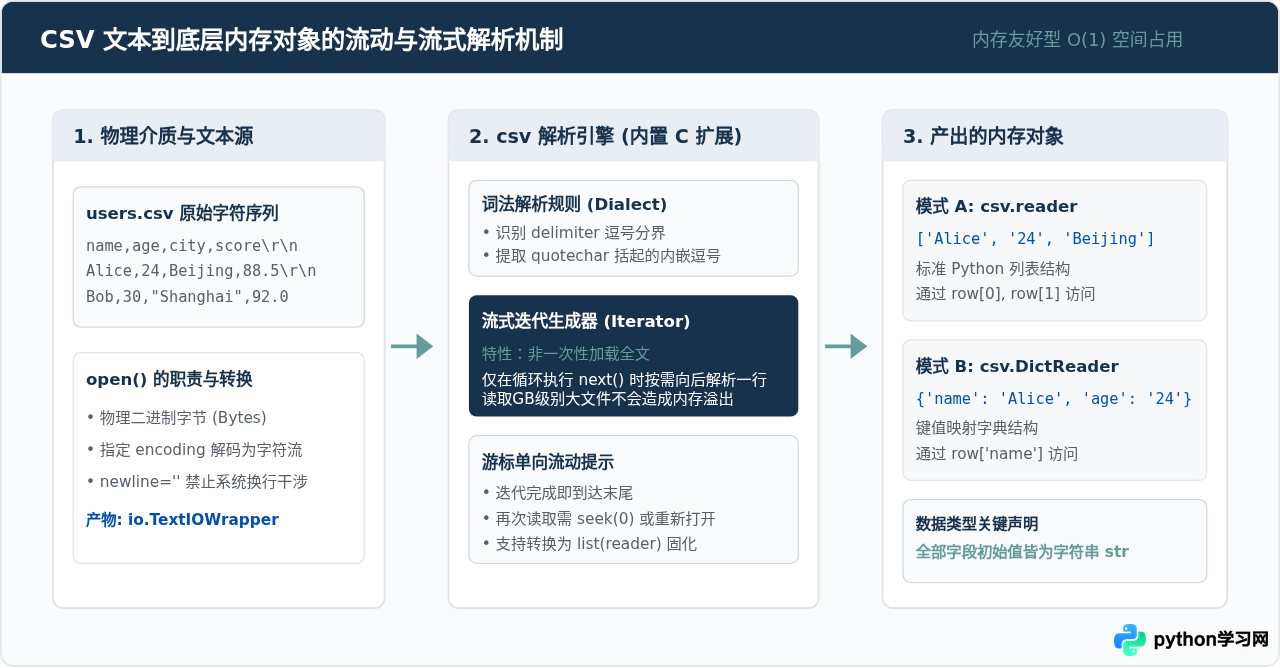
理解 csv 模块的底层运行方式,有助于在面对大体积文件时编写出性能更优、内存开销更小的代码。
当通过 open() 打开文件时,操作系统为Python提供的是原始字节流。io.TextIOWrapper 根据设定的 encoding 将字节解码为Unicode字符流。随后,csv 模块内部的C语言加速解析器(基于有限状态机)对字符流进行扫描,依据逗号(分隔符)、双引号(包裹符)以及换行符判断字段边界与转义规则,最终逐行产生解析好的列表或字典。
关键细节:数据类型转换与参数微调
在熟悉了两种基础读取器后,还有以下三个在编写实际脚本时高频遇到的具体细节需要掌握:
1. 字段类型显式转换
无论原始CSV文件中的内容看起来多么像数字、浮点数或布尔值,csv 模块在读取时无一例外全部按字符串(str)返回。如果直接进行算术比较或数值运算,将导致逻辑错误(例如 '100' < '20' 返回 True,因为是字符串字典序比较)。
# 错误示例:直接累加字符串
total_score = 0
for row in reader:
    # total_score += row[3]  # 抛出 TypeError: unsupported operand type(s) for +=: 'int' and 'str'

# 正确示例:进行类型强转
total_score = 0
for row in reader:
    total_score += float(row[3])
2. 特殊分隔符处理(如制表符 TSV)
有些文件虽然结构与CSV相同,但使用的是Tab制表符(\t)或分号(;)作为列分隔符。可以通过设置 delimiter 参数来适配:
# 读取 TSV 文件(以 Tab 分隔)
with open('data.tsv', mode='r', encoding='utf-8', newline='') as file:
    reader = csv.reader(file, delimiter='\t')
    for row in reader:
        print(row)
3. 忽略字段前导空格
当CSV文件的列之间用类似 Alice, 24, Beijing 这种逗号后带空格的形式排版时,默认解析会将空格保留在字符串开头(例如变成 ' 24')。添加 skipinitialspace=True 即可自动剥离该前导空格:
reader = csv.reader(file, skipinitialspace=True)两种核心读取器对比与选型决策
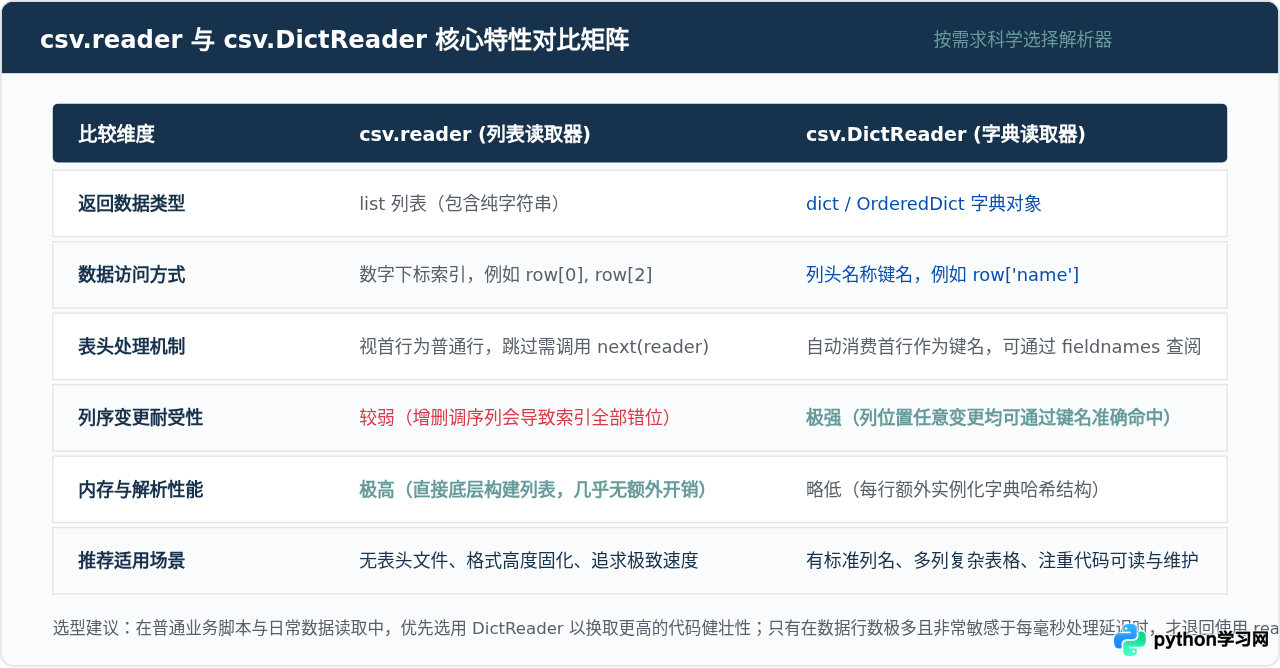
在面对具体的业务需求时,应该选择 csv.reader 还是 csv.DictReader?下面的对比矩阵展示了两者在关键维度上的差异:
常见问题排查与避坑清单
在日常使用 csv 模块时,最容易出现的问题通常集中在编码兼容性以及迭代器生命周期上。遇到报错时,可依照以下原因排查:
1. 报错 UnicodeDecodeError: 'utf-8' codec can't decode byte...
原因:文件不是标准的 UTF-8 编码。在 Windows 操作系统中,使用 Microsoft Excel 导出的 CSV 文件默认经常采用系统本地编码(中文 Windows 系统下通常为 GBK 或 GB18030)。另外,有些软件会导出带有 BOM 头的 UTF-8 文件。
解决办法:尝试调整 open() 函数的 encoding 参数:
- 针对 Excel 默认导出的中文文件:指定
encoding='gbk'。 - 针对带 BOM 头的 UTF-8 文件(首字符出现
\ufeff):指定encoding='utf-8-sig',Python会自动过滤文件开头的 BOM 标记。
2. 为什么一定要加 newline=''?
原因:在不同操作系统上,换行符的表示各不相同(Windows 为 \r\n,Linux/macOS 为 \n)。如果省略 newline='',Python的 open() 会自动进行统一换行转换,这会导致 csv 模块内部的换行识别逻辑产生偏差,在某些包含内嵌换行符(如单元格内部换行)或特定跨平台数据读取时,可能引发额外的空行或解析错位。官方文档明确要求打开待读取的 CSV 文件时必须传递 newline=''。
3. 再次循环读取却拿不到任何数据
表现:执行了两次 for row in reader,第二次循环体没有执行任何输出。
原因:csv.reader 和 csv.DictReader 返回的是生成器/迭代器,内部维护着一个单向向前的读取游标。一旦循环遍历到文件末尾,游标就停留在最后。如果需要再次读取,可以在 with 块内部调用 file.seek(0) 将文件指针重置到开头,或者重新构造读取器;也可以在初次读取时直接使用 rows = list(reader) 将所有数据加载为持久驻留的列表。
总结与技术选型决策树
使用 Python 内置的 csv 模块读取 CSV 文件是一项基础而关键的数据处理技能。它不需要安装任何额外依赖,能够以极低的内存开销完成大部分文本表格的解析任务。
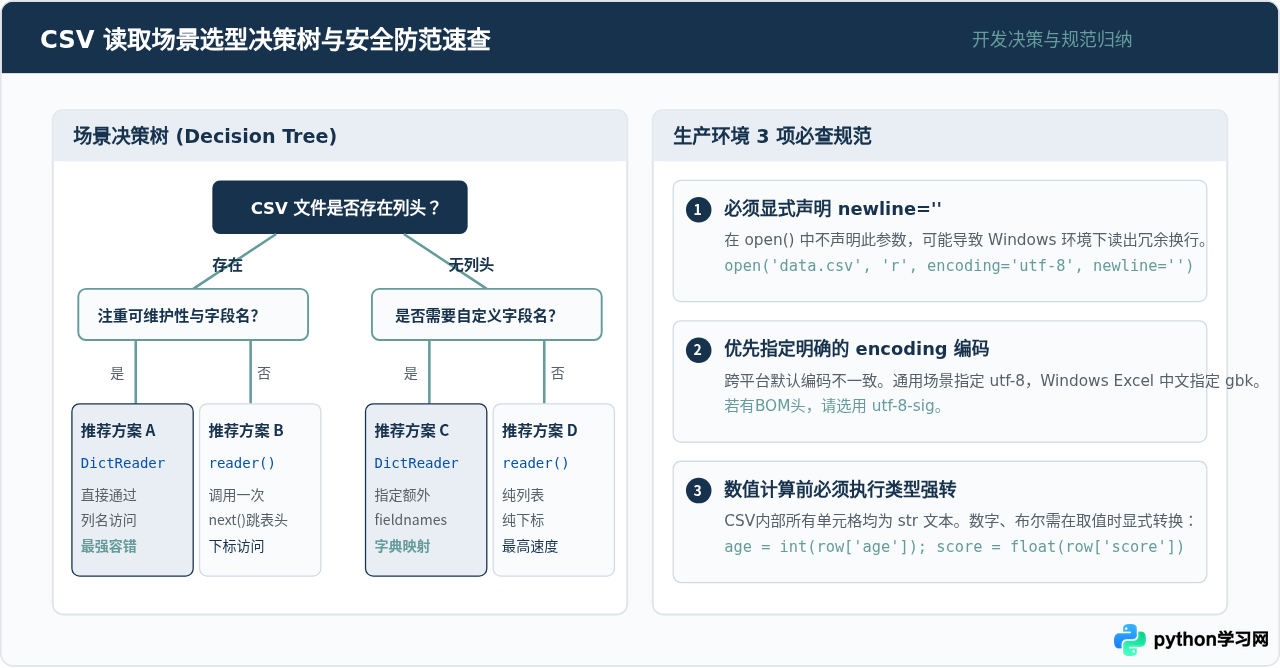
只要在打开文件时养成配置 encoding 与 newline='' 的习惯,并根据数据是否含有表头选择合适的 reader 或 DictReader,就能稳妥、高效地完成所有基础 CSV 数据的读取与解析任务。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















