


Python异步接口调用指南:使用httpx或aiohttp提升并发性能

全面解析在Python中利用httpx与aiohttp进行异步HTTP接口调用的方法与技巧,结合原理对比、选型建议、完整代码示例与生产级并发控制方案,助你有效提升接口吞吐量与系统性能。
在处理外部 API 批量调用、分布式爬虫或微服务数据聚合时,传统的同步请求库(如 requests)往往因阻塞等待网络 I/O 而成为系统的主要性能瓶颈。本文旨在通过深入剖析 Python 异步 I/O 机制,指导读者熟练使用 httpx 与 aiohttp 两个主流异步客户端库,构建安全、高效且具备流量管控能力的高并发请求方案。
一、同步阻塞与异步非阻塞的性能根源
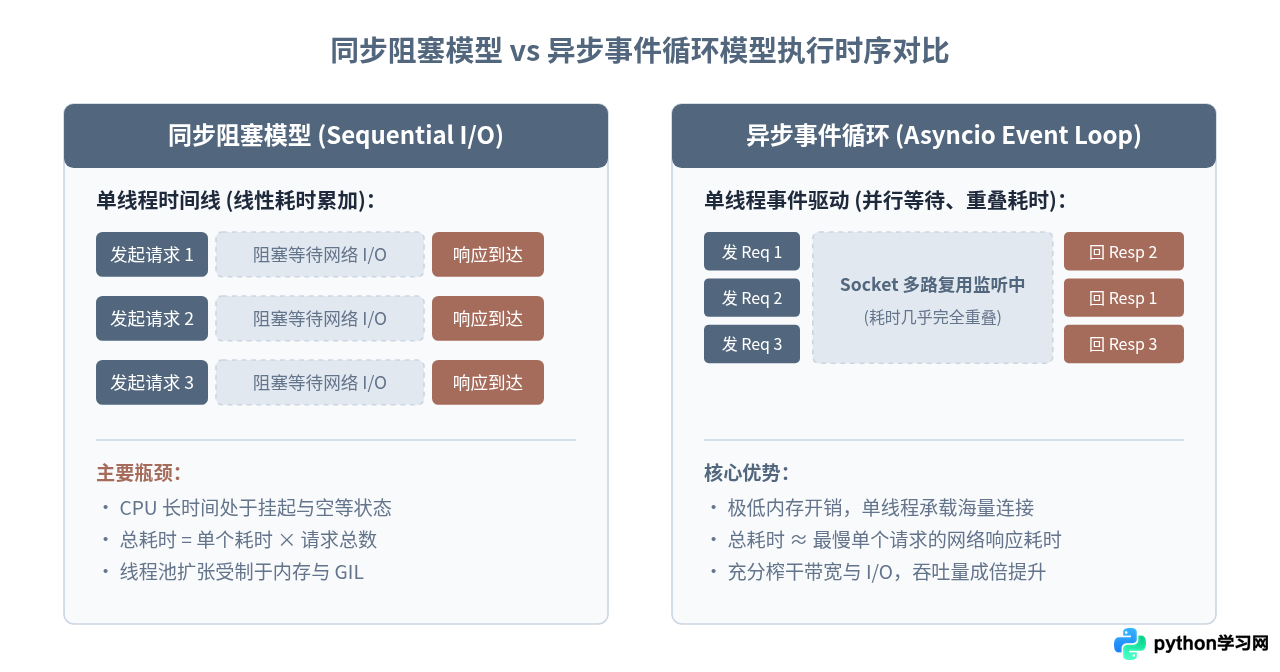
在传统的同步模型中,每次调用 requests.get() 时,当前执行线程都会陷入阻塞状态,静止等待 DNS 解析、TCP 握手、TLS 协商以及远程服务端的响应返回。如果一次请求平均耗时 200 毫秒,单线程顺序发起 100 次调用就需要花费整整 20 秒。即便是借助多线程池,随着并发规模上升,操作系统的线程调度开销、内存占用以及 Python GIL(全局解释器锁)的存在,也会让并发吞吐迅速遭遇天花板。
Python 3.4 引入并不断完善的 asyncio 框架改变了这一范式。在异步非阻塞模型下,程序在单个线程内运行一个事件循环(Event Loop)。当客户端通过底层 Socket 发出 HTTP 请求后,操作系统的 I/O 多路复用机制(如 Linux 上的 epoll 或 macOS 上的 kqueue)负责监听网络事件,当前执行流立即让出 CPU 去发起下一个请求或处理已就绪的数据。这种机制几乎没有额外的线程上下文切换开销,使得 Python 程序能够在极低系统资源占用下维持数千个并发网络连接。
二、技术选型:httpx 与 aiohttp 的核心差异
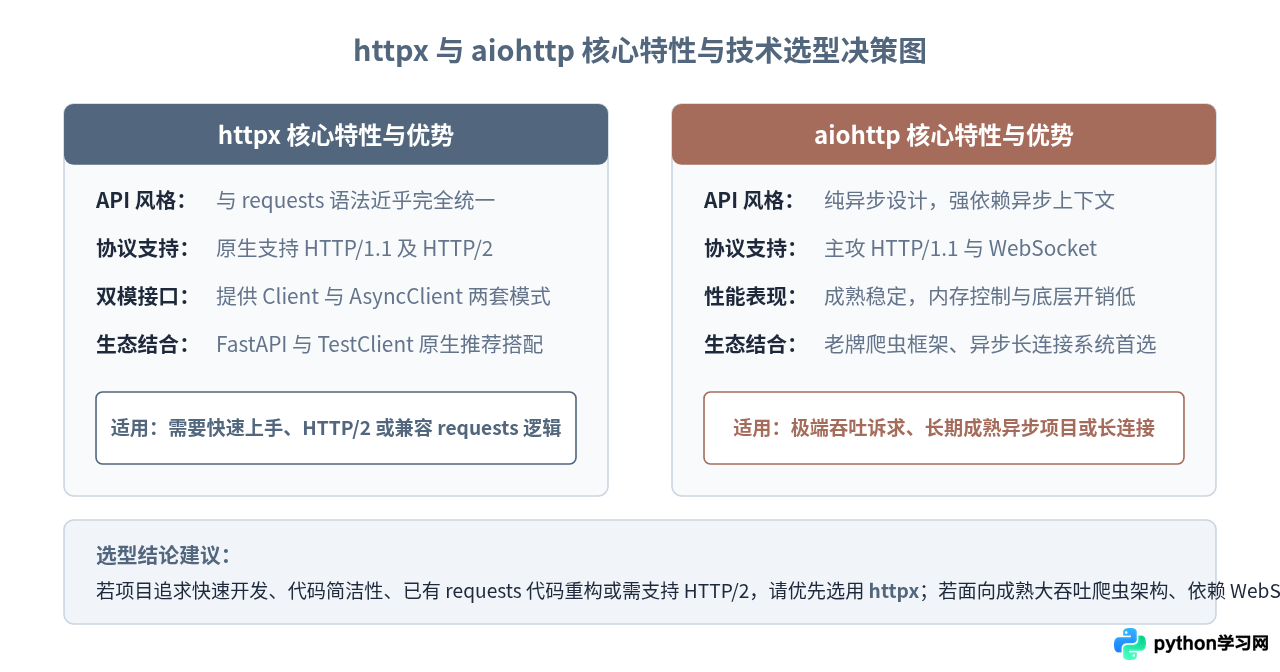
在 Python 异步 HTTP 客户端领域,httpx 与 aiohttp 是当下最主流的两个选择。了解它们的设计哲学与特性边界,是进行技术选型的前提:
- httpx:被称为“新一代 HTTP 客户端”。其最大的特色是提供了与 requests 高度一致的 API 设计,降低了认知门槛;同时原生支持 HTTP/1.1 与 HTTP/2 多路复用,并且同时提供同步接口(
httpx.Client)与异步接口(httpx.AsyncClient)。在现代 Web 框架(如 FastAPI)生态中,httpx 是官方重点推荐的基础库。 - aiohttp:作为 Python 异步生态的老牌中坚力量,aiohttp 专注于纯异步体系。它不仅是一个高并发客户端,还包含完整的异步 Web 服务端支持。aiohttp 经过长年生产环境的锤炼,性能稳定且执行开销极低,但在 API 设计上与 requests 存在差异,例如必须使用上下文管理器读取响应体(
async with resp: ...)。
三、实战操作:异步客户端并发调用步骤
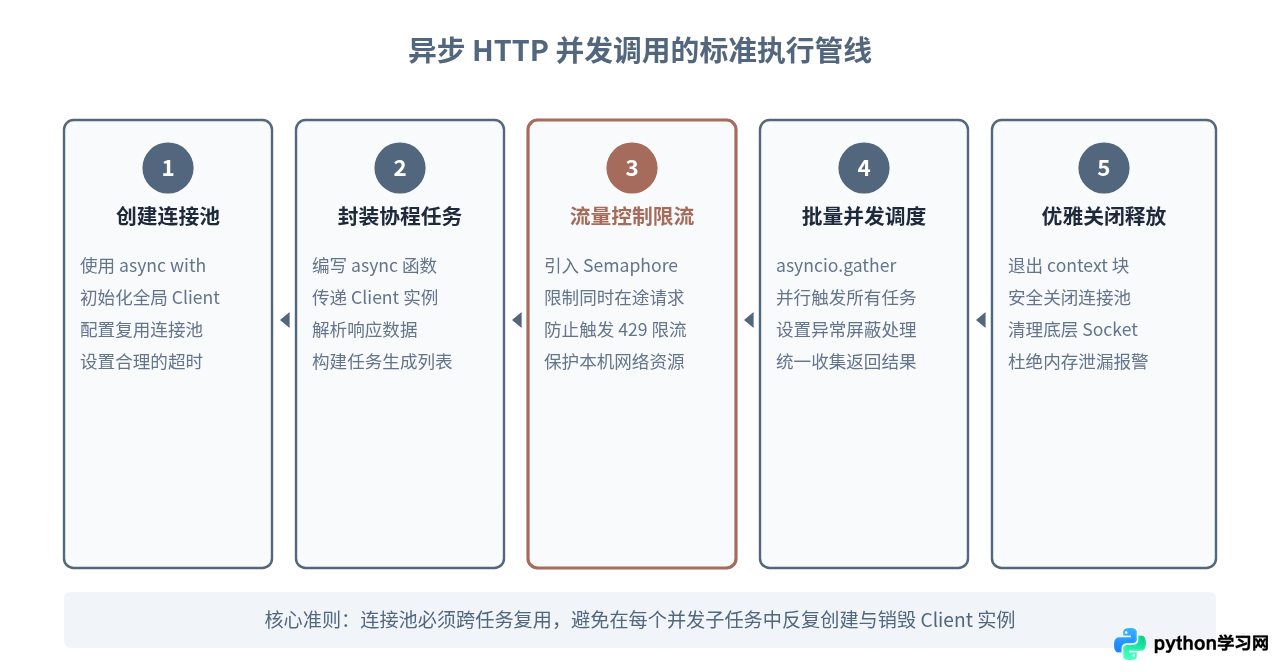
实现高效的异步接口并发调用通常包含五个标准步骤:会话初始化、请求封装、并发限流、批量调度与资源释放。下面分别针对 httpx 与 aiohttp 提供可直接运行的完整工程代码。
1. 使用 httpx 实现并发调用
首先在环境中安装支持 HTTP/2 的 httpx 库:
pip install "httpx[http2]"以下示例展示了使用 httpx.AsyncClient 配合连接池与超时配置执行批量并发调用的完整脚本:
import asyncio
import httpx

async def fetch_item(client: httpx.AsyncClient, item_id: int) -> dict:
    url = f"https://httpbin.org/get?id={item_id}"
    response = await client.get(url)
    response.raise_for_status()
    return response.json()

async def main():
    target_ids = list(range(1, 11))

    # 调优连接池容量与超时设置
    limits = httpx.Limits(max_keepalive_connections=20, max_connections=50)
    timeout = httpx.Timeout(10.0, connect=5.0)

    # 务必在最外层使用异步上下文管理器维持全局客户端,复用底层 TCP 连接
    async with httpx.AsyncClient(limits=limits, timeout=timeout, http2=True) as client:
        tasks = [fetch_item(client, i) for i in target_ids]
        # return_exceptions=True 确保单个请求失败不会中断其余任务
        results = await asyncio.gather(*tasks, return_exceptions=True)

        for i, res in enumerate(results, start=1):
            if isinstance(res, Exception):
                print(f"任务 {i} 执行异常: {res}")
            else:
                print(f"任务 {i} 调用成功: 返回 ID={res['args'].get('id')}")

if __name__ == "__main__":
    asyncio.run(main())
2. 使用 aiohttp 实现并发调用
在项目中安装 aiohttp:
pip install aiohttpaiohttp 需要使用 aiohttp.ClientSession,并在请求完成后通过 await response.json() 解析内容:
import asyncio
import aiohttp

async def fetch_item(session: aiohttp.ClientSession, item_id: int) -> dict:
    url = f"https://httpbin.org/get?id={item_id}"
    async with session.get(url) as response:
        response.raise_for_status()
        return await response.json()

async def main():
    target_ids = list(range(1, 11))

    # 通过 TCPConnector 管理并发连接池上限
    connector = aiohttp.TCPConnector(limit=50, limit_per_host=20)
    timeout = aiohttp.ClientTimeout(total=10.0, connect=5.0)

    async with aiohttp.ClientSession(connector=connector, timeout=timeout) as session:
        tasks = [fetch_item(session, i) for i in target_ids]
        results = await asyncio.gather(*tasks, return_exceptions=True)

        for i, res in enumerate(results, start=1):
            if isinstance(res, Exception):
                print(f"任务 {i} 执行异常: {res}")
            else:
                print(f"任务 {i} 调用成功: 返回 ID={res['args'].get('id')}")

if __name__ == "__main__":
    asyncio.run(main())
四、生产级优化:控制并发节奏与避坑实践
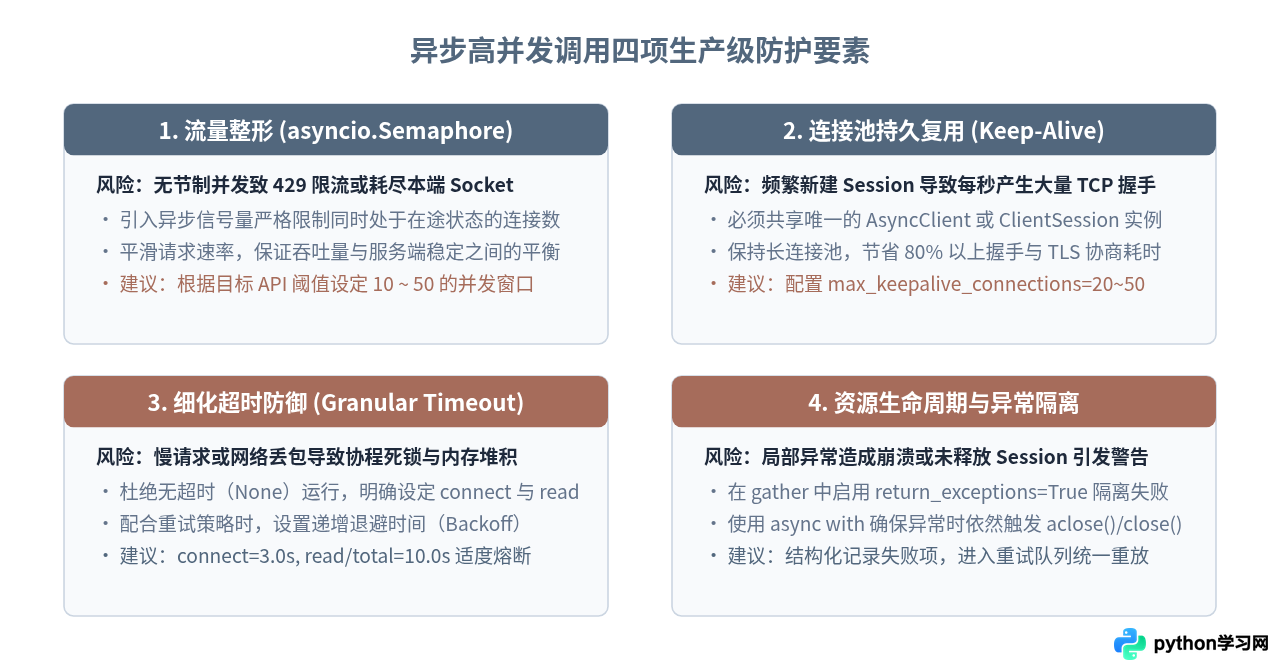
初学者在接触异步请求时,最容易犯的错误是直接将成千上万个任务一次性塞入 asyncio.gather。这种“暴力全量并发”往往会瞬间引发灾难:本地操作系统报出 Too many open files(文件描述符耗尽),或者远程服务端直接返回 429 Too Many Requests 并将调用方 IP 加入封禁黑名单。
使用信号量(Semaphore)实现安全受控并发
为了在保持高吞吐的同时避免击垮服务端,应当使用 asyncio.Semaphore 构造信号量门禁。以下代码演示了如何将 100 个请求平滑限制为“最多同时 10 个在途”:
import asyncio
import httpx

async def safe_fetch(sem: asyncio.Semaphore, client: httpx.AsyncClient, url: str) -> dict:
    # 通过异步信号量控制并发深度
    async with sem:
        try:
            resp = await client.get(url)
            resp.raise_for_status()
            return resp.json()
        except httpx.HTTPStatusError as exc:
            return {"error": f"HTTP错误: {exc.response.status_code}", "url": url}
        except httpx.RequestError as exc:
            return {"error": f"网络通信失败: {exc}", "url": url}

async def main():
    urls = [f"https://httpbin.org/get?item={i}" for i in range(100)]

    # 限制最大同时活跃请求数为 10
    sem = asyncio.Semaphore(10)

    async with httpx.AsyncClient(timeout=10.0) as client:
        tasks = [safe_fetch(sem, client, u) for u in urls]
        # 任务被有序推进,既不会耗尽本地资源,也不会触发服务端防御限流
        results = await asyncio.gather(*tasks)
        print(f"全部 {len(results)} 个请求调度完成,首个结果状态:{'error' not in results[0]}")

if __name__ == "__main__":
    asyncio.run(main())
五、常见问题排查与注意事项
在 aiohttp 或 httpx 运行结束时,若终端输出类似
Unclosed client session 的警告,说明客户端会话未被正确释放。最直接的排查方式是检查代码中是否遗漏了 async with 上下文包裹,或者在手动实例化 Client 后是否调用了 await client.aclose()。
异步机制提升的是系统的并发吞吐量(QPS),而非缩短某个具体请求的网络延迟。如果某个外部接口由于服务端计算缓慢需要 3 秒响应,异步调用该接口依然需要 3 秒;但借助异步,你在等待这 3 秒的同时,可以同时分发并等待其他数百个请求,使系统整体吞吐量成数十倍攀升。
六、总结
通过使用 httpx 或 aiohttp 替代传统的同步请求库,Python 能够在单线程内以极低开销处理高密度的网络 I/O 任务。在实际工程落地中,请牢记以下实践原则:
- 长连接复用:始终在应用生命周期内保持全局唯一的会话实例,避免重复创建 Client。
- 节制并发:绝不使用不受控的“全量并发”,统一借助
asyncio.Semaphore设定合理的限流窗口。 - 超时与容错:显式配置连接与读取超时,并在
asyncio.gather中使用return_exceptions=True实现故障隔离。
根据团队的技术栈习惯进行选型——如果更看重与 requests 的延续性、现代 FastAPI 生态或 HTTP/2 协议,请毫不犹豫选择 httpx;如果在构建追求极限吞吐的爬虫或长连接后台,aiohttp 则是经过时间检验的坚实基石。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















