


Python怎么使用key参数实现多条件自定义排序
详细讲解在Python中使用sort()和sorted()的key参数实现多条件自定义排序的完整方法,包含元组字典序比较原理、数值正反向排序技巧、非数值混合排序方案以及常见陷阱规避。
一、核心机制:key 参数与元组比较原理
Python 内置的 list.sort() 方法和 sorted() 全局函数都接收一个可选的 key 参数。key 接收一个函数对象,在排序前为序列中的每一个元素计算一个“比较基准值”。排序算法(Timsort)不再直接比较原元素,而是依据 key 返回的值来决定元素的前后顺序。
当需要根据多个条件进行排队时(例如:成绩先排第一位,成绩相同时按年龄排序),最直接的解法就是让 key 函数返回形如 (条件1, 条件2, ...) 的元组。
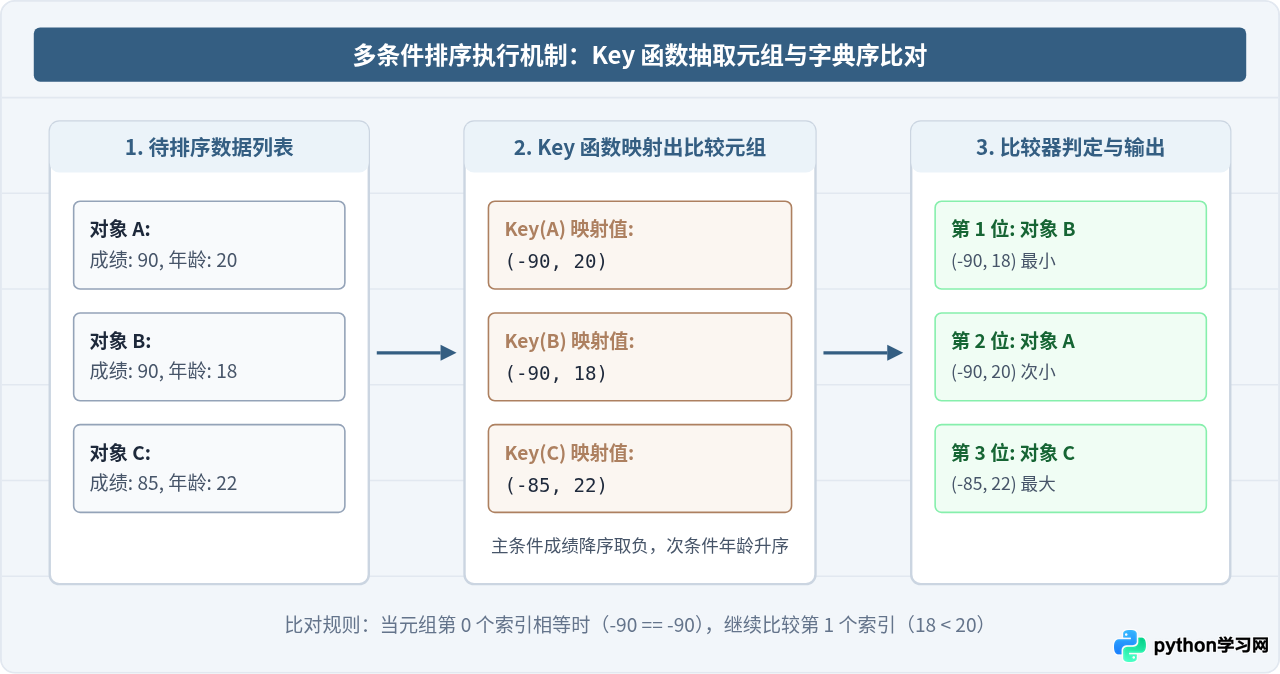
Python 对元组的比较规则非常明确:
# 元组比较示例
print((90, 18) < (90, 20))  # True,第一项相同,比较第二项 18 < 20
print((85, 99) < (90, 10))  # True,第一项 85 < 90,直接得出结果,不再比较第二项
二、基础实践:同向排序与数值异向排序
1. 所有条件保持同向(全升序或全降序)
如果所有排序维度的方向一致,只需直接把字段按优先级放入元组中。如果需要整体降序,直接在 sort() 或 sorted() 中指定 reverse=True 即可。
students = [
    {"name": "张三", "score": 88, "age": 20},
    {"name": "李四", "score": 95, "age": 19},
    {"name": "王五", "score": 88, "age": 18},
    {"name": "赵六", "score": 95, "age": 21}
]

# 需求:成绩从低到高升序;成绩相同时,年龄从小到大升序
sorted_asc = sorted(students, key=lambda s: (s["score"], s["age"]))
print("双升序结果:", [(s["name"], s["score"], s["age"]) for s in sorted_asc])
# 示例输出:[('王五', 88, 18), ('张三', 88, 20), ('李四', 95, 19), ('赵六', 95, 21)]

# 需求:成绩从高到低降序;成绩相同时,年龄从大到小降序
sorted_desc = sorted(students, key=lambda s: (s["score"], s["age"]), reverse=True)
print("双降序结果:", [(s["name"], s["score"], s["age"]) for s in sorted_desc])
# 示例输出:[('赵六', 95, 21), ('李四', 95, 19), ('张三', 88, 20), ('王五', 88, 18)]
2. 混合方向(数值维度一升一降)
在实际开发中,最普遍的需求是“条件一降序,条件二升序”(例如:成绩高者排前面,同分者年龄小者排前面)。此时 reverse=True 会将所有字段同时倒序,无法直接满足需求。
针对数值类型(int、float、Decimal 等),最简单且地道(Pythonic)的做法是通过添加负号 - 将降序维度取反。数值越小,取负后数值越大;原本最大的数取负后变成最小,从而在默认的升序排序中排在最前。
# 需求:成绩降序(高分在前),成绩相同时年龄升序(年轻在前)
sorted_mixed = sorted(students, key=lambda s: (-s["score"], s["age"]))
print("成绩降序+年龄升序:", [(s["name"], s["score"], s["age"]) for s in sorted_mixed])
# 示例输出:[('李四', 95, 19), ('赵六', 95, 21), ('王五', 88, 18), ('张三', 88, 20)]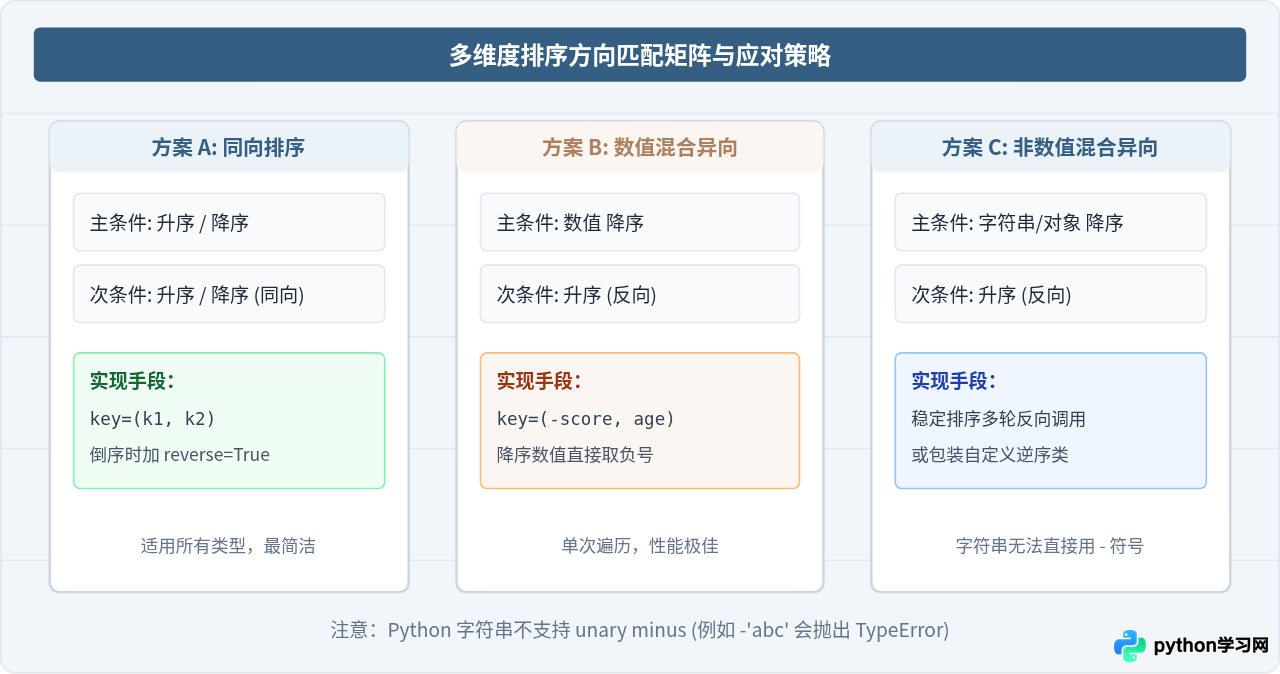
三、进阶难题:非数值类型(如字符串)的异向排序
Python 不允许对字符串做单目取负运算(即 -"zhangsan" 会抛出 TypeError: bad operand type for unary -: 'str')。如果排序要求中包含“字符串主条件降序,次条件升序”,我们有两种标准解决路径:
方法 1:利用 Python 排序的“稳定性”分步排序(最推荐)
Python 的 Timsort 算法是稳定排序(Stable Sort)。这意味着如果两个元素的比较键相同,排序后它们将严格保留原有的相对位置。
基于稳定性原理,我们可以从最低优先级向最高优先级倒序执行排序:先排次要条件,再排主要条件。后一次排序不会打乱前一次在同优先级分组内的相对顺序。
records = [
    {"dept": "研发部", "user": "Charlie"},
    {"dept": "市场部", "user": "Alice"},
    {"dept": "研发部", "user": "Bob"},
    {"dept": "市场部", "user": "David"}
]

# 需求:部门(dept)降序,部门相同时名字(user)升序
# 步骤 1:先按次要条件(user)升序排序
records.sort(key=lambda x: x["user"], reverse=False)

# 步骤 2:再按主要条件(dept)降序排序
records.sort(key=lambda x: x["dept"], reverse=True)

print("稳定排序多轮调用结果:")
for r in records:
    print(r)
# 示例输出:
# {'dept': '研发部', 'user': 'Bob'}
# {'dept': '研发部', 'user': 'Charlie'}
# {'dept': '市场部', 'user': 'Alice'}
# {'dept': '市场部', 'user': 'David'}
在上述代码中,第一轮使所有员工名字按升序排列;第二轮按部门倒序排,研发部排在市场部之前。当第二轮比较两个同属于“研发部”的员工时,由于键值相同,Timsort 保持了它们在第一轮排好的 Bob < Charlie 顺序。
方法 2:构建逆序包装类(单次排序法)
如果不想在原列表上多次调用 sort(),可以编写一个轻量包装类,重载 __lt__(小于)方法,反转字符串之间的比较逻辑:
class ReverseString:
    __slots__ = ("value",)
    def __init__(self, value: str):
        self.value = value
    def __lt__(self, other: "ReverseString") -> bool:
        # 反转比较:原值大的排在前面
        return self.value > other.value
    def __eq__(self, other: "ReverseString") -> bool:
        return self.value == other.value

# 此时可以在同一个 key 元组内直接混用
items = [
    {"dept": "研发部", "user": "Charlie"},
    {"dept": "市场部", "user": "Alice"},
    {"dept": "研发部", "user": "Bob"}
]

# 部门降序,用户名升序
sorted_items = sorted(items, key=lambda x: (ReverseString(x["dept"]), x["user"]))
print([(x["dept"], x["user"]) for x in sorted_items])
# 示例输出:[('研发部', 'Bob'), ('研发部', 'Charlie'), ('市场部', 'Alice')]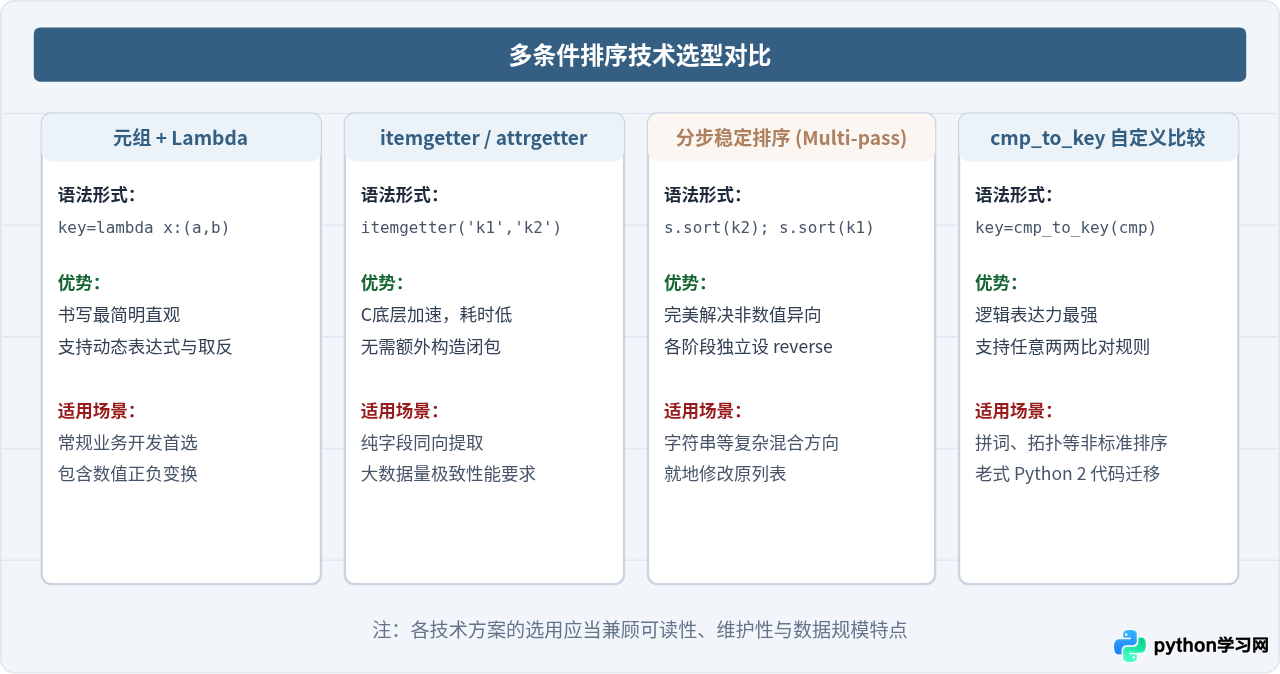
四、工具库加速:使用 operator 提升代码性能与整洁度
当排序对象是字典、元组或自定义对象,并且不需要在字段上进行动态修改或数值取反时,建议优先使用 Python 标准库中的 operator.itemgetter 或 operator.attrgetter。
这两个函数是由 C 语言底层实现的,可以直接接收多个键或属性名,其内部自动打包并返回元组,比在 Python 层面频繁调用 lambda 更加高效且整洁。
1. 对字典或元组使用 itemgetter
from operator import itemgetter

users = [
    {"role": "admin", "score": 100},
    {"role": "editor", "score": 80},
    {"role": "admin", "score": 90}
]

# 一次性提取 ('role', 'score') 组成元组进行双升序排序
sorted_users = sorted(users, key=itemgetter("role", "score"))
print(sorted_users)
# 示例输出:
# [{'role': 'admin', 'score': 90}, {'role': 'admin', 'score': 100}, {'role': 'editor', 'score': 80}]
2. 对类对象使用 attrgetter
from operator import attrgetter

class Product:
    def __init__(self, category: str, price: float):
        self.category = category
        self.price = price
    def __repr__(self):
        return f"Product({self.category!r}, {self.price})"

products = [
    Product("Electronics", 999.0),
    Product("Books", 45.0),
    Product("Electronics", 199.0)
]

# 按分类升序,分类相同时按价格升序
products.sort(key=attrgetter("category", "price"))
print(products)
# 示例输出:[Product('Books', 45.0), Product('Electronics', 199.0), Product('Electronics', 999.0)]
五、常见开发陷阱与注意事项
1. 元组中包含 None 导致的 TypeError
在 Python 3 中,None 与数值、字符串等不同类型之间不支持大小比较(例如 None < 0 会直接抛出 TypeError: '<' not supported between instances of 'NoneType' and 'int')。
如果待排序数据中的次要字段存在缺失值(None),必须先进行类型对齐,或者在元组中显式加入布尔标记,指定缺失值的放置位置:
data = [
    {"id": 1, "priority": 10},
    {"id": 2, "priority": None},
    {"id": 3, "priority": 5}
]

# 策略:将 None 统一放在最后面(升序)
# 利用元组比较:False < True,有值标记为 False(排前),None 标记为 True(排后)
sorted_data = sorted(data, key=lambda x: (x["priority"] is None, x["priority"]))
print("None 置后结果:", sorted_data)
# 示例输出:[{'id': 3, 'priority': 5}, {'id': 1, 'priority': 10}, {'id': 2, 'priority': None}]
2. 避免在 key 中执行高开销运算
虽然 Python 内部会对每个元素只调用一次 key 函数(缓存结果到修饰列表),但如果列表元素量达到数十万级,而在 key 函数内部执行深度解析、数据库查询或正则匹配,仍会显著拖慢性能。建议在排序前将复杂字段在数据预处理阶段清洗完成。
3. 注意 sort() 与 sorted() 的选择
list.sort():就地(in-place)修改原列表,内存开销最小,返回值为None。sorted(iterable):不修改原对象,返回一个全新的排好序的list,支持任何可迭代对象(如元组、字典视图、集合等)。
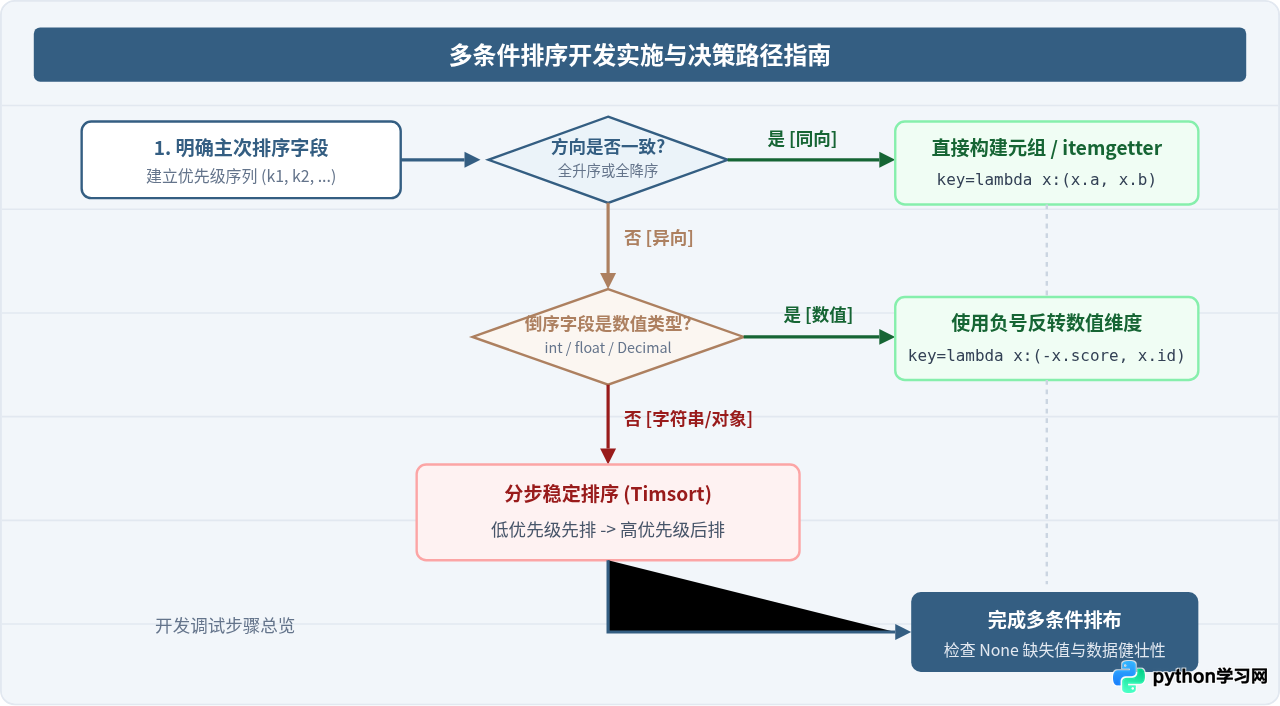
六、全文总结
在 Python 中处理多条件自定义排序时,核心逻辑清晰可循:
- 核心机制:
key函数返回比较元组(主条件, 次条件, ...),依赖 Python 内置的元组字典序逐项比对特性。 - 同向排序:所有条件方向相同时,直接构建元组;若整体降序,指定
reverse=True。若无需额外加工,优先使用operator.itemgetter或attrgetter提升运行效率。 - 数值异向排序:针对需要降序的数值字段,直接加上负号
-,即可在默认升序规则下完美达成“降序+升序”混合排布。 - 非数值异向排序:无法取负时(如字符串),利用 Python 的稳定排序特性进行多次分步
sort(),先排次要条件,后排主要条件,或使用自定义逆序包装类。 - 异常防范:如果排序字段中存在
None,通过(x is None, x)构造布尔标记,确保比较双方类型兼容。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















