


解决Python写入Elasticsearch时的JSON序列化与格式错误
针对Python写入Elasticsearch时常见的客户端JSON序列化失败与服务端格式解析错误,系统梳理问题根源、类型转换方案、自定义序列化器实现以及Bulk批量写入的正确实践。
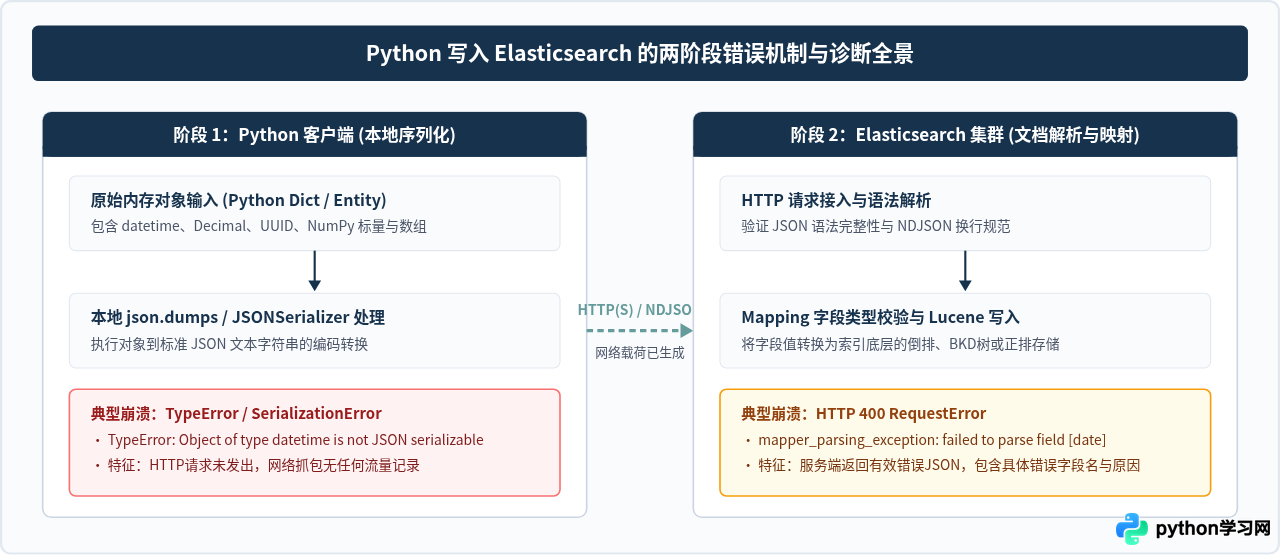
在Python应用向Elasticsearch写入数据的过程中,报错通常分为两个独立阶段:一是Python原生JSON库无法直接处理datetime、Decimal、UUID或numpy对象引发的客户端序列化异常;二是请求体到达Elasticsearch后因字段类型冲突或格式不规范触发的集群端解析异常。解决这类问题的关键在于理清两阶段的处理边界,建立统一的类型转换函数并配置客户端序列化器,同时规范Bulk换行格式与映射契约。
一、明确错误的发生阶段:客户端与服务端
排查写入问题时,首要动作是区分报错究竟来自本地Python进程还是来自Elasticsearch集群返回的HTTP错误响应。两者的根因与修复位置截然不同:
- 客户端序列化错误(发生在网络请求发出前):Python官方库
json.dumps()只支持基本数据类型(如dict、list、str、int、float、bool及None)。一旦字典内包含Python的datetime.datetime、decimal.Decimal、uuid.UUID或数据分析中常见的numpy.ndarray、pandas.NaT,Python会在本地直接抛出TypeError: Object of type ... is not JSON serializable或elasticsearch.exceptions.SerializationError,此时HTTP网络请求压根尚未发送。 - 服务端文档解析错误(发生在网络请求成功送达后):虽然客户端成功将数据编码为合法JSON字符串并送出,但Elasticsearch解析字段时发现数据结构与目标索引的Mapping定义冲突,例如将非标准格式的字符串写入
date字段、向integer字段传入浮点数或非法文本,此时集群会返回HTTP 400状态码,并附带mapper_parsing_exception、illegal_argument_exception或json_parse_exception。
二、解决客户端 JSON 序列化错误
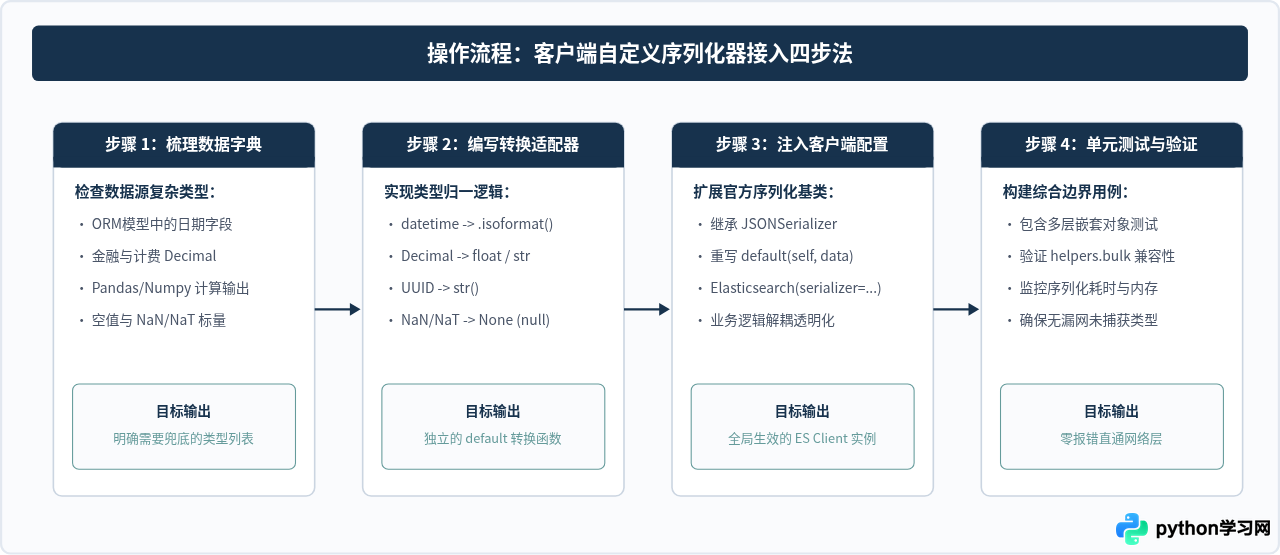
Python 字典要传递给 Elasticsearch 官方客户端(如 elasticsearch-py)的 index() 或 helpers.bulk() 时,底层都会通过序列化机制将字典对象转换成 JSON 文本。如果包含非基础类型,必须通过显式转换或自定义 Serializer 完成转换。
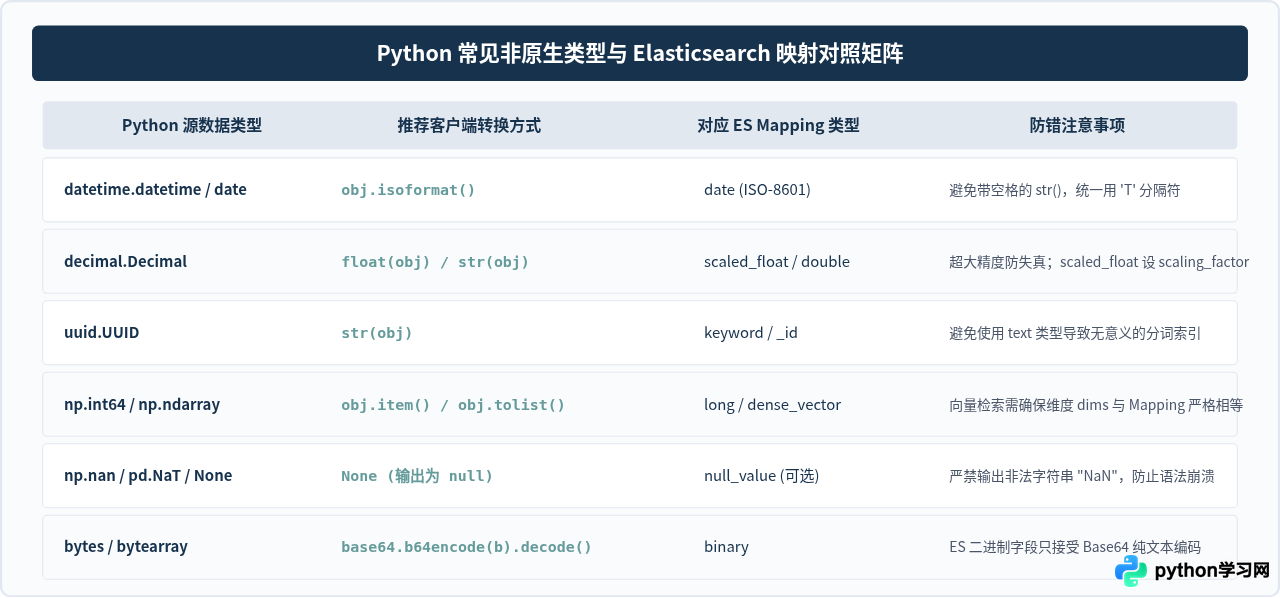
1. 常见不被原生 JSON 支持的数据类型
datetime.datetime/datetime.date:ES 支持 ISO-8601 标准字符串。Python 时间对象需要转换为.isoformat()格式。decimal.Decimal:常用于金融与精确计数,原生json.dumps无法编码。若精度允许,可转为float;若需极高精度并使用 ES 的scaled_float,可转为浮点或字符串。uuid.UUID:常用于业务主键或追踪 ID,需转为str(uuid_obj)。numpy标量与数组(int64,float32,ndarray):从 Pandas 或机器学习流水线提取的数据,int64不是 Python 原生int,需通过.item()或.tolist()转为原生结构。np.nan/pd.NaT:在原生 JSON 中,NaN会被转为不符合严格 JSON 标准的NaN标识符,ES 解析时易报语法错误。应在序列化前将其处理为None(映射为 JSON 的null)。
2. 通用类型转换函数与自定义 JSON 编码器
在项目中,最优雅且侵入性最小的做法是编写一个统一的兜底转换函数 json_default_converter,或者自定义继承自 json.JSONEncoder 的编码类,并将其注册到 Elasticsearch 客户端中。
import json
import decimal
import uuid
import datetime
import numpy as np
import pandas as pd
from elasticsearch import Elasticsearch
from elasticsearch.serializer import JSONSerializer

def es_json_default_converter(obj):
    """
    针对常见 Python 复杂类型的标准化 JSON 转换兜底函数
    """
    if isinstance(obj, (datetime.datetime, datetime.date)):
        return obj.isoformat()
    if isinstance(obj, decimal.Decimal):
        return float(obj)
    if isinstance(obj, uuid.UUID):
        return str(obj)
    if isinstance(obj, (np.integer, np.int64, np.int32)):
        return int(obj)
    if isinstance(obj, (np.floating, np.float64, np.float32)):
        if np.isnan(obj):
            return None
        return float(obj)
    if isinstance(obj, np.ndarray):
        return obj.tolist()
    if pd.isna(obj):
        return None
    raise TypeError(f"Object of type {obj.__class__.__name__} is not JSON serializable")

# 基于 elasticsearch-py 的自定义序列化器
class CustomESSerializer(JSONSerializer):
    def default(self, data):
        return es_json_default_converter(data)

# 初始化客户端时指定序列化器
es = Elasticsearch(
    hosts=["http://localhost:9200"],
    serializer=CustomESSerializer()
)关键提示:在配置了 CustomESSerializer 之后,无论是直接调用 es.index(index="my_index", document=doc) 还是通过 helpers.bulk(es, actions),客户端在底层序列化时都会自动触发 default 转换,无需在业务代码各处繁琐地手动调用 str() 或 isoformat()。
三、解决服务端格式错误与映射冲突
当网络请求成功送达 Elasticsearch 后,如果收到 400 系列异常,说明文档已脱离 Python 序列化问题,进入了集群端格式检验与 Mapping 约束阶段。最常见的报错有三类:
1. 日期格式解析失败:failed to parse field of type [date]
Elasticsearch 默认的 date 类型支持 strict_date_optional_time||epoch_millis。如果在 Python 端直接调用 str(datetime.datetime.now()),输出类似 2026-10-17 14:30:00(中间为空格),在缺少对应格式配置时,ES 会拒绝解析并抛出异常:
RequestError(400, 'mapper_parsing_exception',
'failed to parse field [created_at] of type [date] in document with id ...
Preview of field\'s value: \'2026-10-17 14:30:00\'')解决办法:在 Python 侧统一使用 .isoformat() 生成带 T 分隔符的标准字符串(如 2026-10-17T14:30:00);或者在创建索引模板时,在 Mapping 中显式配置日期格式模式:
"created_at": {
  "type": "date",
  "format": "yyyy-MM-dd HH:mm:ss||yyyy-MM-dd'T'HH:mm:ss.SSSZ||epoch_millis"
}
2. 字段类型冲突:cannot be changed from type [A] to [B]
当索引采用动态映射(Dynamic Mapping)时,如果第一条写入的数据中 status: 200,ES 会将其推断为 long 类型;随后写入的一批数据中 status: "active" 为字符串,ES 就会直接抛出类型冲突错误。动态推断容易让前期小规模测试正常,后期一旦出现脏数据便导致批量任务中断。
解决办法:在生产环境中坚决禁用或严格限制动态映射,提前通过 Index Template 声明所有字段的明确类型(例如显式指定为 keyword、text、integer 或 float),并在 Python 写入前进行严格的契约校验。
3. 批量写入 Bulk API 的 NDJSON 换行与格式问题
使用 Elasticsearch _bulk API 时,数据格式不是标准的单个 JSON Array,而是 NDJSON(Newline Delimited JSON)。每一行必须是独立的单行 JSON 对象,且最后一行必须以换行符 \n 结尾。
常见踩坑点是:文本字段内部本身包含未转义的原生换行符 \n,或者手动拼接字符串时缺少了换行隔断。若直接使用 elasticsearch.helpers.bulk(),该方法会自动处理元数据行与数据行的 NDJSON 生成,避免手动拼接错误。
四、生产级批量写入与容错验证实践
在海量数据同步或实时流处理场景中,逐条调用 es.index() 性能极低。通常采用官方 helpers.bulk 或 helpers.streaming_bulk。为了防止由于某一行数据的格式问题导致整批写入被中断,必须配置妥善的容错与错误收集策略。
1. 稳健的 Bulk 批量写入代码示例
import logging
from elasticsearch import Elasticsearch
from elasticsearch.helpers import bulk, BulkIndexError

logger = logging.getLogger("es_sync")

def safe_bulk_index(es_client, index_name, documents, chunk_size=500):
    """
    生产级安全批量写入函数:
    1. 自动转换每个文档的 action 字典
    2. 设置 raise_on_error=False,防止单个脏数据文档阻断整个批次
    3. 收集并记录未成功写入的记录详情
    """
    actions = [
        {
            "_index": index_name,
            "_id": doc.get("id"),  # 如果有业务ID则指定,否则由ES自动生成
            "_source": doc
        }
        for doc in documents
    ]

    success_count = 0
    failed_items = []

    try:
        # raise_on_error=False 允许批次中部分失败时继续执行
        # stats_only=False 会返回具体的错误详情列表
        success, details = bulk(
            es_client,
            actions,
            chunk_size=chunk_size,
            raise_on_error=False,
            stats_only=False
        )
        success_count = success

        # 遍历明细,提取失败原因
        for item in details:
            action_type = next(iter(item))
            info = item[action_type]
            if "error" in info:
                failed_items.append({
                    "id": info.get("_id"),
                    "status": info.get("status"),
                    "reason": info.get("error")
                })

    except BulkIndexError as bie:
        # 当 raise_on_error=True 或发生网络级严重故障时触发
        logger.error(f"批量写入严重错误: 共 {len(bie.errors)} 条记录写入失败")
        for err in bie.errors:
            logger.error(f"失败明细: {err}")
        raise

    logger.info(f"批量写入完成: 成功 {success_count} 条,失败 {len(failed_items)} 条")
    if failed_items:
        # 可写入死信队列或本地日志供后续补偿
        logger.warning(f"失败文档示例: {failed_items[:3]}")

    return success_count, failed_items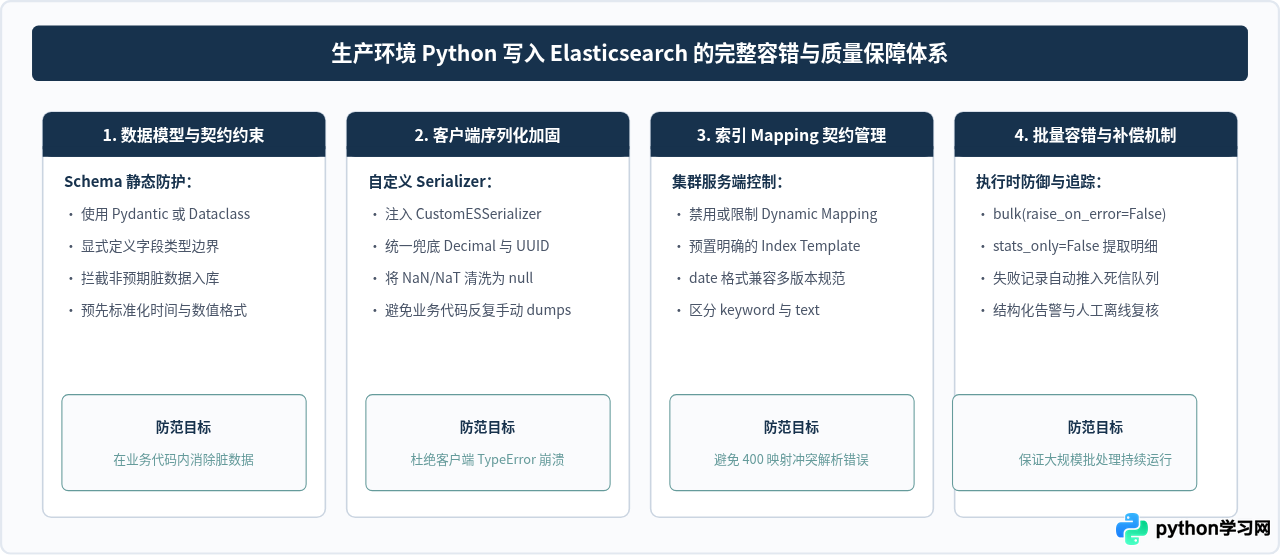
五、常见问题与排错清单
在日常运维或业务迭代中,如果再次遇到写入报错,可以按照以下顺序快速排查并验证:
- 确认报错栈顶端类名:若包含
TypeError或json.encoder,直接在本地打印待序列化对象的各个字段类型,重点检查datetime、Decimal与 Pandas 衍生值。 - 确认响应状态码:若收到
RequestError(400, ...),展开查看返回字典中的error.caused_by,准确定位报错的字段名与预期类型。 - 确认日期字符串格式:若字段类型为
date,检查传入的字符串中间是空格还是T,以及微秒位数是否超出 Elasticsearch 配置的格式定义。 - 避免浮点数精度截断:金融计算如果使用了
Decimal,转换为float后可能会丢失部分微小精度。如果字段定义要求绝对精度,优先配置 ES 的scaled_float并在 Python 中显式处理,或将其存为keyword。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















