


Python csv模块与pandas读取CSV性能对比及选型建议
深入对比 Python 原生 csv 模块与 pandas.read_csv 的运行机制、读取速度、内存占用及适用场景,提供清晰的工程选型决策路径。
在 Python 中读取 CSV 数据时,原生 csv 模块采用流式迭代器逐行解析,具有极致的内存控制力和零额外依赖,适合轻量级任务或行级过滤流水线;而 pandas 依托底层 C/PyArrow 引擎将文本批量装入连续内存块,解析速度与向量化计算能力极强,但通常消耗文件体积 3 到 5 倍的峰值内存。工程选型的核心是权衡内存边界与下游计算复杂度。
一、底层机制与数据加载原理
理解两个工具的性能表现,必须首先拆解它们将磁盘上的字符流转化为内存对象的方式。两者的设计目标完全不同,因而决定了截然不同的数据流向和资源开销机制。
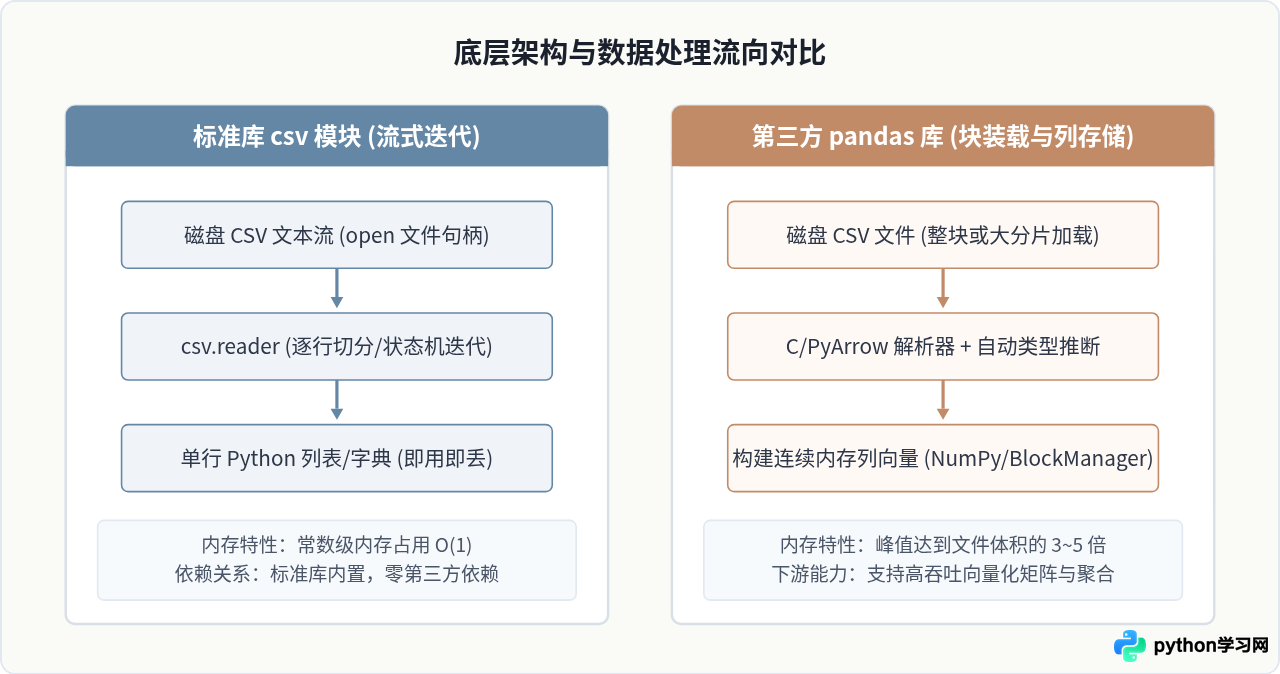
Python 标准库的 csv 模块本质上是一个字符串流迭代器。当调用 csv.reader() 时,底层 Python 解释器依托 I/O 缓冲区,按行读取换行符分隔的文本,依照设定的分隔符切分字段,并生成纯 Python 列表(或 DictReader 生成的字典对象)。每次循环步进,前一行的数据对象若未被外部保留,就会进入垃圾回收周期。整个过程的内存占用接近于常数级别 O(1)。
与之相反,pandas.read_csv() 的目标是构建一个富类型的结构化二维数据表(DataFrame)。其内部默认调用 C 编写的高速解析引擎(或可选的 PyArrow 引擎)。解析器一次性把文本批量读入缓冲区,经过多行类型推断后,将每一列紧凑排列为连续内存块(NumPy ndarray 或 Arrow Table)。构造这些类型数组需要完整的元数据、索引结构以及批量中间缓冲,因此不仅耗费显著的瞬时内存,还需要依赖庞大的第三方依赖包。
二、关键性能指标对比:时间与内存开销
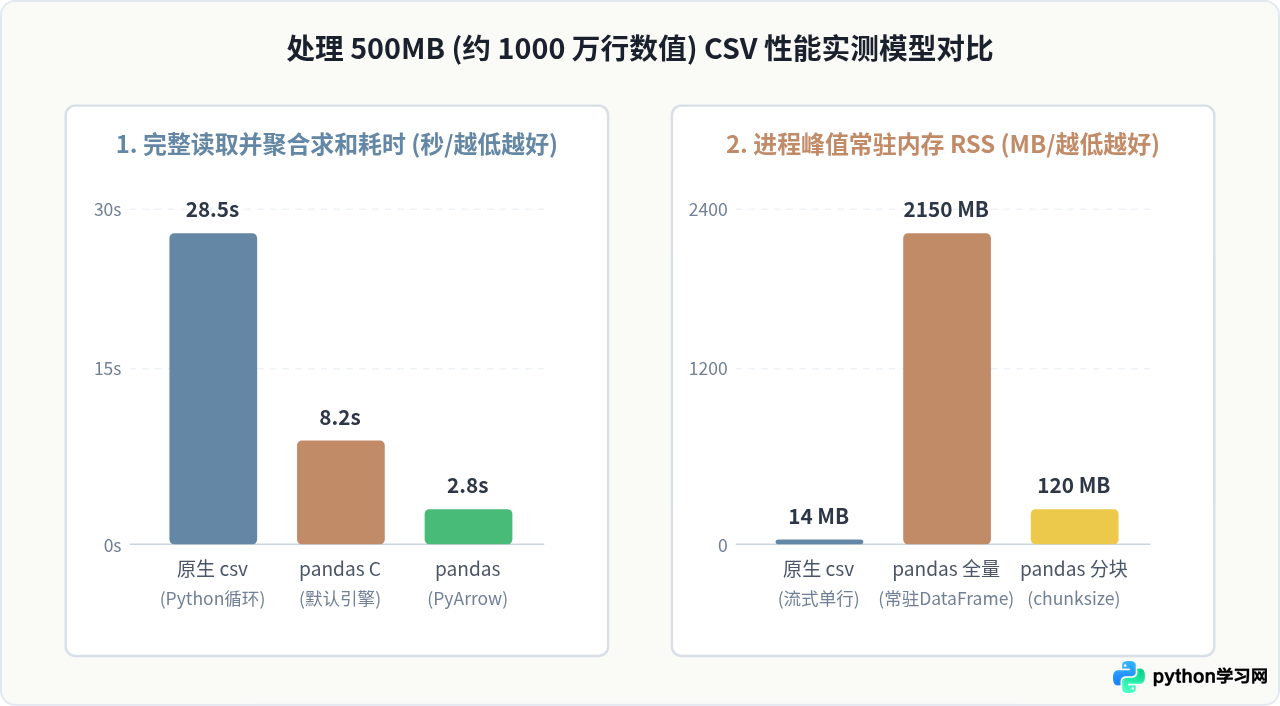
在实际工程场景中,衡量 CSV 处理性能的核心指标有两个:纯解析与计算耗时,以及峰值常驻内存(RSS)。两者往往呈现互为代价的关系。
1. 解析耗时比较
对于小型文本(例如小于 10MB、几万行以内),两者在绝对耗时上的差距通常只有几十毫秒。但在几百兆甚至上千万行的大数据量下,pandas.read_csv() 的 C 解析器速度通常是原生 csv.reader 的 3 至 8 倍。若启用 engine="pyarrow",利用多线程并发与现代 SIMD 向量化指令,解析速度还能进一步翻倍。
原生 csv 之所以较慢,是因为每行数据都必须在 Python 虚拟机层面经历一次列表构建,遇到数字还需要调用 int() 或 float() 执行单值类型转换,频繁触发解释器层面的循环和函数调用开销。而 pandas 将全部运算集中在底层 C 代码块中批量执行,从而规避了 Python 虚拟机的解释器瓶颈。
2. 内存占用差异
内存占用是 pandas 最容易导致工程事故的短板。一个在磁盘上大小为 500MB 的 CSV 文件,包含大量的浮点数、整数与字符串。当 pandas 默认将其读入内存时,为了构建灵活的索引、支持缺失值判定(如将整型升级为 float64 或装载通用 object 指针),内存体积通常膨胀为 1.5GB 至 2.5GB。一旦内存不足,会触发操作系统的频繁换页甚至触发 OOM 崩溃退出。
而使用标准库 csv 遍历时,由于是单行循环读取,驻留内存的永远只是当前行的少量字符串。只要不在代码中用全局列表累加每行数据,处理 10GB 的 CSV 文件同样只需要十几兆常驻内存。
三、核心操作模式与代码实现对比
在编写业务代码时,两者的编程范式存在显著差异。以下通过具体的典型场景展示两者编写与运行逻辑的不同。
场景 1:逐行过滤与简单数据清洗
如果业务目标只是从大量记录中过滤符合某个条件的行,并写入数据库或新文件,原生 csv 模块写起来直观且极其可靠:
import csv

# 示例:使用 csv.DictReader 进行低内存开销的行级过滤
matched_count = 0
total_amount = 0.0

with open("transactions.csv", mode="r", encoding="utf-8") as f:
    reader = csv.DictReader(f)
    for row in reader:
        # 单行操作:仅当满足状态为 SUCCESS 时处理
        if row["status"] == "SUCCESS":
            matched_count += 1
            total_amount += float(row["amount"])

print(f"成功笔数: {matched_count}, 总额: {total_amount:.2f}")
在这段代码中,无论 transactions.csv 包含 1 万行还是 1 亿行,程序占用的物理内存始终固定在十几兆,不会随着文件增大而攀升。
场景 2:多列统计分析与矩阵计算
如果需要进行分组统计(GroupBy)、列间加权计算或滑动窗口运算,使用原生 csv 模块需要手动维护复杂的嵌套字典并编写类型转换逻辑,容易出错且运行缓慢;而使用 pandas 则是极其精炼的几行向量化表达:
import pandas as pd

# 示例:使用 pandas 进行列级向量化筛选与分组汇总
df = pd.read_csv("transactions.csv", usecols=["status", "department", "amount"])

# 过滤并按部门统计均值与总和
summary = (
    df[df["status"] == "SUCCESS"]
    .groupby("department")["amount"]
    .agg(["count", "sum", "mean"])
)
print(summary)
通过指定 usecols 参数,pandas 仅会解析指定的列,这在一定程度上缓解了内存浪费。然而,如果数据规模极大,pandas 提供了分块迭代读取的折中机制:
import pandas as pd

# 示例:pandas.read_csv 结合 chunksize 实现流式分组汇总
chunk_results = []
for chunk in pd.read_csv("transactions.csv", chunksize=100000):
    valid_data = chunk[chunk["status"] == "SUCCESS"]
    chunk_results.append(valid_data.groupby("department")["amount"].sum())

# 合并各分块汇总结果
final_sum = pd.concat(chunk_results).groupby("department").sum()虽然 read_csv(chunksize=...) 能够限制内存占用,但每个 chunk 依旧会产生 DataFrame 对象的初始化开销。如果块内只是做极其朴素的字段提取,原生 csv 的纯流式迭代速度往往并不逊色,且不依赖任何安装包。
四、工程选型决策路径
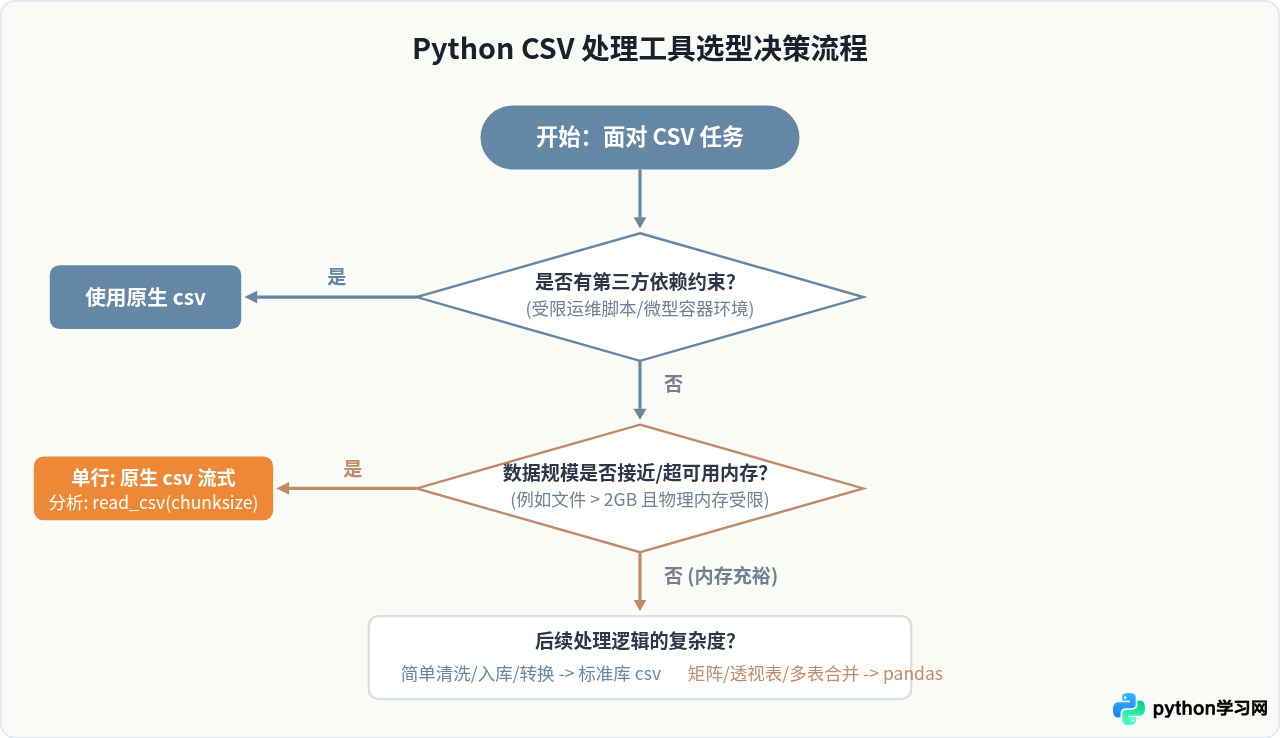
在面对具体的项目或脚本开发时,不要盲目引入重量级的数据科学工具链,也不要固守原生的基础操作。可以通过以下逻辑树来选择最适合的技术方案:
五、综合指标对比与落地方案
为了便于在架构评审与技术选型时快速参考,以下表格梳理了两者在核心维度上的具体表现:
| 对比维度 | Python 标准库 csv 模块 | pandas.read_csv |
|---|---|---|
| 环境依赖 | Python 标准库自带,零外部依赖 | 需安装 pandas、numpy 等依赖包,依赖体积约 80MB+ |
| 内存占用机制 | 流式逐行解析,常数级内存 O(1) |
整表加载,通常需消耗磁盘文件大小的 3 至 5 倍内存 |
| 纯文件解析速度 | 受限于 Python 循环与单值转换,速度一般 | 底层 C 解析器加速;开启 pyarrow 时速度极快 |
| 数据清洗与校验 | 支持极细粒度的按行异常捕获与自定义逻辑 | 基于向量化规则清洗,对不规则行需配置额外容错参数 |
| 统计与聚合支持 | 需手写循环与数据结构,开发成本高 | 提供丰富的 groupby、rolling、pivot 等内置分析函数 |
| 大文件支持能力 | 天然支持超大文件,无内存溢出风险 | 全量读取极易 OOM,需显式使用 chunksize 分块 |
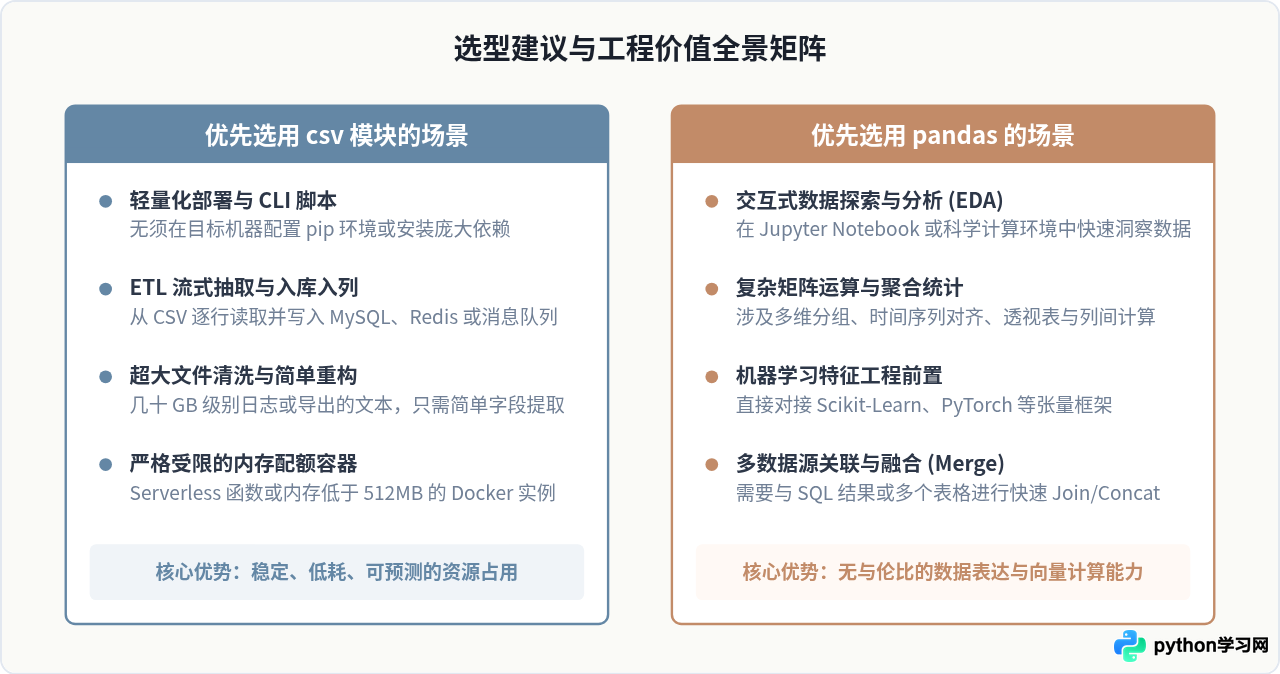
六、总结
选择 csv 还是 pandas,并不是在“落后”与“现代”之间做选择,而是在“流式吞吐”与“块状向量化计算”两种计算模型之间进行权衡。如果任务主要是按行过滤、简单清洗或流式转存,且关注系统资源与部署成本,Python 标准库的 csv 模块是首选;如果任务需要深入的数据探索、多列统计、聚合计算或与算法模型交互,且运行环境具备足够的内存储备,pandas 则能带来极高的开发与执行效率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















