


Python怎么解析含转义字符的JSON字符串
详细讲解在Python中解析包含反斜杠转义字符、Unicode编码以及嵌套双重转义JSON字符串的方法与原理,帮助读者排查常见JSONDecodeError并掌握实用处理策略。
json.loads() 函数。然而实际开发中频繁出现的解析报错,根源通常不在于常规转义本身,而在于混淆了“Python语言字面量转义”与“JSON规范转义”,或者遇到了将JSON重复序列化导致的“双重转义(Double Escaping)”。本文将直接梳理转义机制、具体操作步骤、常见场景差异及容错策略。
一、核心机制:区分Python字面量转义与JSON转义
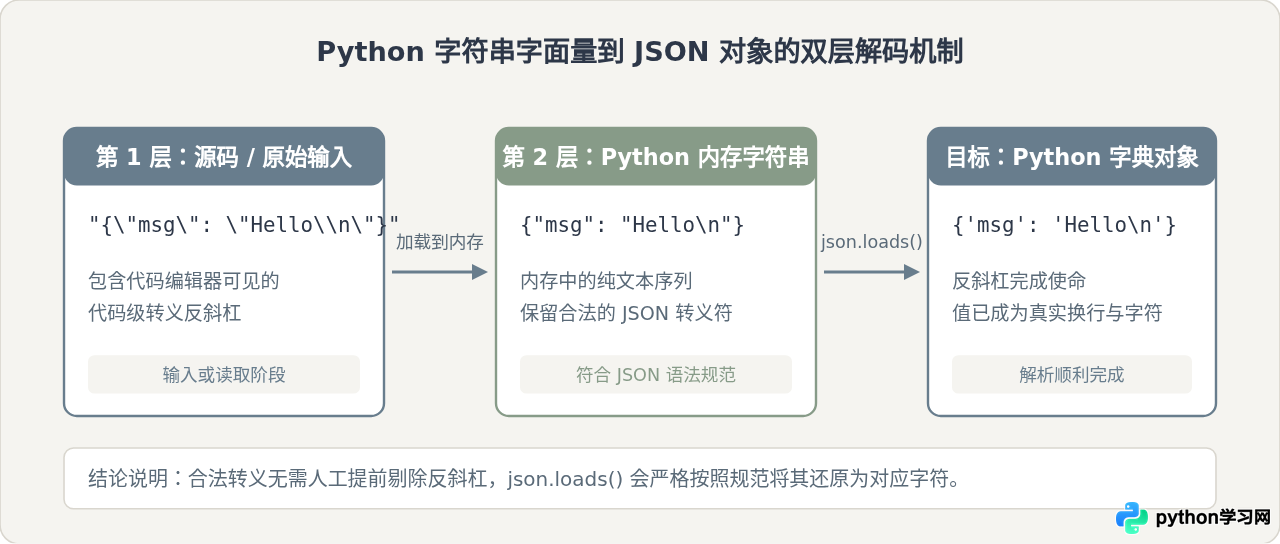
理解转义字符解析的第一步,是厘清数据在内存中存在的形式。在Python代码中书写字符串字面量时,反斜杠 \ 首先会被Python解析器自身解释一次;当调用 json.loads() 时,JSON解析器又会按照JSON规范进行第二次解释。
例如,合法的JSON规范允许使用 \" 转义双引号、\n 转义换行符以及 \u4e2d 转义Unicode字符。若在Python代码硬编码测试,由于Python代码层面的反斜杠本身也需要转义,常常需要写作 "{\"name\": \"Alice\\nBob\"}" 或借助原始字符串前缀 r"{\"name\": \"Alice\nBob\"}"。如果是从网络API响应、数据库或日志文本文件中直接读取的数据,在内存中已经是单层反斜杠序列,直接传递给 json.loads() 即可自动还原为预期的标点符号或文本内容。
二、标准操作步骤:解析含转义字符JSON的标准流程
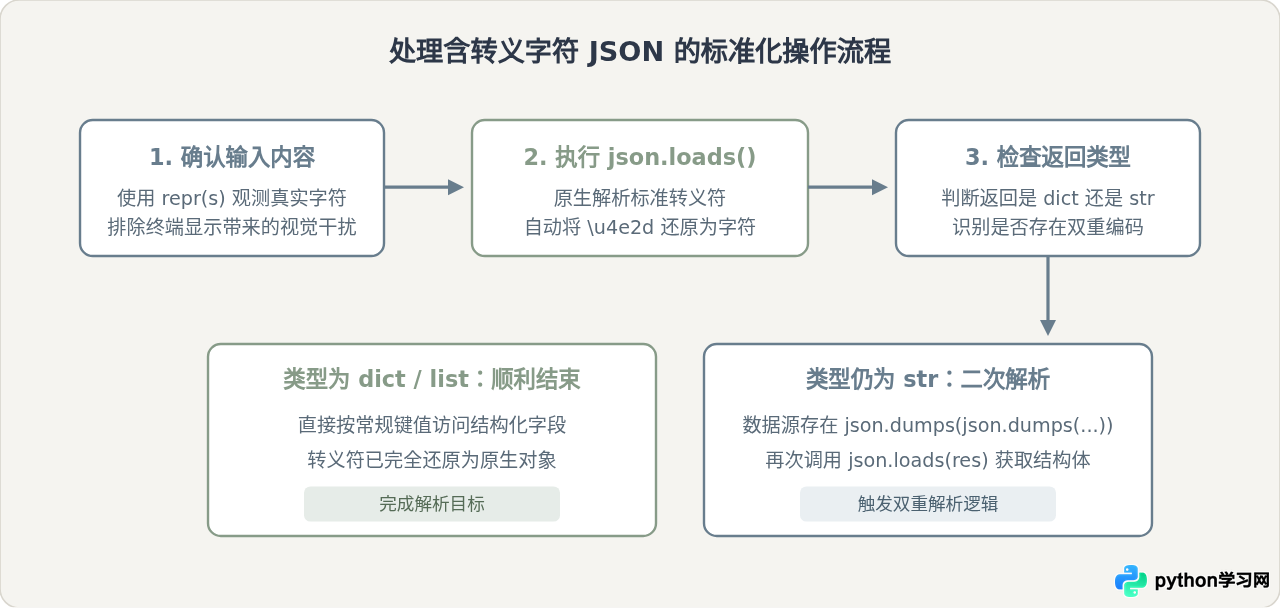
在实际编写程序时,处理带转义字符的JSON字符串应遵循以下标准化步骤,避免直接调用不安全的字符串替换函数:
- 步骤一:获取并打印实际内存字符串。 使用
print(repr(raw_str))确认当前变量中真实的转义字符形态,区分是实际换行符还是\n字符序列。 - 步骤二:直接执行
json.loads()。 导入标准库import json,使用 try-except 包裹json.loads(raw_str)。 - 步骤三:检查返回值类型,识别双重转义。 若解析返回的结果仍然是
str类型,说明源数据在生成端被序列化了两次,需进行二次反序列化。 - 步骤四:针对非标准反斜杠进行受控修正。 若报出
JSONDecodeError: Invalid \escape,根据具体原因做局部正则修正后重新解析。
import json

# 包含常见合法转义字符(换行符、引号、Unicode编码)的JSON示例
raw_json = '{"title": "Python指南", "desc": "包含换行\\n与引号:\\"OK\\"", "code": "\\u4e2d\\u6587"}'

try:
    data = json.loads(raw_json)
    print("解析成功,结果类型:", type(data))
    print("提取内容:", data["desc"])
    print("Unicode还原结果:", data["code"])
except json.JSONDecodeError as err:
    print("解析失败:", err)
执行该示例后,输出结果如下(示例输出):
解析成功,结果类型: <class 'dict'>
提取内容: 包含换行
与引号:"OK"
Unicode还原结果: 中文
三、关键对照分析:单层转义与双重转义(Double Escaped)
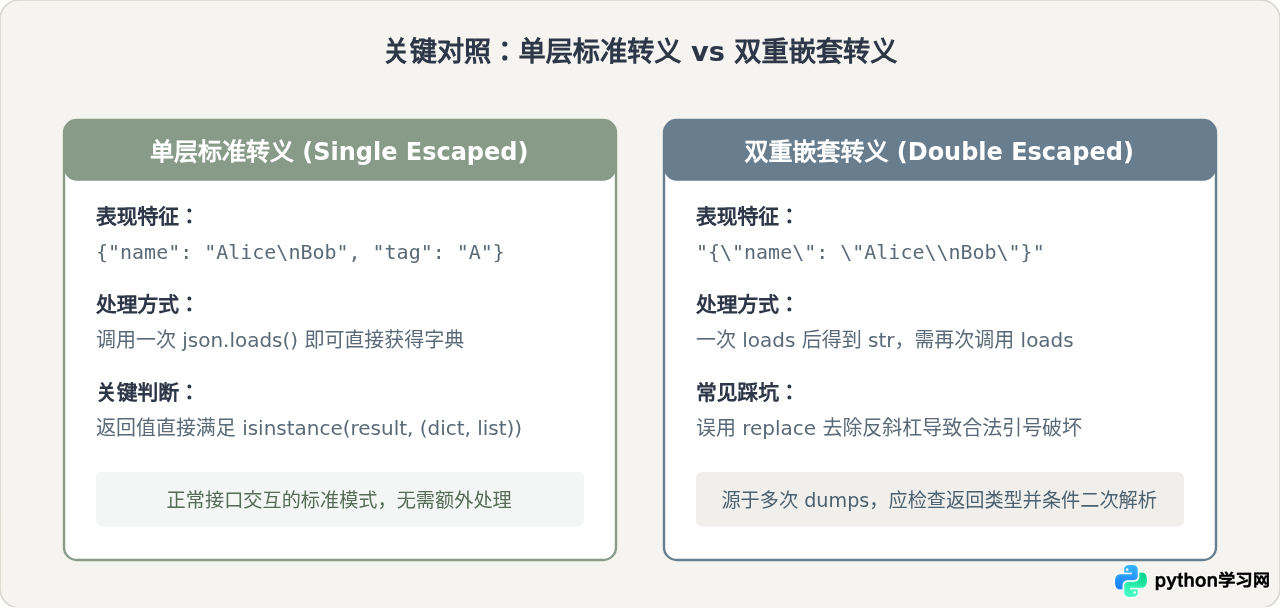
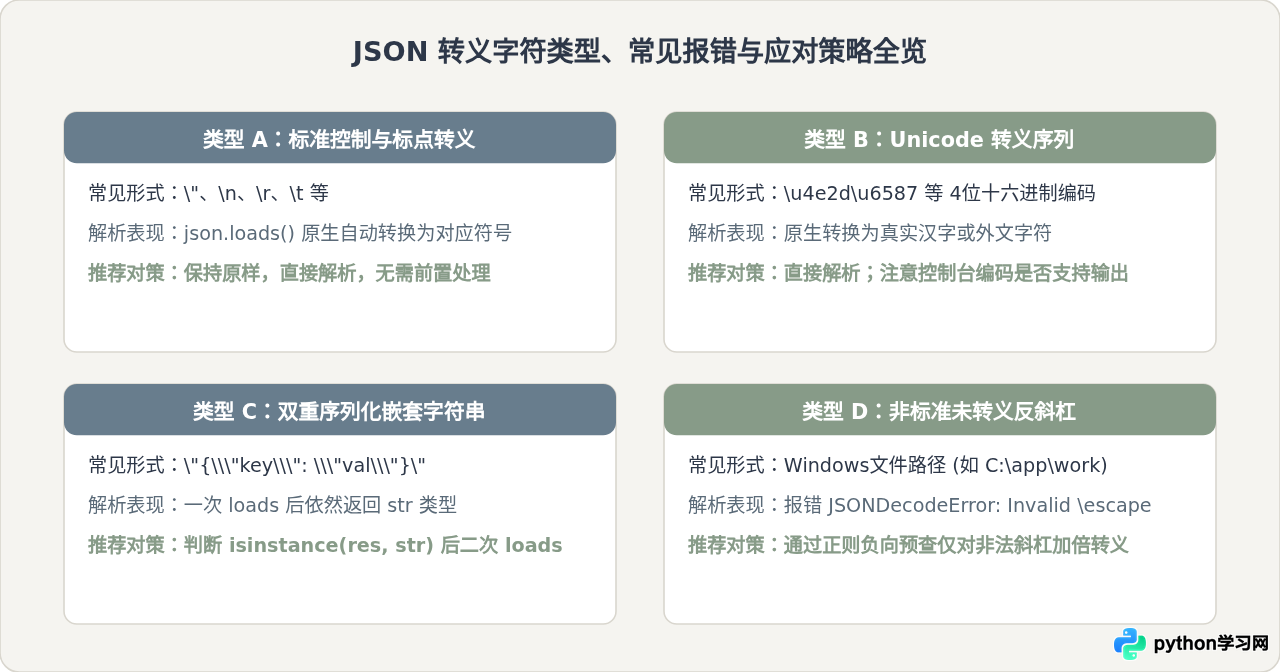
在处理包含转义字符的JSON时,最容易让人产生困惑的是两种完全不同的场景:单层转义与双重转义。二者在输入形态、处理逻辑与错误防范上有着本质差异。
1. 单层标准转义
当数据提供方正确调用了一次 json.dumps() 时,输出的就是单层标准转义JSON。例如原始文本中包含一个换行符,JSON序列化后表现为字符 \ 和 n。直接调用 json.loads() 即可一次性得到Python字典。
2. 双重嵌套转义(Double Escaping)
双重转义常出现在微服务调用、消息队列或数据库存储中。例如,上游服务先将字典序列化为字符串 s1 = json.dumps(data),随后又把 s1 作为一个字段的值放进外部字典并执行 json.dumps({"payload": s1});或者粗暴地对已经序列化的字符串再次执行了 json.dumps(s1)。此时,字符串内部的双引号前面会出现两个甚至三个反斜杠(如 "{\\\"name\\\": \\\"Alice\\\"}")。
import json

# 模拟双重转义的场景:外层是一个合法的JSON字符串字面量,内层是一个被转义的JSON文本
double_escaped_json = '"{\\"user_id\\": 1001, \\"status\\": \\"active\\"}"'

# 第一次解析:剥离外层转义,返回的是一个普通的 Python 字符串 (str)
first_step = json.loads(double_escaped_json)
print("第一步返回值类型:", type(first_step))
print("第一步返回值内容:", first_step)

# 第二次解析:对解开的字符串再次解析,得到真正的 Python 字典 (dict)
if isinstance(first_step, str):
    final_dict = json.loads(first_step)
    print("第二步解析成功:", final_dict["user_id"], final_dict["status"])
很多初学者在看到反斜杠报错时,习惯性写出 raw.replace('\\', '')。这种做法极其危险:一旦删除了表示双引号转义的反斜杠 \",内层未转义的双引号就会直接闭合字段,瞬间破坏JSON语法,引发更难以排查的语法错误。
四、非标准非法转义的排查与容错修复
在抓取网页或对接不规范的遗留接口时,经常会遇到不符合JSON规范的非法反斜杠。最典型的例子是Windows路径未转义:
# 错误示例:C:\tools\app 中的 \t 会被误识别为制表符,而 \a 是非法的JSON转义字符
bad_json = '{"path": "C:\\tools\\app.exe"}'
在严格模式下,JSON规范只允许转义 ", \, /, b, f, n, r, t, u。当反斜杠后面跟的是 a、字母或孤立存在时,Python会抛出 JSONDecodeError: Invalid \escape: line 1 column ...。
针对这种由于生成端不规范造成的非法转义,可以使用正则表达式只对非法反斜杠进行转义修补,而不破坏原有的合法转义字符:
import re
import json

def parse_lenient_json(json_str):
    """
    安全解析带有非法孤立反斜杠的非标准JSON字符串
    """
    try:
        # 首先尝试标准解析
        return json.loads(json_str)
    except json.JSONDecodeError:
        # 匹配非合法的反斜杠(后面不跟随 " \ / b f n r t u 的孤立斜杠),将其替换为双斜杠 \\
        sanitized = re.sub(r'\\(?!["\\/bfnrtu])', r'\\\\', json_str)
        return json.loads(sanitized)

# 包含非法反斜杠的输入测试
faulty_data = '{"filepath": "D:\\project\\app\\node"}'
fixed_obj = parse_lenient_json(faulty_data)
print("修复并解析成功,路径为:", fixed_obj["filepath"])
五、总结与编码建议
解析含转义字符的JSON字符串时,请记住以下三条核心准则:
- 尊重标准规范: 合法的反斜杠转义是JSON协议的一部分,
json.loads()内部具备完整的还原能力,切忌在调用前使用全局.replace('\\', '')。 - 编写防护性解码代码: 面对复杂的上游数据,通过先
json.loads(),随后对解析结果做类型检查if isinstance(res, str): res = json.loads(res),能够从容兼顾单层与双重转义。 - 规范生成端: 如果能够控制数据的生产者,应当优先在序列化端确保使用标准的字典结构直接通过
json.dumps()产生数据,从根本上杜绝二次嵌套序列化与路径转义缺失。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















