


怎么解决Python在线编译器中文乱码问题
系统介绍Python在线编译器中中文乱码的核心成因与排查路径,提供包括源码编码声明、标准输出重定向、字符编解码规范及沙箱环境配置等具体解决步骤与实用代码。
解决Python在线编译器中文乱码的核心,在于理顺从“网页代码输入、在线容器执行、标准输出流传输,到浏览器前端渲染”的完整编码链路,并将其全流程统一为UTF-8标准。对于绝大多数在线平台,只需在代码首行添加编码声明或在执行时重设标准输出流编码,即可快速解决中文显示为问号、十六进制转义或乱码字符的问题。
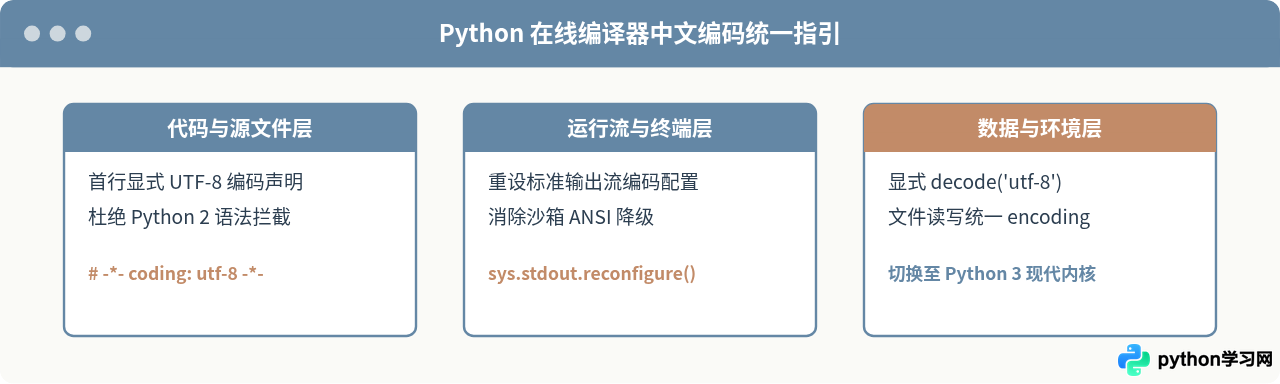
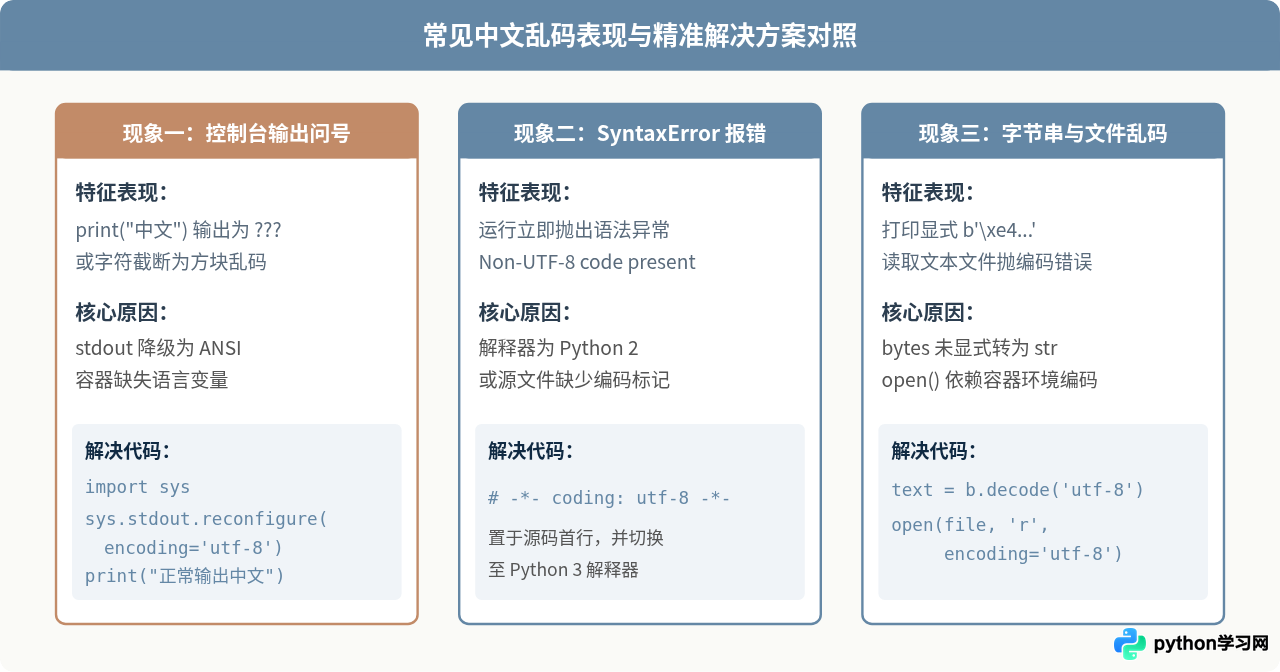
一、在线编译器中文乱码的三种典型表现
在各类网页版Python执行环境(例如轻量级在线运行工具、JupyterLite、Repl沙箱等)中编写包含中文的代码时,遇到的异常通常归为以下三类:
- 语法拦截报错:点击运行后,代码完全没有执行,控制台直接抛出
SyntaxError: Non-UTF-8 code present yet no encoding declared。这说明解释器在读取源码文本阶段,就拒绝解析非ASCII字符。 - 控制台输出符号错乱:代码正常执行结束,但输出区域的汉字变成了连续问号
???、方块乱码或形如ä¸æ的拼音/假名混杂字符。 - 显示十六进制转义字节:终端打印列表、字典或网络请求结果时,中文没有渲染为字形,而是显示为
['\xe4\xb8\xad\xe6\x96\x87']或b'\xe4\xb8\xad'。
二、为什么在线环境下更容易发生中文乱码
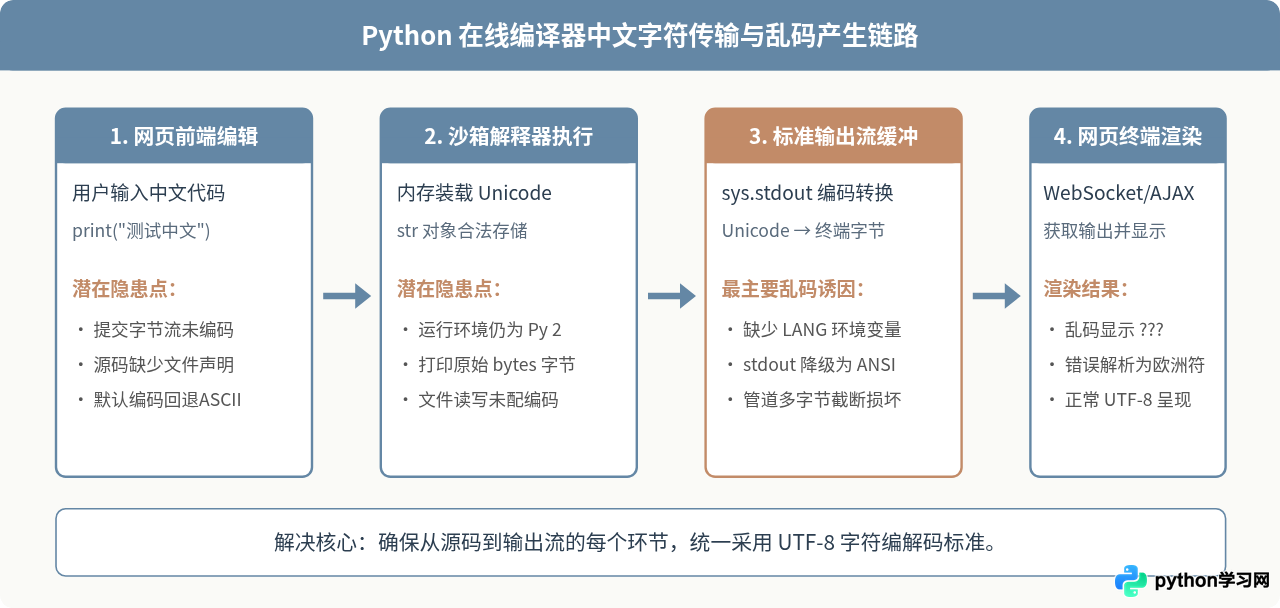
乱码的根本原因不是Python语言本身不支持中文,而是整个数据处理管道中存在字符集标准不匹配。本地电脑通常有完善的操作系统区域语言设置(如 zh_CN.UTF-8),而在线编译器运行在远端轻量级容器或浏览器WebAssembly沙箱中,环境精简程度极高。
在线执行链路包含四个核心节点:网页前端代码录入、云端沙箱读取源码、标准输出流重定向缓冲、前端控制台接收与渲染。若容器内缺少语言环境参数,Python的标准输出流(sys.stdout)会自动降级为 ANSI 或 ASCII 编码。当包含中文字符的Unicode字符串通过该流输出时,解释器或直接截断,或错误地转义,导致传回网页端的字节流已经损坏。
三、解决在线编译器中文乱码的五步排查法
按照从代码内层到环境外层的合理排查顺序,读者可通过以下五个具体步骤迅速排除乱码故障。
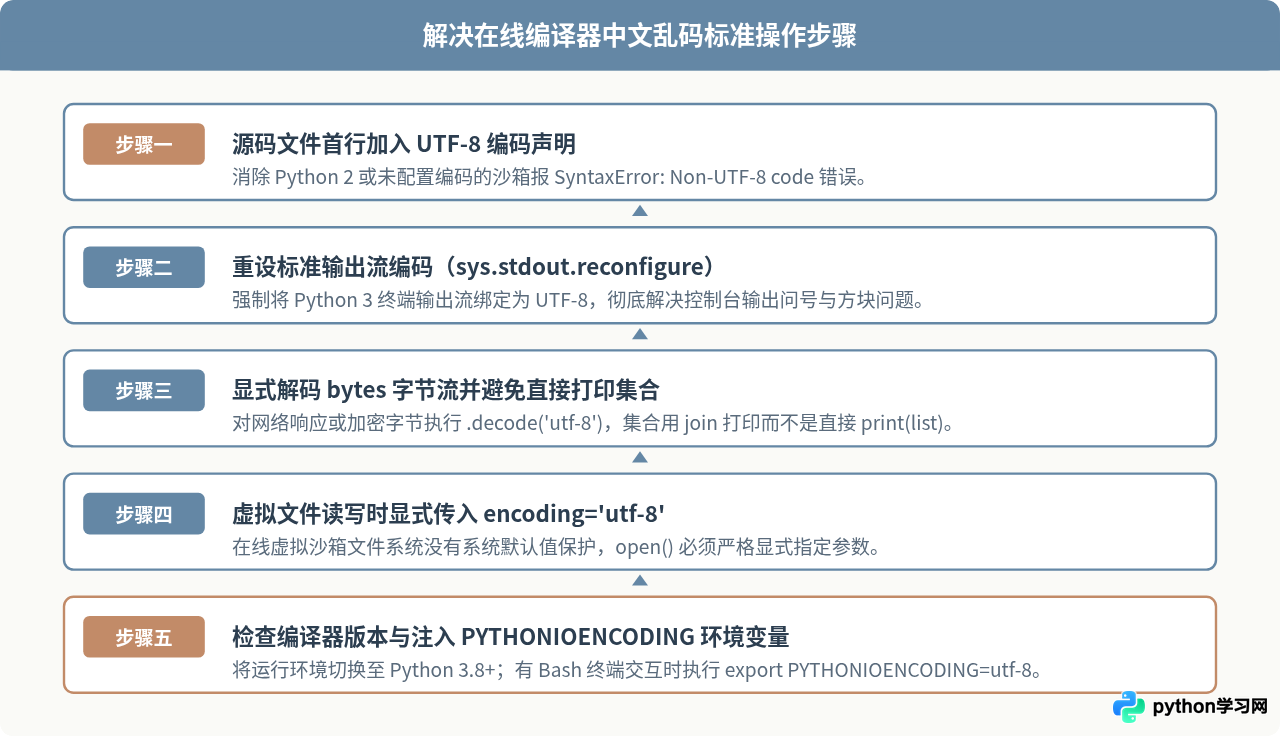
步骤 1:在源码首行添加 UTF-8 声明
很多国内教程类网站提供的在线编译器可能依然运行着 Python 2.7 环境,或者其后端服务将用户提交的文本保存为临时 .py 文件时缺少编码标记。Python 在解析包含中文注释或中文字符串的文件时会直接中断。
具体做法:在代码框的第一行(必须是最顶端),加入 PEP 263 标准编码声明:
# -*- coding: utf-8 -*-
# 示例:声明编码后正常使用中文
message = "你好,Python在线编译器"
print(message)
加入该声明后,解释器将强制使用 UTF-8 规则读取源文件,不会再因中文引发编译前期的 SyntaxError。
步骤 2:强制重定向标准输出流编码(针对 Python 3 平台)
这是解决控制台输出问号或乱码最有效、最通用的方法。在 Python 3 中,标准输出 sys.stdout 是一个文本包装器(TextIOWrapper)。如果在线沙箱未设置 LANG=C.UTF-8,sys.stdout.encoding 可能会被识别为 US-ASCII 或 ANSI_X3.4-1968,导致 print() 无法输出汉字。
推荐做法(Python 3.7+):使用 sys.stdout.reconfigure() 方法直接修改流编码,无需重启环境:
import sys

# 关键设置:强制标准输出采用 utf-8
sys.stdout.reconfigure(encoding='utf-8')

print("中文测试:成功解决输出问号和乱码问题!")
兼容旧版本做法(Python 3.6 及以下):若该在线平台使用的版本较早,尚未支持 reconfigure,可使用 io.TextIOWrapper 重新包装输出流缓冲:
import sys
import io

# 重新包装底层二进制缓冲区
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding='utf-8')

print("兼容旧版本沙箱环境的中文输出")
步骤 3:正确处理字节串(bytes)与集合输出
很多初学者在在线编译器中调试爬虫代码或网络请求时,常遇到打印出来的不是汉字而是形如 b'\xe4\xbd\xa0\xe5\xa5\xbd' 的十六进制字符。这并非环境乱码,而是将原生字节串(bytes)直接传入了 print()。
此外,直接打印包含中文的 list、dict 或 set 时,Python 会默认调用内部元素的 repr() 方法输出 ASCII 转义形式。
正确示例:
# 1. 网络请求返回的 bytes 必须显式 decode
raw_bytes = b'\xe4\xbd\xa0\xe5\xa5\xbd'
chinese_str = raw_bytes.decode('utf-8')
print("解码后的中文:", chinese_str)

# 2. 避免直接 print 包含中文的列表
items = ["苹果", "香蕉", "橙子"]
# 错误做法:直接 print(items) 会显示 ['\xe8\x8b\xb9\xe6\x9e\x9c', ...]
# 正确做法:转换为格式化字符串或逐项打印
print("正确打印列表:", ",".join(items))
步骤 4:在线沙箱内虚拟文件读写必须指定 encoding
部分高级在线编译器支持创建虚拟文件。在线上的微型Linux容器中,系统默认编码往往是 POSIX 或 C。如果调用 open('data.txt', 'w') 时忽略 encoding 参数,写入或读取中文时便会抛出 UnicodeEncodeError 或 UnicodeDecodeError。
规范代码:
# 写入文件时务必指定 encoding='utf-8'
with open("test.txt", "w", encoding="utf-8") as f:
    f.write("在线编译器文件中文测试")

# 读取时同样指定 encoding='utf-8'
with open("test.txt", "r", encoding="utf-8") as f:
    content = f.read()
    print("读取文件结果:", content)
步骤 5:环境设置排查与版本选择
若通过代码注入上述语句后仍然出现乱码,问题则出在在线编译器外部的配置上:
- 检查 Python 内核版本:查看网页界面上是否有版本切换下拉框。优先选择 Python 3.8 及以上版本,避免使用标有“Python 2.7”或“Python 2”的陈旧环境。
- 带控制台权限的在线环境(如 Repl.it、JupyterLab):如果在线页面提供完整的 Shell 终端窗口,可以在终端中输入以下命令,让 Python 运行时默认以 UTF-8 处理输入输出流:
export PYTHONIOENCODING=utf-8 export LANG=C.UTF-8 - 更换现代在线平台:部分免费在线编译器前端采用极简的字符串拼接方案,未在前端响应头配置
Content-Type: text/html; charset=utf-8。遇到此类平台且代码级方案无效时,建议改用主流且维护完善的在线平台(如官方 python.org 在线终端、Google Colab 或知名在线 IDE)。
四、如何验证中文环境已经完全正常
读者在应用解决方案后,可以通过下面这段集成了“标准输出、字节解码、列表展示和虚拟文件读写”的通用验证脚本进行一次完整测试。将整段代码复制进在线编译器并点击运行:
# -*- coding: utf-8 -*-
import sys

# 1. 尝试配置标准输出编码
try:
    sys.stdout.reconfigure(encoding='utf-8')
except AttributeError:
    import io
    sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding='utf-8')

print("【测试 1:标准中文输出】")
print("你好,世界!这是一段标准中文输出测试。")

print("\n【测试 2:数据集合打印】")
data = ["北京", "上海", "广州", "深圳"]
print("城市列表:", " -> ".join(data))

print("\n【测试 3:字节串解码】")
raw_data = "中文编码测试".encode("utf-8")
print("原始字节串:", raw_data)
print("解码还原后:", raw_data.decode("utf-8"))

print("\n【测试 4:当前环境编码诊断】")
print("sys.stdout 编码:", sys.stdout.encoding)
print("系统默认编码:", sys.getdefaultencoding())
验证合格标准:
- 测试 1 的中文文字完整清晰,没有出现任何问号、方块或生僻字乱码;
- 测试 2 能够清晰辨认列表中的四个城市名称;
- 测试 3 的还原后输出与原文完全一致;
- 测试 4 中
sys.stdout 编码显示为utf-8或UTF-8。
若在线编译器支持 input() 交互,部分精简沙箱在接收前端文本输入时仍会因未配置标准输入导致错误。若发生输入异常,可在程序开头同时加入 sys.stdin.reconfigure(encoding='utf-8')(Python 3.7+),确保输入与输出流两端完全对称。
五、总结
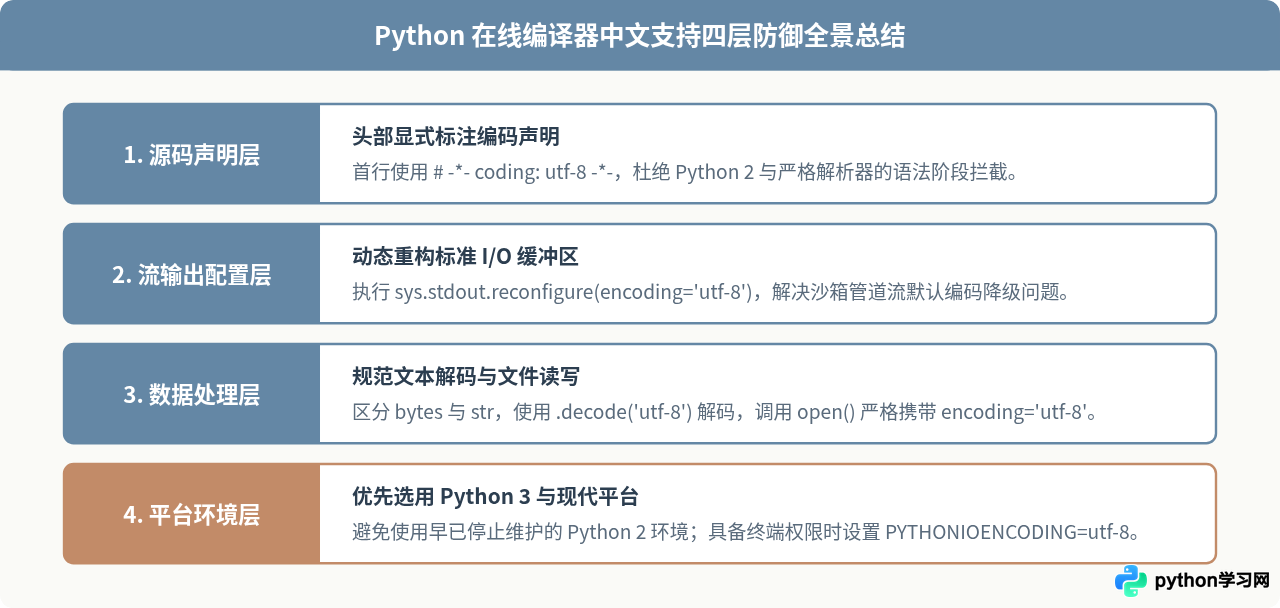
遇到Python在线编译器中文乱码时,无需盲目尝试各种代码偏方。首先观察报错类型:若是直接语法报错,优先在代码顶行补上 # -*- coding: utf-8 -*-;若是控制台输出问号或方块,通过 sys.stdout.reconfigure(encoding='utf-8') 纠正输出流;若是处理数据和文件,牢记显式传入 encoding='utf-8'。只要确保源文件、执行流与处理逻辑全链路处于 UTF-8 标准下,就能稳定、彻底地解决中文乱码问题。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















