


Python脚本中怎么调用并运行另一个py文件
详细讲解在Python脚本中调用并运行另一个py文件的常见方法,包括使用subprocess模块独立运行、通过import模块化调用以及使用runpy动态执行,对比适用场景、注意事项及常见避坑点。
在编写 Python 程序时,将不同职责的代码拆分成多个独立的 .py 脚本是常见的工程习惯。要在主脚本中调用并执行另一个脚本,通常有两条核心技术路径:一是通过标准库 subprocess.run() 将其作为独立的操作系统子进程执行,实现彻底的内存与环境隔离;二是通过 import 模块机制或 runpy 标准库在当前进程内直接执行代码。选择哪种方式取决于你是否需要隔离运行环境、是否需要跨进程传参,以及是否希望获取执行结果与退出状态码。
一、核心选型:进程隔离还是模块复用?
在动手写代码前,先明确调用场景能够避免绝大多数架构混乱。如果被调用的脚本是一个独立的 CLI 任务(如批处理工具、定时任务脚本、爬虫程序),或者它可能因为异常崩溃而不应影响主脚本,那么启动独立子进程是更稳妥的选择;如果被调用脚本本质上是功能函数库,主脚本只是想借用其中的计算逻辑,那么将其改造为函数并通过 import 导入才是符合 Python 设计哲学的做法。
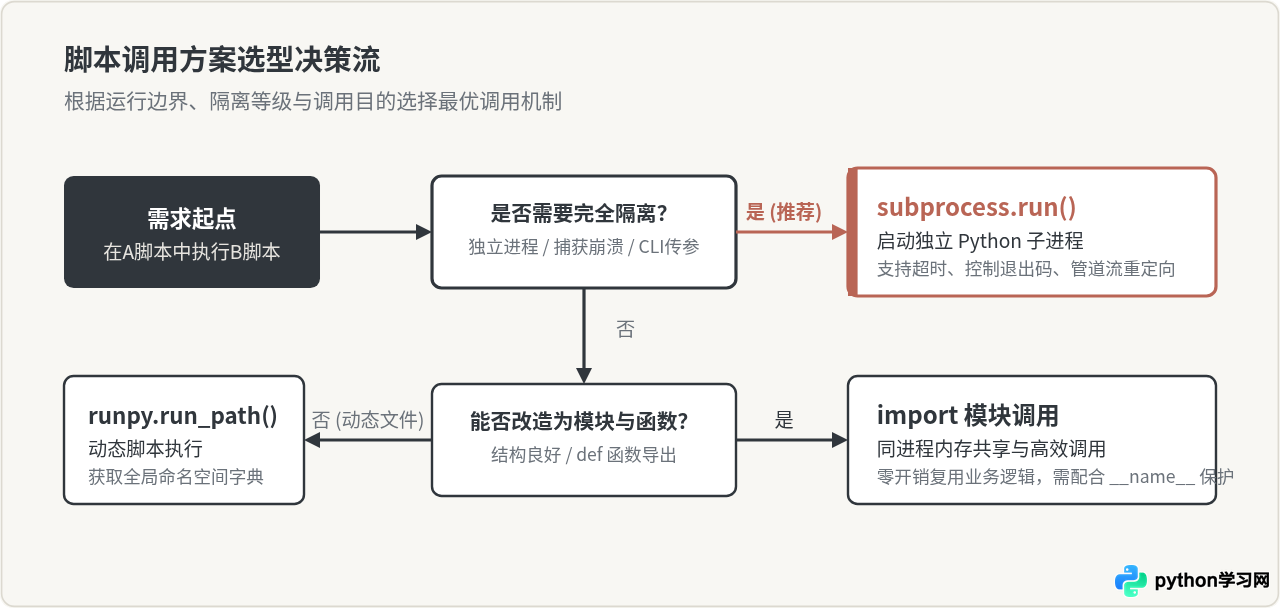
二、方法一:使用 subprocess.run 运行独立脚本(首选标准做法)
自 Python 3.5 起,标准库中的 subprocess.run() 成为了启动外部进程的推荐接口。使用子进程调用的最大优势在于高隔离性:被调用的脚本拥有自己独立的解释器堆栈、内存空间和运行状态。如果被调用脚本遭遇未捕获的严重错误或调用了 sys.exit(),主脚本不会随之中断退出。
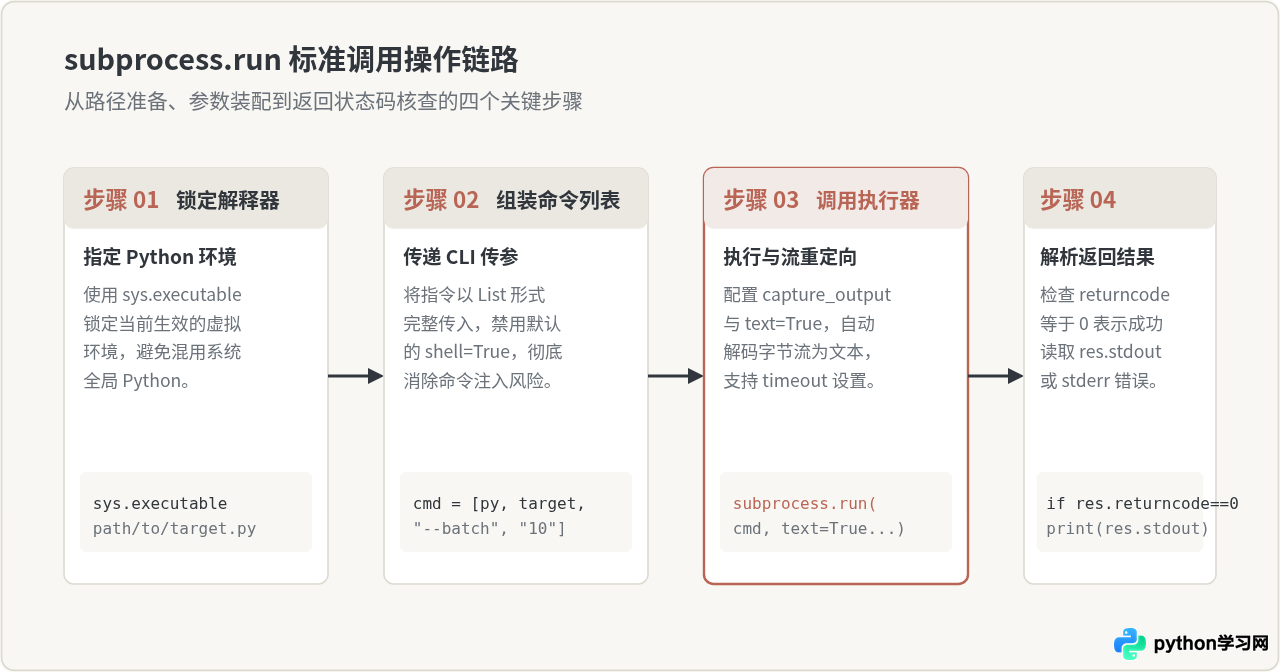
1. 四步执行流程
一个健壮的子进程调用过程通常包含准备目标脚本、解析 Python 解释器绝对路径、构造参数列表、执行并检查结果四个完整阶段。
2. 完整实操代码
假设我们有一个被调用的任务脚本 worker.py,它接收一个参数并输出结果:
# 文件名:worker.py
import sys

def main():
    if len(sys.argv) > 1:
        param = sys.argv[1]
        print(f"[Worker] 接收到输入参数: {param}")
    else:
        print("[Worker] 未传递任何参数")

    # 模拟业务处理
    print("[Worker] 任务执行完毕,返回状态码 0")
    sys.exit(0)

if __name__ == "__main__":
    main()
接着,我们在主脚本 main.py 中编写调用逻辑:
# 文件名:main.py
import sys
import subprocess
from pathlib import Path

def run_worker_script():
    # 1. 确定被调用脚本的绝对路径,避免当前工作目录变更导致找不到文件
    base_dir = Path(__file__).resolve().parent
    target_script = base_dir / "worker.py"

    if not target_script.exists():
        raise FileNotFoundError(f"未找到目标脚本: {target_script}")

    # 2. 组装命令列表
    # 务必使用 sys.executable 锁定当前的 Python 解释器
    command = [
        sys.executable,
        str(target_script),
        "Task_Data_2026"
    ]

    print(f"[Main] 正在启动子进程: {' '.join(command)}")

    # 3. 执行子进程
    # capture_output=True: 同时捕获 stdout 与 stderr
    # text=True: 自动将输出流转换为 str 字符串,免去 .decode()
    # check=False: 失败时不直接抛异常,允许手动根据 returncode 判断
    result = subprocess.run(
        command,
        capture_output=True,
        text=True,
        timeout=10
    )

    # 4. 判断并打印执行结果
    if result.returncode == 0:
        print("[Main] 子进程执行成功!输出内容如下:")
        print(result.stdout.strip())
    else:
        print(f"[Main] 子进程执行失败,退出码: {result.returncode}")
        print("错误输出:", result.stderr.strip())

if __name__ == "__main__":
    run_worker_script()
运行 main.py 后的示例输出如下:
[Main] 正在启动子进程: /usr/local/bin/python3 /projects/worker.py Task_Data_2026
[Main] 子进程执行成功!输出内容如下:
[Worker] 接收到输入参数: Task_Data_2026
[Worker] 任务执行完毕,返回状态码 0关键警示:永远不要直接使用字符串拼接并配合 shell=True 运行命令,例如 subprocess.run(f"python worker.py {user_input}", shell=True)。一旦参数中包含未经转义的特殊字符或分号,极易引发命令注入漏洞;此外,直接使用 "python" 会依赖系统的 PATH 环境变量,若主程序运行在虚拟环境中,子进程可能会错误地调用全局 Python 解释器,导致 ModuleNotFoundError。
三、方法二:通过 import 模块化调用(同进程高效复用)
如果被调用的脚本也是由你维护的代码,且主脚本需要频繁调用其内部的某项计算功能,将代码简单改造为模块导入是更加优雅且高性能的做法。通过 import 导入运行在同一个 Python 解释器进程中,省去了操作系统创建进程、加载动态库以及跨进程序列化(IPC)的额外开销。
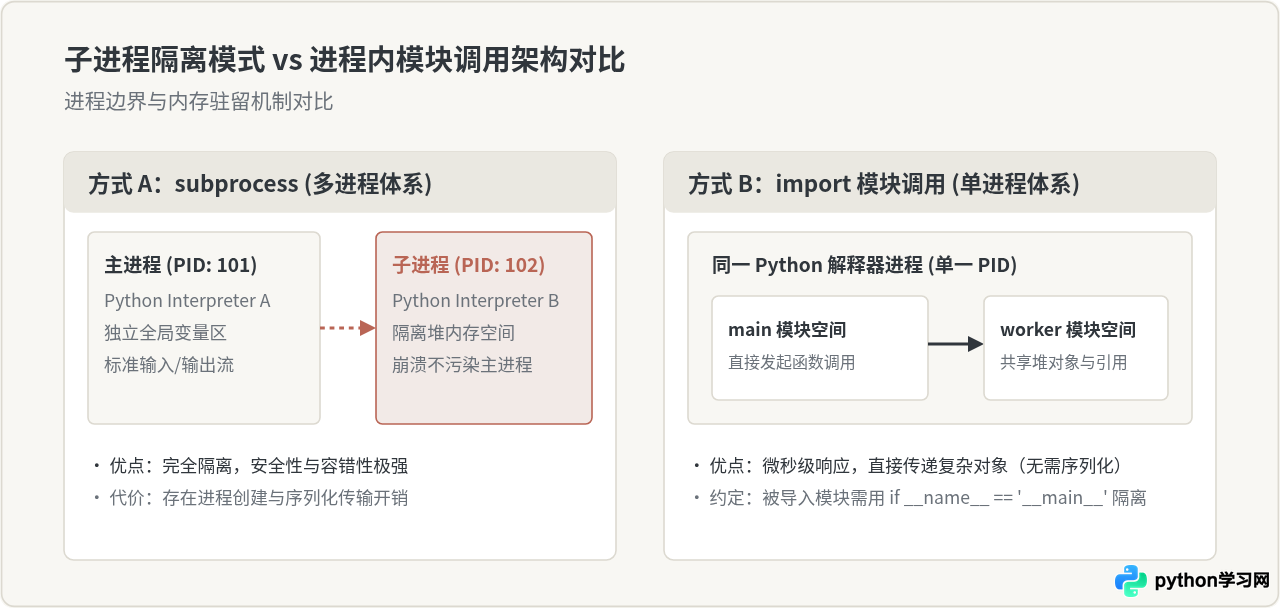
模块改造规范
为了让一个 .py 脚本既能作为独立程序在终端单独运行,又能被其他脚本无缝 import,必须使用标准的 if __name__ == "__main__": 保护结构:
# 文件名:calculator.py

def compute_total(price, quantity, discount=1.0):
    """供外部导入调用的核心函数"""
    return round(price * quantity * discount, 2)

if __name__ == "__main__":
    # 仅当直接在终端执行 python calculator.py 时才会运行此段
    # 被其他脚本 import 时,此代码块将被完全跳过
    import sys
    print("[Standalone Mode] 独立测试运行:")
    print("计算示例结果:", compute_total(100, 3, 0.85))
在主脚本中直接导入并传参使用:
# 文件名:app.py
from calculator import compute_total

def main():
    final_amount = compute_total(299.0, 2, 0.9)
    print(f"[App] 直接调用模块函数成功,总金额: {final_amount}")

if __name__ == "__main__":
    main()
四、方法三:使用 runpy.run_path 动态运行脚本
有时我们需要根据配置文件或外部传入的路径动态执行某个 .py 文件(例如编写插件加载器、自动评估框架),而不需要将其硬编码进 import 声明中。Python 官方提供了标准库模块 runpy,能够在当前解释器中按脚本模式执行指定文件,并返回其全局变量字典。
# 文件名:dynamic_runner.py
import runpy
from pathlib import Path

def execute_dynamic_script():
    script_path = Path(__file__).resolve().parent / "config_task.py"

    print(f"[Runner] 正在动态执行脚本: {script_path}")

    # runpy.run_path 像作为脚本直接运行一样执行文件,返回包含其所有全局变量的 dict
    globals_dict = runpy.run_path(str(script_path), run_name="__main__")

    # 提取脚本中生成的配置或计算变量
    if "EXPORTED_DATA" in globals_dict:
        print("[Runner] 成功获取脚本导出的全局变量:", globals_dict["EXPORTED_DATA"])

if __name__ == "__main__":
execute_dynamic_script()注意:runpy 仍然是在当前解释器进程中执行代码。如果被调用的脚本中包含 sys.exit(),主程序同样会被直接终止。因此,对于无法保证安全性的未知第三方脚本,务必优先使用 subprocess.run()。
五、常见避坑指南
- 工作目录与相对路径陷阱:被调用的子进程默认以主进程当前运行的工作目录(
os.getcwd())为基准,而不是子脚本所在的文件目录。如果子脚本内写有open('data.csv'),可能会报错文件找不到。解决办法是在被调用脚本中使用Path(__file__).resolve().parent / 'data.csv',或在主脚本调用时传入cwd=str(target_script.parent)。 - 输入输出缓冲区与编码:在跨平台(尤其是 Windows)执行子进程时,标准输出可能使用
gbk编码而主进程默认按utf-8解析导致报错。在subprocess.run()中可以显式指定encoding="utf-8"或在子脚本中开启环境变量PYTHONIOENCODING=utf-8。 - 长耗时任务与死锁:尽量避免使用旧式的
os.popen()或低阶subprocess.Popen手动操作stdout.read(),当输出内容超过操作系统内核的管道缓冲区(通常为 64KB)时容易引发读写互相等待的死锁。始终优先使用高阶的subprocess.run(),它内部实现了自动的缓冲区排空与超时管理。
六、方案全景总结
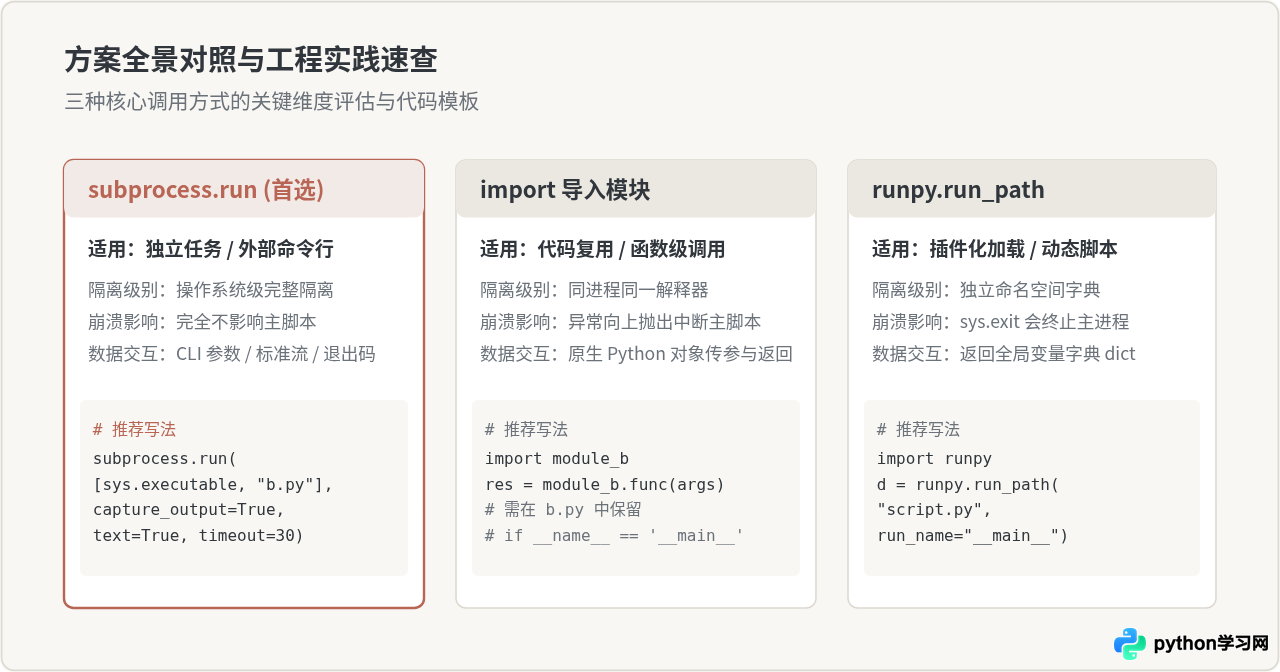
简而言之:如果你需要执行一个完整独立的程序任务,首选用 subprocess.run([sys.executable, "path.py"]);如果你只是想复用另一段代码里的逻辑与数据处理能力,花两分钟把对方封装成函数并 import 是最高效、最 Pythonic 的实践方式。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















