


Python import语句详解:module与from...import的区别及用法
深入详解 Python 中 import module 与 from module import 的核心差异、命名空间绑定机制、模块加载查找流程、不可变对象赋值陷阱及工程实践最佳规范。
在 Python 日常开发中,模块(Module)和包(Package)的复用是最基础的操作。然而许多初学者乃至有一定开发经验的工程师,常常在 import module 与 from module import name 的选择上产生混淆,甚至在遇到循环导入崩溃、变量修改不同步等典型问题时无从下手。这两种写法并不是单纯的语法糖区别,它们在底层缓存机制、命名空间符号注入以及对象引用传递上有着明确的本质差异。
一、核心机制剖析:命名空间与引用绑定的本质差异
要彻底区分这两种导入方式,首先需要了解 Python 是如何在当前作用域中组织变量的。Python 使用字典(可通过 globals() 查看)来维护全局命名空间中变量名与内存对象的映射关系。
1. import module 的行为
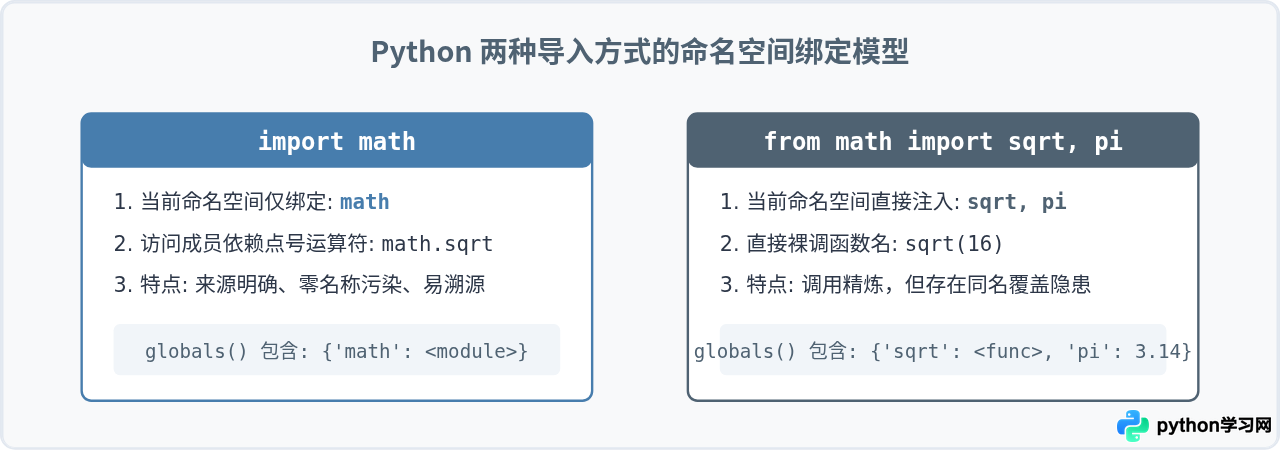
当我们执行 import math 时,Python 解释器在内存中找到或加载 math 模块对象后,仅仅在当前模块的命名空间中添加了一个名为 math 的变量,该变量指向整个模块对象:
import math

print("math" in globals())      # 输出: True
print("sqrt" in globals())      # 输出: False

# 必须通过属性访问运算符 '.' 来调用模块内的属性或方法
result = math.sqrt(100)
这种方式的优点是调用路径清晰透明,读者一目了然知道 sqrt 来自于 math,且绝不会与当前文件中自己定义的 sqrt 产生冲突。
2. from module import name 的行为
当我们执行 from math import sqrt, pi 时,解释器同样会将 math 模块完整加载到系统缓存中,但在当前模块的命名空间中,它不会创建变量 math,而是直接将 sqrt 和 pi 两个名字绑定到目标模块对应的对象上:
from math import sqrt, pi

print("math" in globals())      # 输出: False
print("sqrt" in globals())      # 输出: True

# 可以直接使用裸函数名
result = sqrt(100)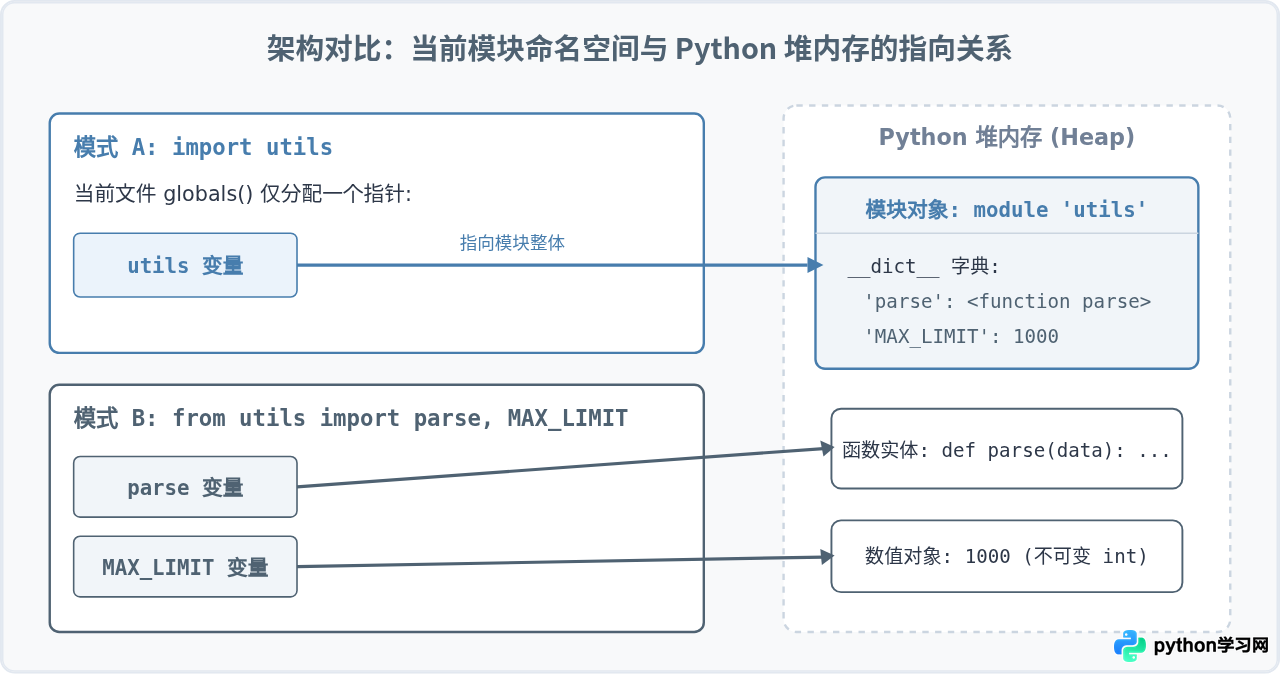
3. 常见导入语法汇总与特性对比
| 语法形式 | 当前命名空间引入的变量 | 调用方式 | 推荐使用场景 |
|---|---|---|---|
import os |
仅 os(模块对象) |
os.path.join() |
标准库、工具包、包含大量同名函数场景 |
import numpy as np |
别名 np(模块对象) |
np.array() |
约定俗成的公共科学计算包、缩写常用库 |
from datetime import datetime |
仅类名 datetime |
datetime.now() |
频繁调用的单一类或纯函数,避免写长链 |
from math import * |
被导模块的所有非下划线符号 | sin(x) |
极不推荐(严重污染命名空间,极易引起重名覆盖) |
二、底层执行流程:Python 遇到 import 时到底做了什么?
许多开发者误以为 from a import b 只会解析和加载变量 b,从而认为它比 import a 节省内存或运行更快。这是完全错误的观念。无论采用哪种导入写法,被导入的整个模块脚本都必须被完整编译并从头到尾执行一遍。
Python 解释器在处理一条 import 语句时,会按如下严谨的顺序执行:
- 检查模块缓存(sys.modules):解释器首先查看
sys.modules字典。如果目标模块的完整全称已经存在,则直接获取该模块对象,跳过磁盘查找与代码执行。 - 遍历查找器查找规范(sys.meta_path & sys.path):如果缓存未命中,查找器会在内置模块、冻结模块、当前目录以及
sys.path列出的安装路径中搜索对应文件(.py,.pyc,.so等)。 - 编译与创建模块对象:找到源码后,将其编译为字节码并生成一个全新的模块命名空间字典。
- 执行模块顶层代码:从第一行到最后一行执行该脚本,所有顶层的变量定义、函数
def和类class都会保存在该模块的__dict__中。 - 登记至全局缓存:将新构造好的模块对象注册到
sys.modules中。 - 当前命名空间绑定:根据是
import module还是from module import name,决定把模块对象绑定为局部变量,还是把模块内部的具体对象解包绑定。
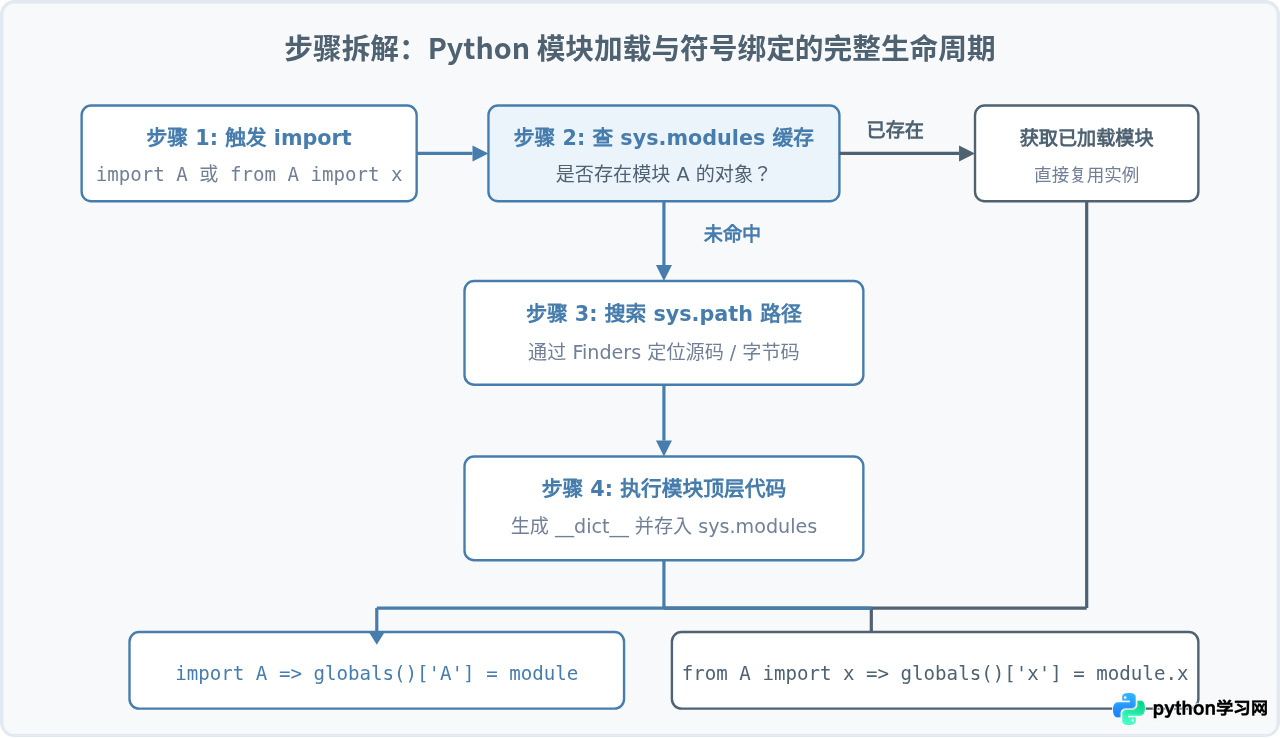
无论写 import my_pkg 还是 from my_pkg import some_func,被导入脚本里的全部全局可执行代码都会运行一遍。from...import 并不会减少模块的初次执行耗时或降低初始内存占用。
三、深层陷阱:不可变对象修改与变量“解绑”现象
在涉及多模块共享状态时,from module import var 会引入一个极易忽视的严重隐患:不可变对象重新赋值导致的命名空间脱节。
1. 故障场景复现
假定我们有一个系统配置模块 config.py,其中包含一个不可变类型(数字)和一个可变类型(字典):
# config.py
timeout = 30
database = {"host": "localhost", "port": 5432}

def update_config():
    global timeout
    timeout = 60                       # 改变全局变量引用
    database["host"] = "192.168.1.100"  # 原地修改字典内容
现在我们编写两个不同的主消费脚本:
# consumer_a.py (使用 import config)
import config

print("修改前 timeout:", config.timeout)          # 30
print("修改前 host:", config.database["host"])   # localhost

config.update_config()

print("修改后 timeout:", config.timeout)          # 60 (成功同步更新!)
print("修改后 host:", config.database["host"])   # 192.168.1.100 (成功同步更新!)
# consumer_b.py (使用 from config import timeout, database)
from config import timeout, database, update_config
print("修改前 timeout:", timeout) # 30
print("修改前 host:", database["host"]) # localhost
update_config()
print("修改后 timeout:", timeout) # 依然是 30! (严重故障: 状态未同步)
print("修改后 host:", database["host"]) # 192.168.1.100 (字典内容变了)2. 为什么会出现这种差异?
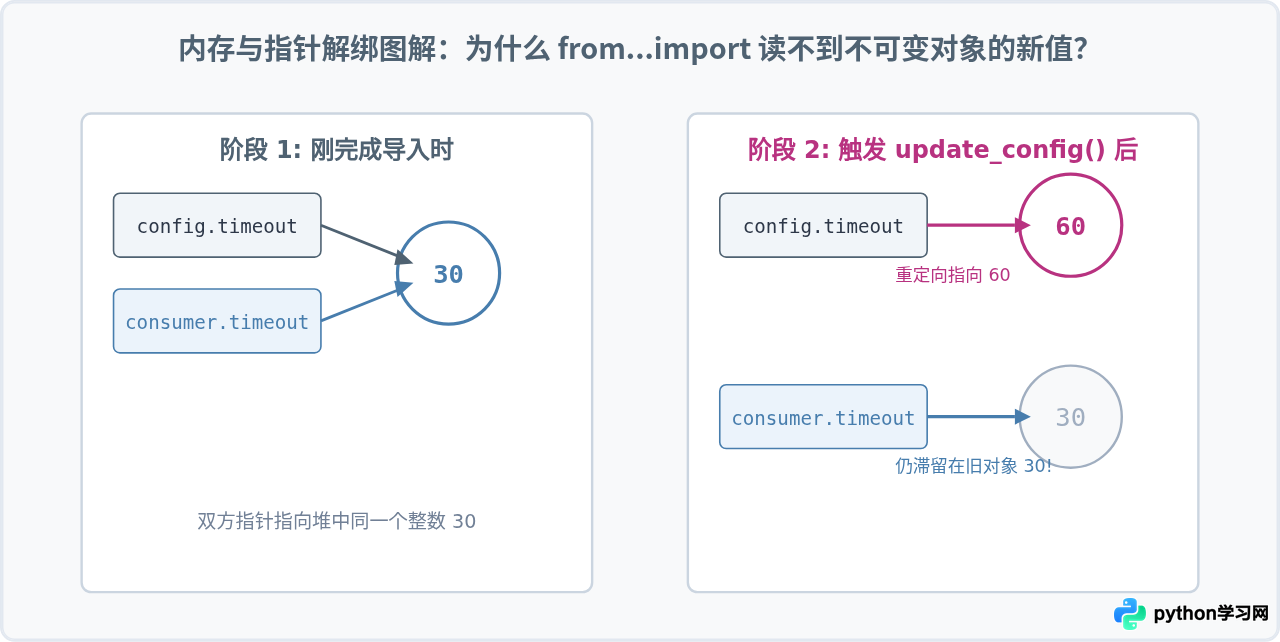
原因在于 Python 的变量赋值模型:
- 在
consumer_b.py中,from config import timeout使得当前模块的timeout变量直接指向整数对象30。 - 当调用
update_config()时,config.py内部的timeout = 60只是让 config 模块自身的字典指向了新的整数60。 - 而
consumer_b.py命名空间中的timeout变量依然顽固地指向旧的整数对象30,二者彻底失去了关联。 - 相反,对于可变对象
database,由于是原地修改键值对(in-place modification),两个命名空间指向同一个字典实例,因此修改能被双方同时感知。
四、循环导入(Circular Import)问题与避坑方案
当模块 A 在顶层尝试导入模块 B,而模块 B 在顶层又反过来导入模块 A 时,就会形成“循环依赖”。在使用 from...import 时,这种场景极容易触发毁灭性的 ImportError: cannot import name ... from partially initialized module 报错。
1. 为什么 from...import 更容易崩溃?
考虑以下典型案例:
# module_a.py
from module_b import func_b

def func_a():
    return "A"

print(func_b())
# module_b.py
from module_a import func_a
def func_b():
return "B"执行流程分析:
- 运行
python module_a.py,解释器读到第一行from module_b import func_b。 - 解释器暂停
module_a的执行,转向去加载module_b。此时module_a在sys.modules中已经挂牌,但其内部代码才执行到第 1 行(尚未定义func_a)。 - 进入
module_b.py,其第 1 行写着from module_a import func_a。 - 解释器在
sys.modules中找到了module_a,于是去其命名空间中查找func_a。 - 然而
module_a还没来得及运行def func_a(),属性不存在! - Python 立即抛出致命异常:
ImportError: cannot import name 'func_a' from partially initialized module 'module_a'。
2. 三种可行的解法对比
- 改用模块级导入(推荐):在
module_b.py中改写为import module_a,并在函数内部通过module_a.func_a()进行延迟解析。此时import module_a只需要确认模块对象存在即可通过,不会提前在未初始化的字典中强搜符号。 - 延迟导入(Deferred Import):把
from module_a import func_a挪动到def func_b():函数体内部。只有当函数真正被调用时才会发生导入,此时外部模块的顶层代码早已全部执行完毕。 - 重构架构(最根本):循环依赖通常是模块职责划分不清的坏味道代码。将双方共同依赖的公共逻辑、数据结构或基础类剥离到一个独立的第三模块(如
common.py或types.py),彻底切断闭环。
五、工程实践选择指南:何时用哪种导入?
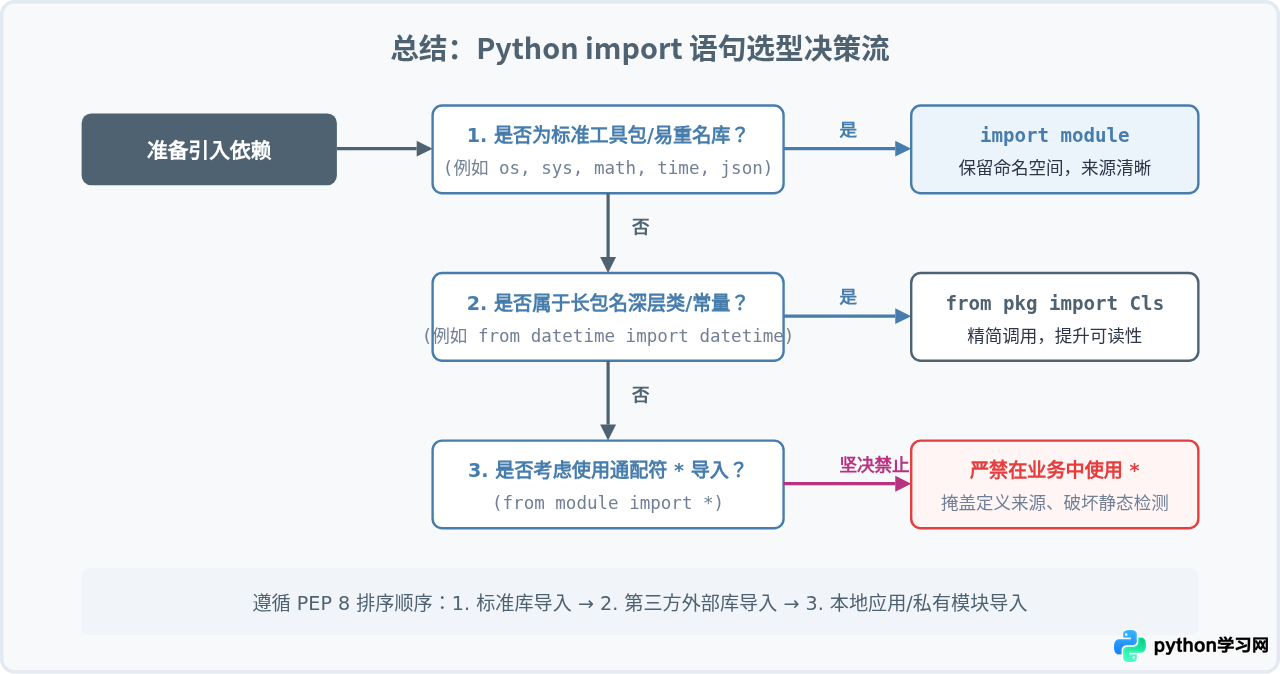
在大型企业级 Python 代码库中,一致的导入风格能显著减少维护成本与潜在的排查时间。以下是业内普遍遵循的选型准则:
1. 优先使用 import module 的场景
- 标准库中的基础工具包:如
import sys,import os,import json,import math。保持json.dumps()或os.path.exists()可以让阅读代码的人一眼看出函数的归属系统,无需跳回文件顶部查询。 - 存在大量同名符号的模块:例如同时使用两个图形库或数据库驱动,如果直接导入
connect或draw将引发覆盖灾难,保持命名空间前缀是最安全的策略。 - 模块内变量可能被动态重绑定的场景:如前文分析,保留
module.var可以确保始终获取到模块当前时刻最新的属性值。
2. 适合使用 from module import ... 的场景
- 深度嵌套的包和高频类:当包名非常冗长时(例如
from urllib.parse import urlparse或from my_project.services.billing.models import Invoice),使用from...import能显著减少代码行的横向膨胀。 - 约定俗成的特化对象与类型标注:在类型提示(Type Hinting)中引入类名,例如
from typing import List, Dict, Optional。
3. 严格禁止的行为
严禁在生产代码中使用 from module import *。这种写法会将目标模块内部所有未带下划线的符号全部倒进当前命名空间,不仅会让 IDE 的代码补全和语法静态分析工具(如 flake8, mypy, pylint)彻底失效,更会在第三方库升级新增函数名时,悄无声息地覆盖你原有的同名函数,制造难以排查的暗病。
import module 与 from module import name 在加载与执行目标脚本的开销上没有任何差异,两者的本质分水岭在于当前命名空间的变量绑定策略。根据代码的可读性、防重名需求及是否涉及动态状态共享,合理选择语法,并坚决杜绝通配符导入,是编写高质量、高可维护性 Python 工程的基本功。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















