


Python列表推导式与传统for循环对比:何时选择更简洁的写法
深入对比Python列表推导式与传统for循环的语法构造、底层字节码机制与性能表现,提供清晰的选型场景与决策流程,指导开发者写出兼顾简洁与可读性的Python代码。
在 Python 编程中,生成一个新列表是最常见的数据处理需求之一。实现这一目标通常有两种方式:传统的 for 循环配合 append() 方法,或者使用更加声明式的列表推导式(List Comprehension)。列表推导式往往能将四到五行模版代码浓缩为一行,但更短的代码并不总是等同于更好的代码。本文将系统对比两者的语法构造、底层运行机制与实际表现,并给出明确具体的场景判断标准,帮助你在日常开发中做出兼顾执行效率与团队可读性的选择。
一、语法构造与转换关系:推导式是如何精简结构的
要准确评估两者的适用场景,首先需要理解它们在表达逻辑上的等价映射。传统的 for 循环遵循“命令式”范式:我们显式创建一个空列表容器,启动循环迭代器,在循环体中执行条件过滤,最后调用方法向容器追加元素。而列表推导式采用了“声明式”范式,直接描述“结果列表应该由什么元素构成”。
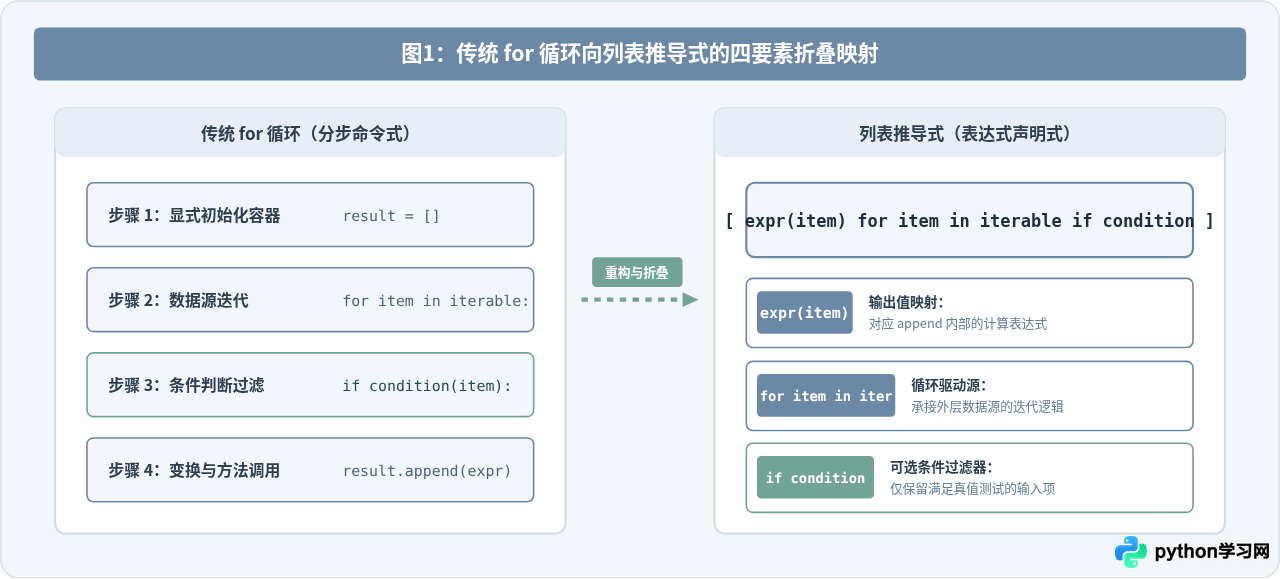
通过对比可以清晰地看到,列表推导式将“创建列表”、“迭代遍历”、“条件判断”和“追加元素”这四个分离的命令式动作,整合成了一个紧凑的原子表达式。在基础应用中,代码不仅更加简练,意图也更聚焦。
# 传统 for 循环写法
numbers = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
even_squares = []
for n in numbers:
    if n % 2 == 0:
        even_squares.append(n ** 2)

# 等价的列表推导式写法
even_squares = [n ** 2 for n in numbers if n % 2 == 0]
二、底层机制与执行性能:推导式为何通常更快
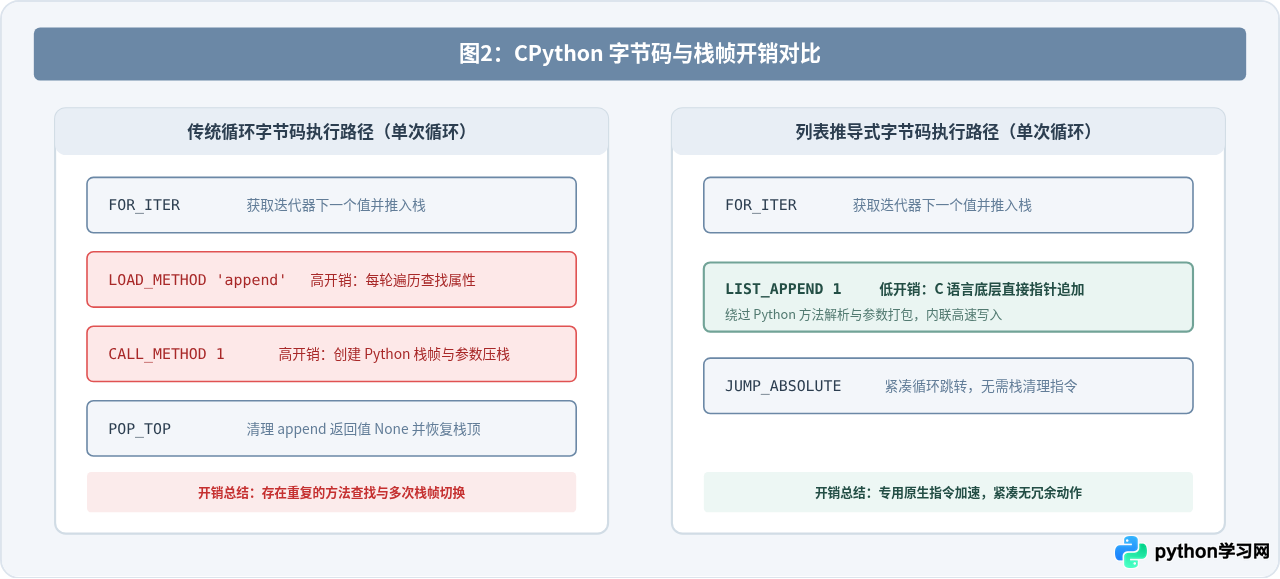
很多开发者发现列表推导式往往比等价的 for 循环运行速度快 20% 到 30% 左右。这种性能差距并非来自某种魔法,而是由 Python 虚拟机(CPython)的字节码处理机制决定的。
在传统的 for 循环中,每次调用 even_squares.append(n ** 2) 时,Python 解释器都要完成以下两项耗时操作:
- 属性查找(Attribute Lookup):每一轮循环都必须从列表对象中查找
append方法,产生LOAD_METHOD指令。 - 函数调用栈(Function Call Overhead):执行
CALL_METHOD需要建立和销毁 Python 栈帧,传递参数并处理返回值。
相比之下,列表推导式在 CPython 层面由专门的 LIST_APPEND 字节码直接驱动。该指令直接在 C 语言层面将元素推入底层数组,完全跳过了方法查找与函数调用开销。
三、复杂度陷阱:何时列表推导式反而破坏可读性
虽然语法简洁是推导式的最大优势,但如果滥用这种紧凑性,代码将迅速演变成难以维护的“一行流(One-liner)怪兽”。评估可读性时,有两个明显的红线:多层嵌套循环与复杂的条件表达式分支。
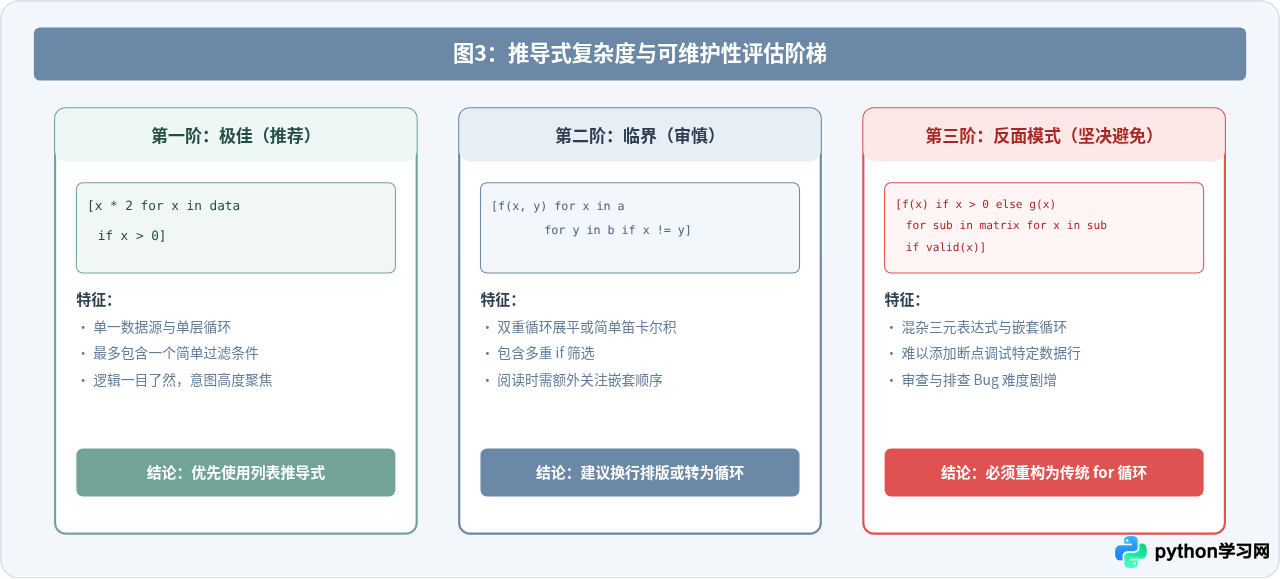
考虑以下二维矩阵展平并筛选有效数据的案例:
# 晦涩难懂的多层推导式
matrix = [[1, -2, 3], [4, 5, -6], [-7, 8, 9]]
filtered = [val * 10 if val % 2 == 0 else val for row in matrix for val in row if val > 0]

# 改用传统 for 循环:结构清晰、便于单步调试与维护
filtered = []
for row in matrix:
    for val in row:
        if val > 0:
            new_val = val * 10 if val % 2 == 0 else val
            filtered.append(new_val)
在第二种写法中,每一层层级有明确的缩进,中间变量 new_val 能够随时被断点捕获或打印,后期若需增加日志输出或异常防护也极其从容。
四、传统 for 循环不可替代的五大场景
除了多层嵌套之外,还有许多实际业务需求是列表推导式先天无法妥善处理的。遇到下列情况时,必须果断选择传统的 for 循环:
- 带有业务副作用(Side Effects):如果循环的目的不是为了“产出新列表”,而是向控制台打印、记录日志、写入数据库或发起网络请求,推导式会带来极大的误导,并且容易造成无用的内存分配。
# 错误反例:利用推导式执行副作用(丢弃了构建出来的无用列表) [print(user.name) for user in user_list] # 正确做法:直接使用 for 循环 for user in user_list: print(user.name) - 需要精细的异常捕获(Exception Handling):列表推导式内部无法嵌入
try...except语句块。如果某一处理步骤可能会抛出错误,必须使用外部函数包装或回退到标准循环。# 需要保护单项失败不中断整个循环 valid_records = [] for raw_text in raw_inputs: try: record = parse_json_payload(raw_text) valid_records.append(record) except json.JSONDecodeError as err: logger.warning("解析失败已跳过:%s", err) - 需要流程中断或跳步控制(break / continue):列表推导式只能全量遍历迭代器。如果需要在满足某个条件时提前退出循环(
break),推导式无法实现。 - 单行内包含大量逻辑分支(多重 if-elif-else):虽然列表推导式支持条件表达式,但一旦超过两层判断,表达式括号和逻辑运算符就会让代码变得晦涩不堪。
- 海量数据处理与内存限制:列表推导式是贪婪执行的(Eager Evaluation),它会一次性在内存中完整分配并生成整个列表。当处理数百万行日志或超大文件时,一次性生成列表会导致内存爆满。此时应选用生成器表达式(使用圆括号
())或传统循环配合yield。
五、工程选型决策路径:何时选择哪种写法
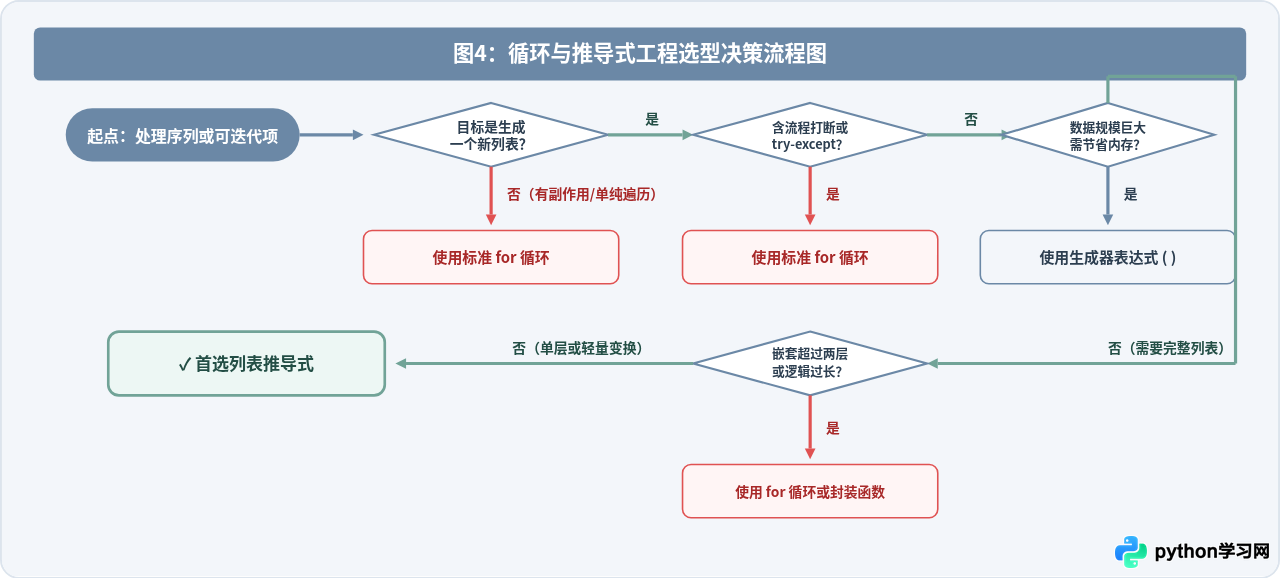
为了让团队在代码审查(Code Review)中达成统一标准,我们可以借助下面的决策流程图来迅速判断最适合当前代码段的实现方式:
六、对比总结表
为了便于速查,两者的核心特性对比如下:
| 对比维度 | 列表推导式 | 传统 for 循环 |
|---|---|---|
| 设计范式 | 声明式(关注最终结果形态) | 命令式(关注具体执行流程与步骤) |
| 底层指令 | LIST_APPEND(C 级直接追加) |
LOAD_METHOD + CALL_METHOD |
| 平均性能 | 通常比等价循环快 20%~30% | 受属性解析与调用栈影响相对略慢 |
| 单步调试能力 | 较弱(整行作为单步表达式执行) | 极佳(支持循环体内各变量断点追踪) |
| 多层嵌套表达 | 易读性急剧恶化,极易产生理解偏差 | 缩进分明,逻辑层次直观 |
| 异常与流程控制 | 不支持 try/except、break |
完整支持所有 Python 流程控制语句 |
| 最佳适用场景 | 简单过滤、数据规整、映射提取 | 复杂业务逻辑、I/O 操作、带有副作用 |
七、结语
在 Python 的编程哲学中,“简洁胜于复杂”,但同样强调“清晰胜于晦涩”。列表推导式并不是为了取代传统的 for 循环,而是为纯粹的数据映射与过滤提供了一种更加凝练的表达手段。在编写代码时,优先询问自己:“这段逻辑是否仅为了组装一个新列表?读者能否一眼看出它的转换目标?”如果答案是肯定的,尽情使用列表推导式;一旦发现逻辑需要附加解释、包含嵌套循环或带有副作用,立即拥抱结构清晰的传统 for 循环,才是专业 Python 开发者的成熟选择。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















