


python必背源代码asyncio异步代码
深入讲解 Python 标准库 asyncio 必背经典源代码,涵盖最小运行原型、gather 与 TaskGroup 并发调度、Semaphore 限流、wait_for 超时保护及 to_thread 阻塞桥接,提供实用运行示例与执行原理全景图。
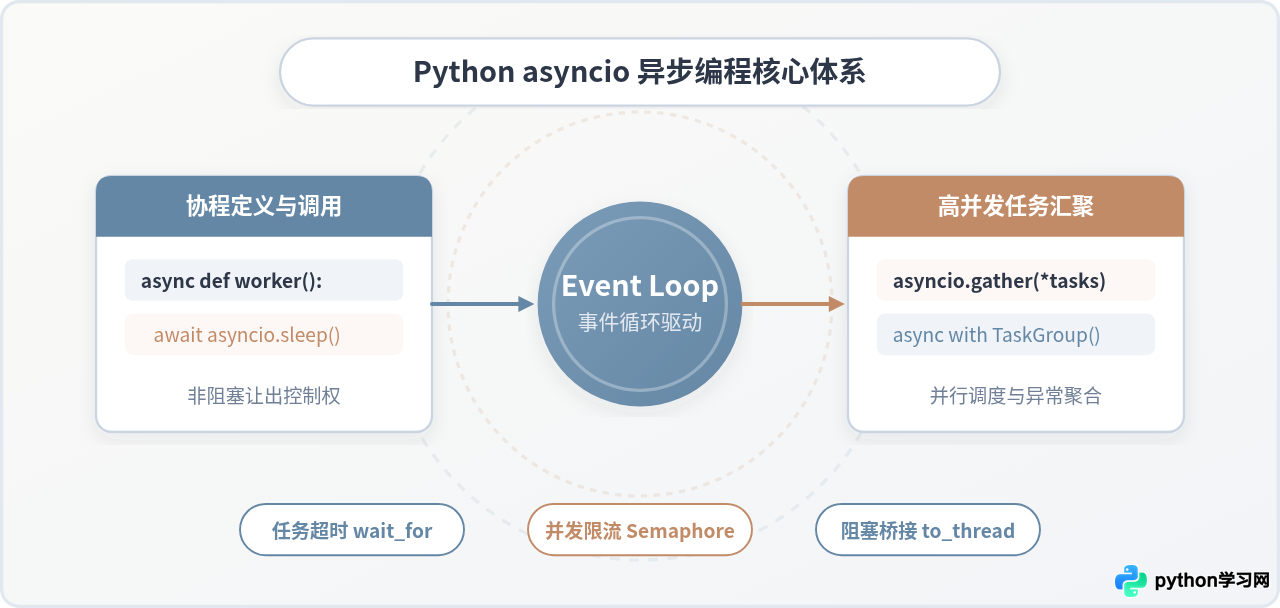
asyncio 是构建高性能异步爬虫、高并发微服务网关及网络通信程序的基础设施。掌握 asyncio 的核心不是背诵复杂的底层调度细节,而是掌握几套经过生产验证的“必背标准代码模板”——包括协程启动、批量并发、超时熔断、流量限流以及同步阻塞代码桥接。本文通过完整的代码示例、输出验证和原理图示,系统梳理这些日常开发中必须熟练掌握的源代码。
一、核心模型:最小运行原型与执行机制
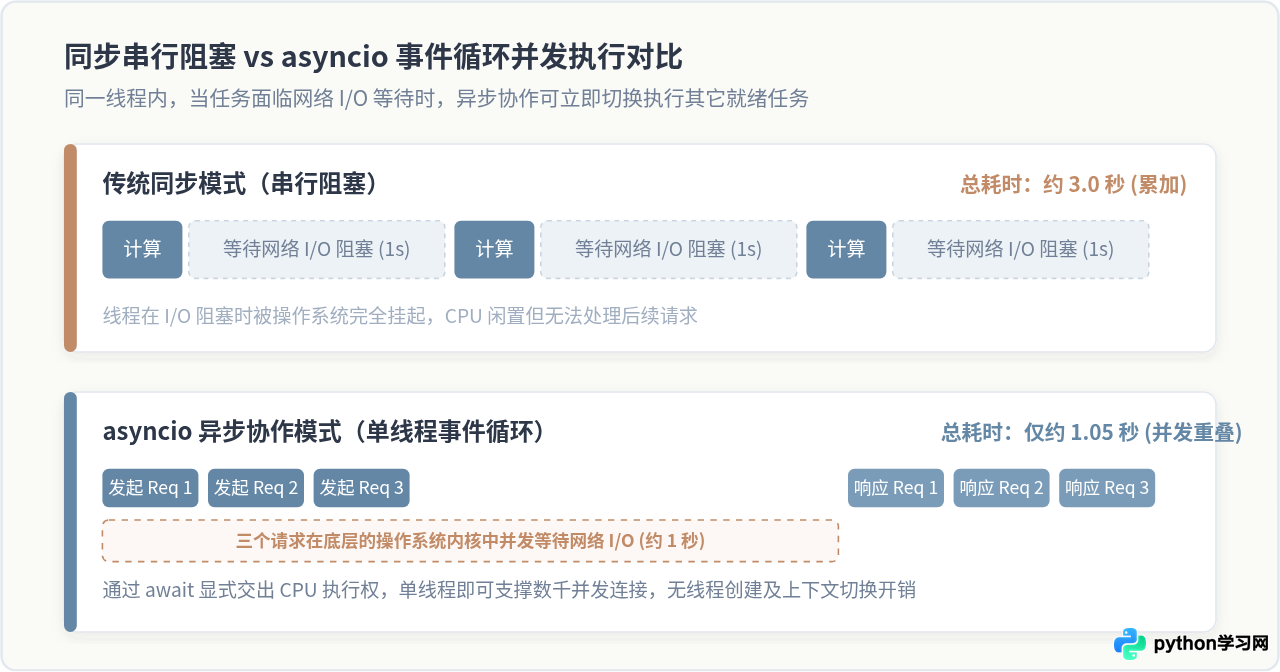
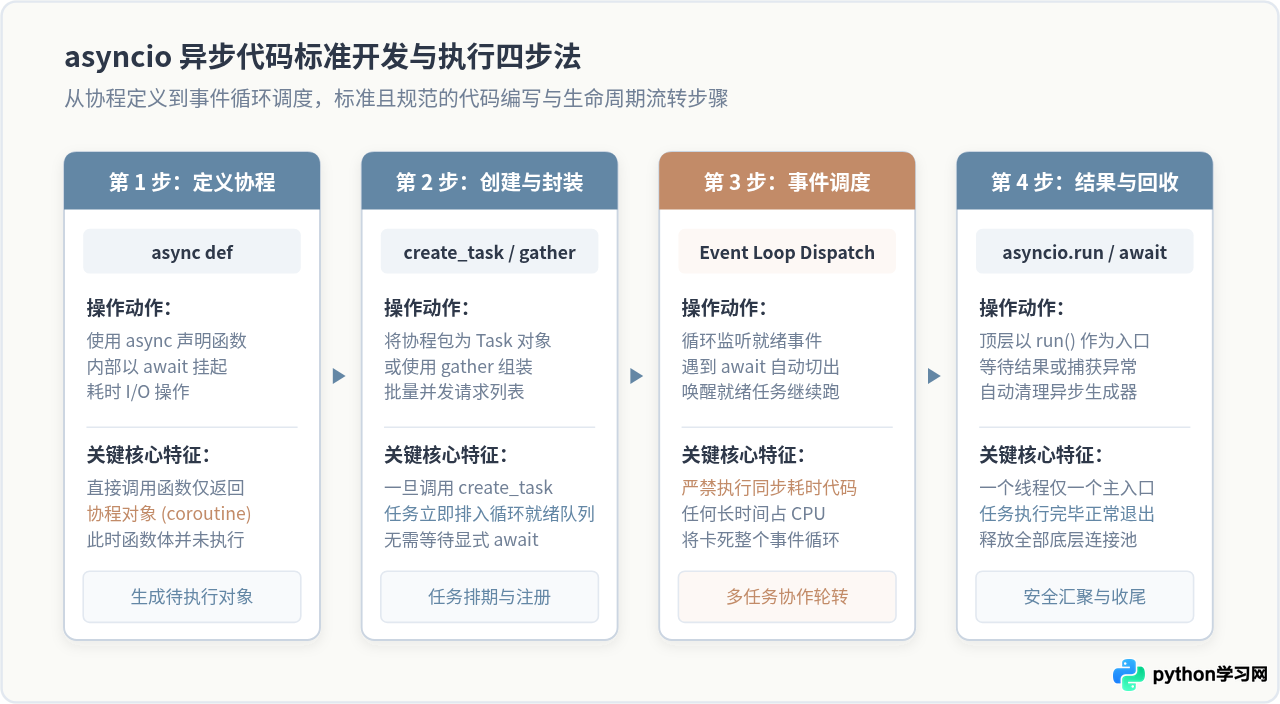
编写 asyncio 代码的第一步是理解“协程函数”与“普通函数”的调用差异。普通函数在调用时立即执行内部逻辑并返回结果;而被 async def 修饰的函数在调用时并不会立即执行,而是返回一个协程对象(coroutine object)。必须将其放入事件循环并使用 await 或任务管理器驱动,代码才会实际运转。
必背代码 1:最小异步运行原型
以下是启动任何异步程序都必须使用的基础骨架代码:
import asyncio
import time

async def fetch_data(item_id: int):
    # 模拟非阻塞的异步网络 I/O 等待
    print(f"[{time.strftime('%X')}] 开始拉取数据: 任务 {item_id}")
    await asyncio.sleep(1.0)
    print(f"[{time.strftime('%X')}] 数据拉取完成: 任务 {item_id}")
    return {"item_id": item_id, "status": "ok"}

async def main():
    # 显式使用 await 挂起当前协程,等待子协程返回
    result = await fetch_data(101)
    print("获取结果:", result)

if __name__ == "__main__":
    # 程序的唯一主入口:初始化事件循环并运行至 main 结束
    asyncio.run(main())
示例输出:
asyncio.run() 负责整个应用程序的生命周期管理:它自动创建新的事件循环、将传入的根协程运行完毕、关闭事件循环并清理遗留异步生成器。每个线程通常只应存在一个 asyncio.run() 调用,切勿在已有循环的代码段内嵌套调用它。
二、并发执行:gather 与现代 TaskGroup 模式
异步编程的最大优势在于并发处理 I/O 密集型任务。如果仅用 await a(); await b() 串行执行,多个耗时操作依然是顺序等待的,并没有发挥并发优势。必须借助任务批处理工具将多个任务同时注册到事件循环。
必背代码 2:使用 asyncio.gather 批量并行调度
asyncio.gather 是使用最广泛的并发汇聚函数,能够同时启动多个协程,并按传参顺序收集所有返回值:
import asyncio
import time

async def download_file(name: str, delay: float):
    print(f"[{time.strftime('%X')}] 开始下载: {name}")
    await asyncio.sleep(delay)
    print(f"[{time.strftime('%X')}] 下载完成: {name} (耗时 {delay}s)")
    return f"{name}_content"

async def main():
    start = time.perf_counter()
    # 同时并发发起 3 个下载任务
    results = await asyncio.gather(
        download_file("file_A", 1.5),
        download_file("file_B", 0.8),
        download_file("file_C", 1.2),
        return_exceptions=False  # 若设为 True,单任务异常会被当作返回值返回而非直接中断全部
    )
    cost = time.perf_counter() - start
    print(f"全部下载完毕,结果列表: {results}")
    print(f"总耗时: {cost:.2f} 秒 (并发下取决于最慢任务)")

if __name__ == "__main__":
    asyncio.run(main())
示例输出:
必背代码 3:Python 3.11+ 结构化并发 TaskGroup
在现代 Python 代码中,官方推荐使用 asyncio.TaskGroup 上下文管理器替代传统的 gather。它的最大优势在于异常安全性(Structured Concurrency):当其中某一个任务抛出异常失败时,TaskGroup 会自动向其他仍在运行的任务发送取消信号(cancel),避免孤儿任务持续泄漏资源。
import asyncio

async def worker(task_id: int):
    await asyncio.sleep(0.5)
    return task_id * 10

async def main():
    tasks = []
    # 使用 TaskGroup 结构化管理子任务
    async with asyncio.TaskGroup() as tg:
        for i in range(1, 4):
            task = tg.create_task(worker(i))
            tasks.append(task)
    # 退出上下文代码块时,所有任务均已确定完成
    results = [t.result() for t in tasks]
    print("TaskGroup 执行结果:", results)

if __name__ == "__main__":
    asyncio.run(main())
三、任务生命周期:Task 与后台任务管理
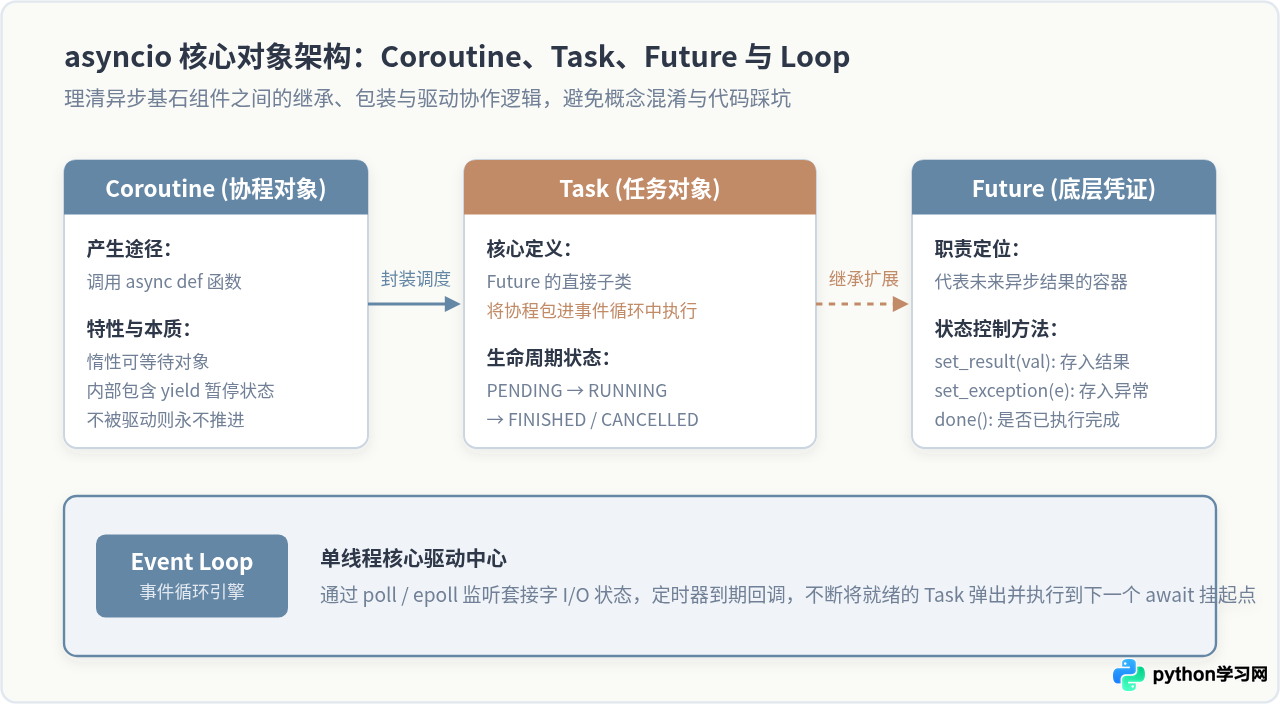
在异步服务端开发(如 FastAPI 或后台消费者)中,经常需要在不阻塞当前响应流程的前提下,在后台派发一个异步任务。此时需要使用 asyncio.create_task()。
必背代码 4:create_task 后台派发与强引用防垃圾回收
import asyncio

# 声明后台任务强引用集合,防止被 Python 垃圾回收器静默销毁
background_tasks = set()

async def background_log(event_name: str):
    await asyncio.sleep(1.0)
    print(f"[后台任务完成] 事件 {event_name} 写入审计日志成功")

async def handle_user_request():
    print("1. 接收到用户请求,开始主流程业务处理")

    # 派发后台任务,不等待其执行完毕立即继续
    task = asyncio.create_task(background_log("USER_LOGIN"))
    background_tasks.add(task)
    task.add_done_callback(background_tasks.discard)

    print("2. 主流程处理完毕,先行返回响应给用户")
    await asyncio.sleep(0.1)

async def main():
    await handle_user_request()
    # 等待后台任务全部执行收尾
    if background_tasks:
        await asyncio.gather(*background_tasks)

if __name__ == "__main__":
asyncio.run(main())Python 官方文档明确指出:asyncio.create_task() 仅对任务持有弱引用。如果创建的任务没有赋值给变量或放入长期存在的容器中,Python 垃圾回收器可能会在任务执行过程中将其作为未引用对象回收,导致任务未抛出任何错误便静默终止。
四、防雪崩控制:超时熔断、并发限流与阻塞桥接
在真实生产环境中,不受限制的并发和未加防御的慢请求很容易引发系统雪崩。以下三段代码是处理健壮性问题的关键防线。
必背代码 5:wait_for 超时保护
import asyncio

async def query_remote_service():
    # 模拟由于网络抖动导致的极慢响应
    await asyncio.sleep(5.0)
    return "Service Response"

async def main():
    try:
        # 设置最大容忍时间为 1.5 秒
        result = await asyncio.wait_for(query_remote_service(), timeout=1.5)
        print("响应结果:", result)
    except asyncio.TimeoutError:
        print("[报警] 请求远端服务超时 (已触发熔断并自动取消该任务)")

if __name__ == "__main__":
    asyncio.run(main())
必背代码 6:Semaphore 信号量限制最大并发度
当需要爬取上千个网页或调用有限流策略的外部 API 时,如果不加节制发起成千上万个并发连接,会导致本地套接字耗尽或被对方封禁。使用 asyncio.Semaphore 可以精确控制同时处于活动状态的任务上限:
import asyncio

async def limited_request(sem: asyncio.Semaphore, req_id: int):
    # 获得信号量许可,超过上限的任务在此等待
    async with sem:
        print(f"[{req_id}] 获取到连接许可,发起请求...")
        await asyncio.sleep(1.0)
        print(f"[{req_id}] 请求结束,释放连接许可")
        return req_id

async def main():
    # 限制同时最多并发 3 个请求
    sem = asyncio.Semaphore(3)
    tasks = [limited_request(sem, i) for i in range(1, 8)]
    await asyncio.gather(*tasks)

if __name__ == "__main__":
    asyncio.run(main())
必背代码 7:to_thread 桥接同步阻塞库
在现实项目中,很多第三方类库(如 requests、本地文件磁盘读写、加密计算或旧版数据库驱动)并不支持 async/await。如果在协程内直接调用阻塞函数,会导致整个单线程事件循环彻底卡死。使用 asyncio.to_thread(Python 3.9+)可将阻塞调用安全放入后台线程池:
import asyncio
import time

def blocking_io_read(filepath: str):
    # 模拟同步磁盘读写或第三方同步 HTTP 客户端
    time.sleep(1.2)
    return f"内容来自 {filepath}"

async def main():
    print("开始在事件循环中调度同步阻塞函数...")
    start = time.perf_counter()
    # 将同步函数提交到线程池中运行,避免卡死当前事件循环
    data = await asyncio.to_thread(blocking_io_read, "config.json")
    print(f"读取成功: {data},耗时: {time.perf_counter() - start:.2f}s")

if __name__ == "__main__":
    asyncio.run(main())
五、全景速查与避坑准则
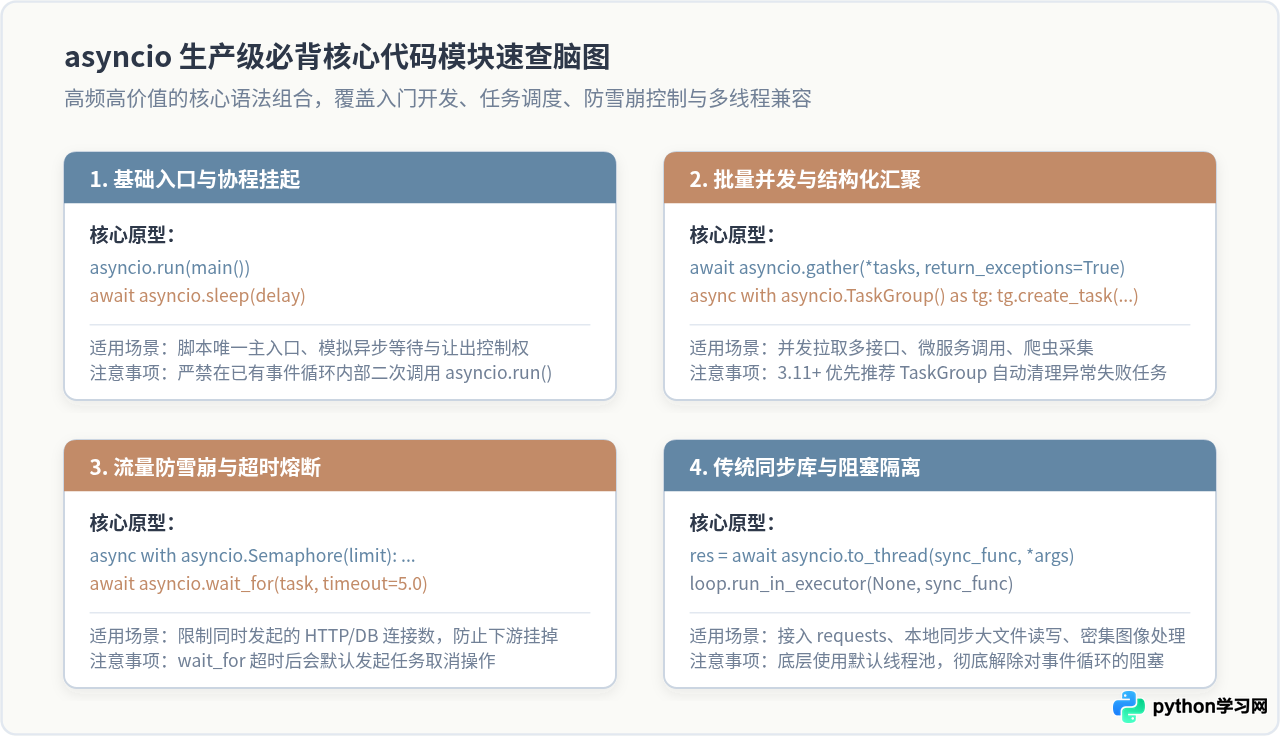
为了让读者在实际编码时快速查阅对应的 API 组合与使用边界,下图总结了本文介绍的所有经典代码模块与应用场景:
日常排错四项黄金法则
- 绝不在协程内使用
time.sleep():必须统一使用await asyncio.sleep()。前者会强行挂起整个进程的 CPU 线程,导致事件循环内所有并发任务瞬间冻结。 - 凡是
async def的函数必须await或包入Task:仅写foo()并不会执行代码,解释器只会输出一条RuntimeWarning: coroutine was never awaited警告。 - 辨析 CPU 密集型与 I/O 密集型:
asyncio的核心优势在于网络与磁盘 I/O 等待重叠;对于复杂的图像处理、机器学习推断或数学计算等 CPU 密集任务,必须使用ProcessPoolExecutor多进程调度,而非纯协程。 - 谨慎对待异常传播:在
asyncio.gather中使用return_exceptions=True或采用 Python 3.11 的TaskGroup,确保单任务抛出异常时不会导致整批并发状态不可控。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















