


Python str.split()基础用法:默认分隔符与返回值解析

深入解析 Python str.split() 基础用法,系统梳理默认分隔符处理空白字符的算法逻辑、返回值类型与边界表现,并对比显式传参差异。
str.split() 是最常被调用的基础方法之一。当不传递任何参数调用 s.split() 时,Python 默认将任意连续的空白字符视为一个整体分隔符,并自动剔除字符串首尾的所有空白。本文将具体剖析 str.split() 在默认分隔符下的执行机制、与显式指定空格参数的本质区别,以及各种边界条件下的返回值特性。
一、从一个常见现象切入:默认切分究竟发生了什么?
许多初学者在使用 str.split() 处理带空格的字符串时,往往直觉地认为它只是“遇到空格就切一刀”。但在处理从文件、网络接口或命令行获取的实际文本时,数据往往包含多个连续空格、制表符 \t 甚至尾部的换行符 \n。
观察以下两行看起来极度相似的代码:
text = "   Python   str.split() \t\n  "

# 方式一:不传参数(默认分隔符)
print(text.split())
# 输出: ['Python', 'str.split()']

# 方式二:显式传入单空格
print(text.split(' '))
# 输出: ['', '', '', 'Python', '', '', 'str.split()', '\t\n', '', '']
可以看到,完全相同的输入字符串,不传参的 split() 返回了一个干净利落的二元列表,而传入 ' ' 的调用却输出了包含大量空字符串 "" 的冗长列表,并且其中的制表符与换行符并没有被分割。这个差异说明:str.split() 在默认状态下并不是简单地等同于 str.split(' '),而是执行了一套专门为处理人类自然排版空白而设计的聚合算法。
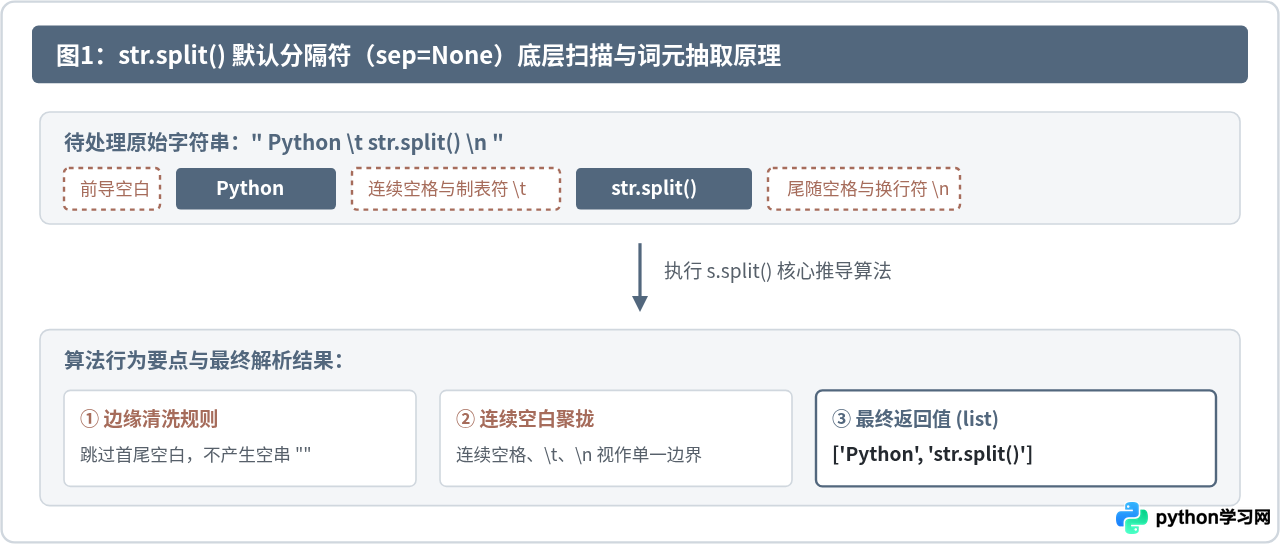
二、默认分隔符(sep=None)的底层运作机制
在 Python 官方规范中,str.split(sep=None, maxsplit=-1) 的参数 sep 默认值为 None。当 sep 未指定或明确传入 None 时,其处理逻辑具有以下三项核心规则:
- 涵盖所有 ASCII 空白字符:默认切分不仅匹配常规的单字节空格(ASCII 32),还会识别制表符(
\t)、换行符(\n)、回车符(\r)、换页符(\f)以及垂直制表符(\v)。 - 自动连续空白聚合:任何连续出现的空白字符都会被打包组合成一个单一的分隔区间。两个非空白文本段落之间无论间隔了1个空格还是10个由空格与换行混排的字符,都只触发一次切分。
- 剥离两侧边缘:字符串开头的空白和结尾的空白均被直接忽略,绝不会在结果列表的第一项或最后一项产生空字符串
""。
这种设计契合大多数基于词(token)进行文本提取的实际需求。例如,在处理格式不够统一的控制台输出或用户输入时,调用方通常只在乎有意义的词语本身,而不希望被多余的排版对齐空格所干扰。
三、默认切分 vs 显式指定切分(split() 与 split(' ') 的严格对比)
理解 split() 与 split(' ') 的差异,是编写稳健 Python 代码的关键。当显式为 sep 赋值(例如 sep=' ' 或 sep=',')时,Python 将完全切换到严格字符匹配模式:
- 不再聚合:每个单独匹配到的分隔符都会划定一个分界点。连续两个空格之间必定会切出一个空字符串
""。 - 不再忽略边缘:如果字符串以分隔符开头,返回列表的第一项必定是
"";如果以分隔符结尾,最后一项必定也是""。 - 仅匹配字面值:传入
' '就只会匹配 ASCII 32 空格,遇到制表符\t或换行符\n时,它们会被当成普通非空白文本保留在子串中。
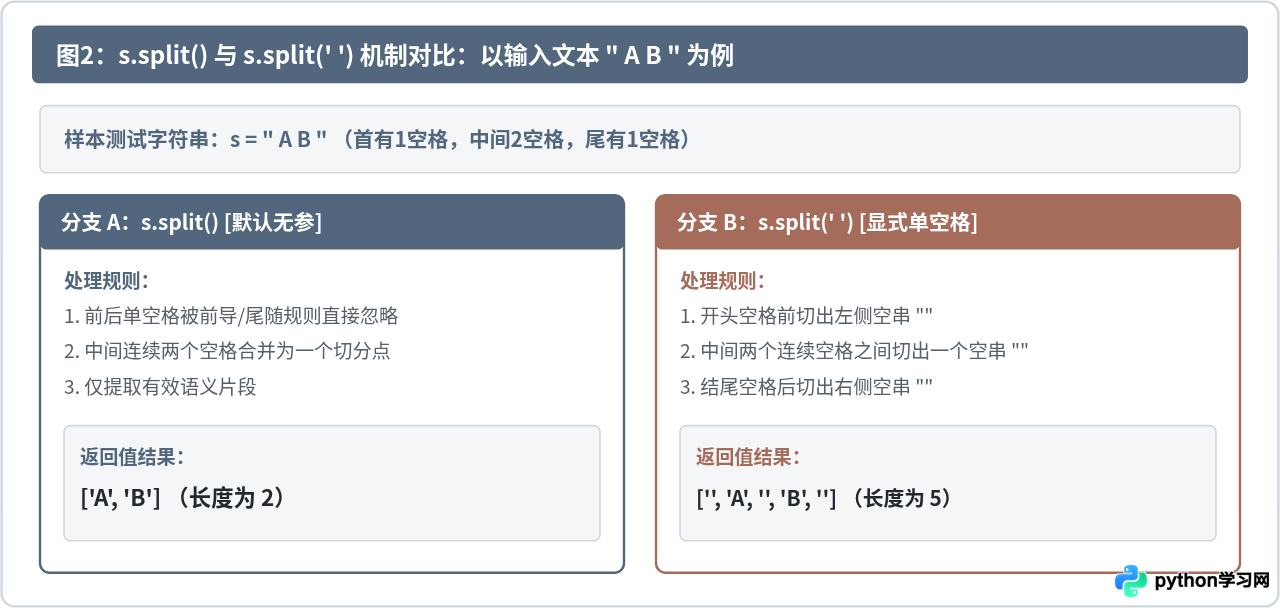
下表详细汇总了两种方式在不同输入模式下的直观对比:
| 输入字符串 (s) | s.split()(默认模式) | s.split(' ')(显式单空格) | 核心差异说明 |
|---|---|---|---|
"hello world" |
['hello', 'world'] |
['hello', 'world'] |
单空格相隔且无首尾空格时,两者表现一致 |
"hello world" |
['hello', 'world'] |
['hello', '', '', 'world'] |
默认模式合并3个连续空格;显式模式产生2个空串 |
" hello " |
['hello'] |
['', 'hello', ''] |
默认模式忽略首尾;显式模式在首尾各自生成空串 |
"a\tb\nc" |
['a', 'b', 'c'] |
['a\tb\nc'] |
默认模式识别制表与换行;显式模式不匹配其他空白 |
" "(纯空白) |
[](空列表) |
['', '', '', ''] |
默认模式直接返回空列表;显式模式产生4个空串 |
""(空字符串) |
[](空列表) |
[''](含1个空串) |
边界情况下的重大差异,后续章节将深入解析 |
四、返回值类型与边界值深度解析
无论传入何种参数,str.split() 的返回值类型始终是 Python 原生的 list(列表),列表中的每一个元素都是 str 类型。原字符串本身是不可变对象(immutable),因此 split() 绝不会在原地修改原字符串,而是创建并返回一个全新的字符串列表。
1. 空字符串 "" 的切分边界
处理用户输入或空文件时,空字符串是非常容易遇到的边界情况。这里的返回值非常关键:
# 默认模式处理空字符串
empty_str = ""
res1 = empty_str.split()
print(res1)        # []
print(len(res1))   # 0

# 显式模式处理空字符串
res2 = empty_str.split(',')
print(res2)        # ['']
print(len(res2)) # 1注意这个核心区别:在默认模式下,"".split() 返回的是完全没有任何元素的空列表 [];而在显式模式下(无论是 split(',') 还是 split(' ')),如果整个字符串中没有任何分隔符,Python 会将整个字符串作为唯一元素放入列表中返回,因此返回的是包含一个空字符串的列表 ['']。这在进行长度断言或解构赋值时极其容易引发 ValueError 或 IndexError。
2. 全空白字符串的切分边界
当字符串只由空格、制表符或换行符构成时:
blank_str = "  \t \n \r  "
print(blank_str.split())  # []
因为默认算法先扫描并跳过所有的前导空白,直到遇到有效字符;如果一直扫描到字符串结尾都没有遇到任何非空白字符,则直接判定没有提取到任何有效词元,返回 []。
3. 未找到目标分隔符时的返回值
当输入文本不包含任何预期的分隔标志时,例如在默认模式下处理单字词 "Python".split(),或者在指定逗号模式下处理 "Python".split(','):
word = "Python"
print(word.split())     # ['Python']
print(word.split(','))  # ['Python']
只要原字符串含有非空白字符,且没有被切开,返回列表的长度就始终为 1,且该唯一元素与原字符串内容相同。
五、规范工程实践:文本清洗与解析四步法
在实际工程代码中,拆分字符串通常是清洗脏数据或解析结构化文本的第一道工序。为了避免因格式异常导致程序崩溃,建议遵循以下标准处理流程:
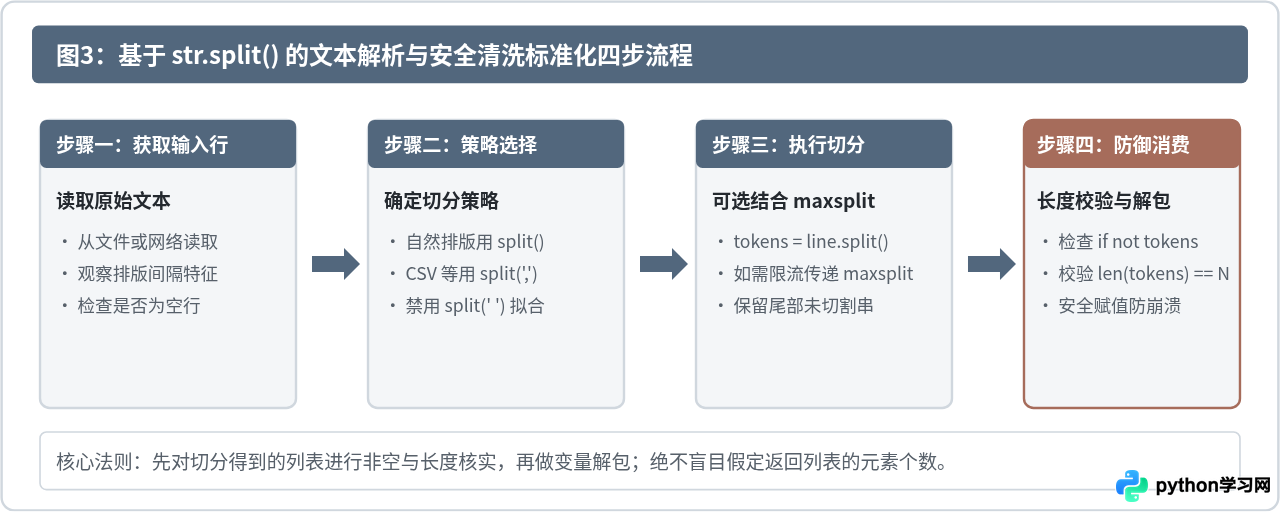
以下为一个典型日志数据行解析的示范示例:
# 示例输入:服务器访问记录,列与列之间由不同数量的空格对齐
log_line = "2026-10-17 10:45:02    INFO    Server   Worker-4: Job finished"

# 错误示范:盲目直接拆解可能会因空格数量变化失控
# 推荐做法:结合默认 split() 的合并优势与 maxsplit 参数

# 需求:只需要提取日期、时间、级别、主机名,后面的日志内容保持完整
parts = log_line.split(maxsplit=4)

if len(parts) == 5:
    log_date, log_time, level, host, message = parts
    print(f"级别: {level}, 产生源: {host}, 详情: {message}")
else:
    print("行数据格式不符,予以告警或跳过")

# 示例输出:
# 级别: INFO, 产生源: Server, 详情: Worker-4: Job finishedmaxsplit 控制最大分割次数,返回列表的最大长度为 maxsplit + 1。如果需要使用默认的分隔符逻辑(聚合空白),同时指定 maxsplit,必须采用关键字传参 s.split(maxsplit=2),或者将第一个位置参数显式设为 None 即 s.split(None, 2),绝不能随意传入 s.split(' ', 2)。
六、总结与规则速查矩阵
掌握 str.split() 的核心在于记住两套模式的分野:需要按人类书写惯例提取词汇、清洗多重空白时,毫不犹豫地使用无参的 s.split();需要按格式协议(如 CSV、TSV)精准保留每个字段占位时,显式指定字符(如 s.split(','))。
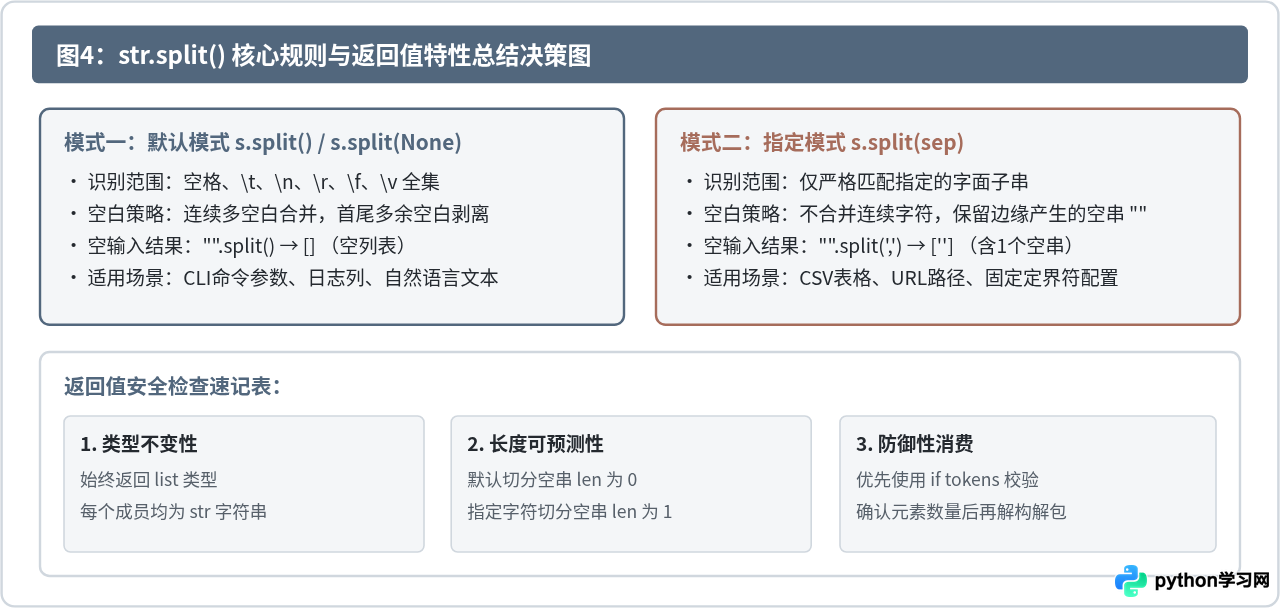
在日常编写代码时,养成直接调用 s.split() 提取空白分词的习惯,能够天然避开绝大多数由于空格数量不一致引发的数据污染问题;而清楚认识到其返回 [] 的边界特性,则能让我们的下游处理逻辑更加从容、健壮。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















