


除了爬虫和AI,Python还能用于哪些自动化运维与脚本开发场景
深入解析Python在自动化运维与日常脚本开发中的关键应用场景,包括主机巡检、日志分析统计、多主机批量控制、自动化备份验证与内部工作流粘合,并提供实战代码与运维闭环建议。
在许多初学者的印象中,Python主要与网页爬虫、数据分析或人工智能深度绑定。然而在实际的企业生产环境中,Python凭借直观的语法、健全的标准库以及覆盖广泛的操作系统生态,长期稳居自动化运维与工程胶水脚本开发的主力地位。无论面对单机巡检、海量节点批量维护,还是异构系统之间的业务流转,Python都能快速交付稳定、可重复执行的自动化程序。本文将具体介绍Python在爬虫和AI之外的五大核心运维开发场景,并提供可直接运行的脚本与实践规范。
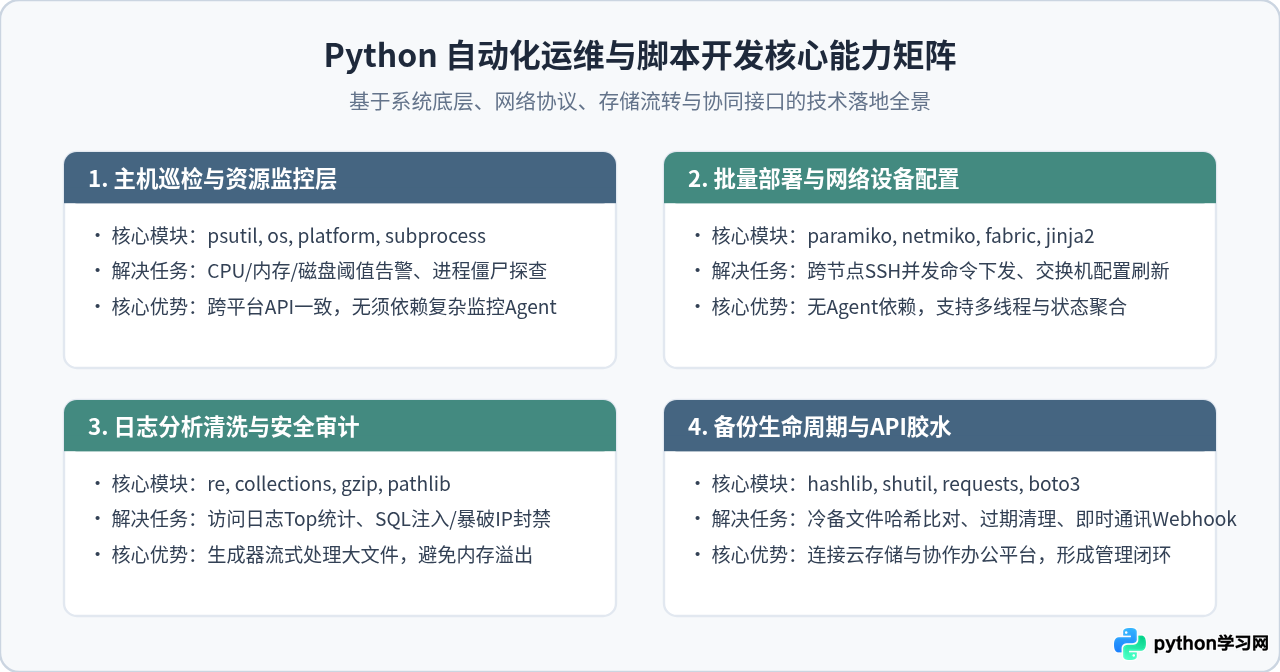
场景一:服务器资源监控与自动化巡检
在没有部署大型集中监控平台(如 Prometheus 或 Zabbix)的中小型集群或边缘节点中,运维人员经常需要快速探查主机的健康状况。传统 Shell 脚本在不同操作系统(例如 CentOS 与 Ubuntu,或 Linux 与 macOS)之间的命令输出格式存在细微差异,解析 df -h 或 free -m 的文本往往不够健壮。
使用 Python 的 psutil 模块,可以直接跨平台获取结构化硬件指标。以下脚本演示如何周期性检查磁盘各分区的占用率,当任一分区超过设定阈值时打印告警信息,并可方便地接入后续通知流程:
# monitor_disk.py
# 运行环境:Python 3.8+,需安装 psutil: pip install psutil
import sys
import psutil

DISK_WARNING_THRESHOLD = 85.0  # 使用率报警阈值百分比

def inspect_disk_usage(threshold):
    partitions = psutil.disk_partitions(all=False)
    has_warning = False

    print(f"开始执行磁盘巡检,设定警报阈值: {threshold}%")
    for part in partitions:
        # 排除只读挂载与虚拟文件系统
        if 'cdrom' in part.opts or part.fstype == '':
            continue
        try:
            usage = psutil.disk_usage(part.mountpoint)
            status = "NORMAL"
            if usage.percent >= threshold:
                status = "WARNING"
                has_warning = True

            print(f"[{status}] 挂载点: {part.mountpoint:<15} "
                  f"总容量: {usage.total / (1024**3):.1f} GB "
                  f"已用: {usage.percent:.1f}%")
        except PermissionError:
            continue

    return 1 if has_warning else 0

if __name__ == "__main__":
    exit_code = inspect_disk_usage(DISK_WARNING_THRESHOLD)
sys.exit(exit_code)[NORMAL] 挂载点: / 总容量: 98.4 GB 已用: 54.2%
[WARNING] 挂载点: /data 总容量: 500.0 GB 已用: 89.6%
[NORMAL] 挂载点: /var/log 总容量: 49.2 GB 已用: 31.8%
通过让脚本根据巡检结果返回明确的退出码(正常为 0,告警为 1),外部定时调度器(如 Linux 的 cron 或 CI/CD Runner)便能准确识别是否需要触发报警中断。
场景二:海量日志分析、流式清洗与异常告警
服务排障与安全审计中,日志文件通常体积巨大。若直接将数个吉字节(GB)的日志一次性读入内存,极易导致服务器发生内存溢出(OOM)。Python 的生成器机制允许逐行流式读取日志,结合正则表达式和内置标准库 collections.Counter,可以高效完成高频 IP 统计、HTTP 状态码分布聚类等分析。
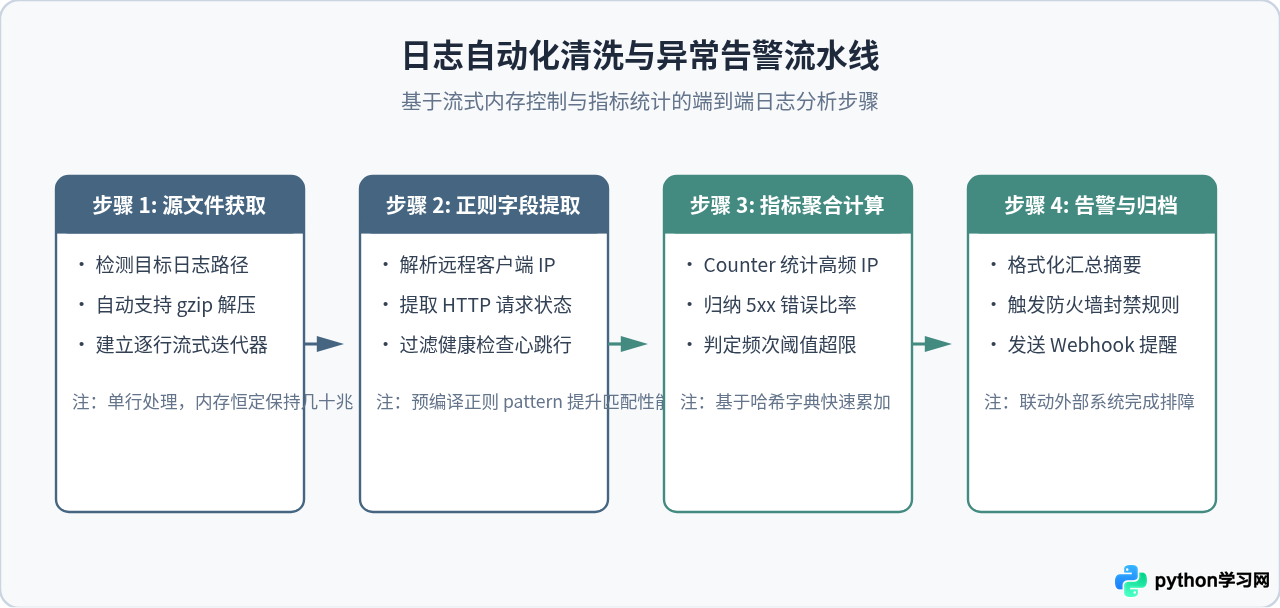
下面是一个标准的 Nginx 访问日志分析脚本,通过流式解析统计请求量最高的前 5 个 IP 地址,并统计 4xx 与 5xx 状态码总数:
# parse_nginx_log.py
# 运行环境:Python 3.8+ 标准库,无需额外依赖
import re
from collections import Counter

# 匹配标准 Nginx 组合日志格式的前段: IP - - [时间] "METHOD URL PROTOCOL" STATUS ...
LOG_PATTERN = re.compile(r'^(\S+) \S+ \S+ \[.*?\] ".*?" (\d{3})')

def analyze_access_log(file_path, top_n=5):
    ip_counter = Counter()
    status_counter = Counter()
    total_lines = 0

    with open(file_path, 'r', encoding='utf-8', errors='ignore') as f:
        for line in f:
            total_lines += 1
            match = LOG_PATTERN.match(line)
            if match:
                ip, status = match.groups()
                ip_counter[ip] += 1
                status_counter[status] += 1

    print(f"--- 日志分析报告 (共处理 {total_lines} 行) ---")
    print(f"Top {top_n} 来源 IP:")
    for ip, count in ip_counter.most_common(top_n):
        print(f"  {ip:<18} {count} 次")

    error_5xx = sum(count for code, count in status_counter.items() if code.startswith('5'))
    error_4xx = sum(count for code, count in status_counter.items() if code.startswith('4'))
    print(f"\n状态码分布: 4xx客户端错误: {error_4xx} 次 | 5xx服务端错误: {error_5xx} 次")

if __name__ == "__main__":
    # 使用时替换为实际的 access.log 路径
analyze_access_log("access.log", top_n=3)Top 3 来源 IP:
192.168.1.105 14205 次
10.0.8.22 9812 次
172.16.0.4 4100 次
状态码分布: 4xx客户端错误: 312 次 | 5xx服务端错误: 14 次
场景三:多主机批量远程运维与配置下发
在集群规模较小且未上架 Ansible、SaltStack 等配置管理工具时,运维人员若通过手动 SSH 逐台登录服务器执行升级命令或搜集信息,效率低下且容易发生漏操作。利用 paramiko 库,可以用简洁的代码建立 SSH 连接,并利用多线程并发下发指令。
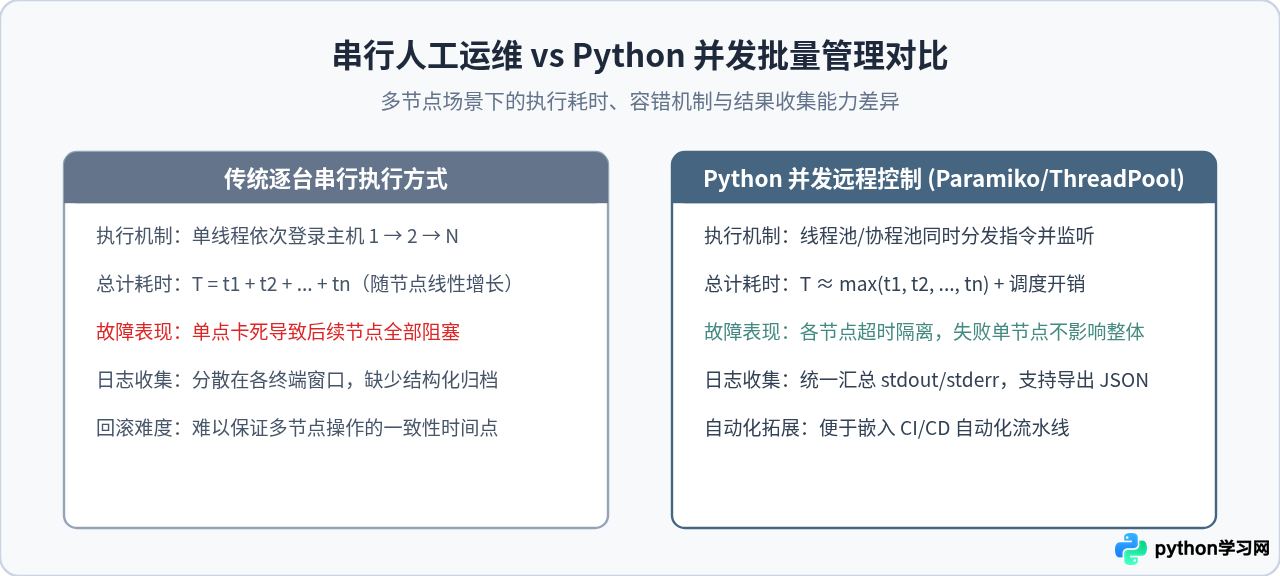
下面的代码展示了使用 concurrent.futures.ThreadPoolExecutor 与 paramiko 对多台主机并发执行命令并汇总输出的完整范例:
# batch_exec_ssh.py
# 运行环境:Python 3.8+,需安装 paramiko: pip install paramiko
import paramiko
from concurrent.futures import ThreadPoolExecutor, as_completed

# 待管理的节点列表 (主机IP, 端口, 用户名, 私钥路径)
SERVERS = [
    {"host": "192.168.10.11", "port": 22, "user": "root", "key": "/root/.ssh/id_rsa"},
    {"host": "192.168.10.12", "port": 22, "user": "root", "key": "/root/.ssh/id_rsa"},
    {"host": "192.168.10.13", "port": 22, "user": "root", "key": "/root/.ssh/id_rsa"},
]

def run_remote_command(server_info, command, timeout=10):
    host = server_info["host"]
    client = paramiko.SSHClient()
    client.set_missing_host_key_policy(paramiko.AutoAddPolicy())

    try:
        client.connect(
            hostname=host,
            port=server_info["port"],
            username=server_info["user"],
            key_filename=server_info["key"],
            timeout=timeout
        )
        stdin, stdout, stderr = client.exec_command(command, timeout=timeout)
        output = stdout.read().decode('utf-8').strip()
        err = stderr.read().decode('utf-8').strip()
        return host, True, output if output else err
    except Exception as e:
        return host, False, str(e)
    finally:
        client.close()

def batch_execute(command):
    print(f"正在向 {len(SERVERS)} 台主机下发指令: {command}")
    with ThreadPoolExecutor(max_workers=5) as executor:
        future_map = {executor.submit(run_remote_command, s, command): s["host"] for s in SERVERS}
        for future in as_completed(future_map):
            host, success, result = future.result()
            flag = "SUCCESS" if success else "FAILED"
            print(f"[{flag}] {host} -> {result}")

if __name__ == "__main__":
batch_execute("uptime")[SUCCESS] 192.168.10.11 -> 02:15:30 up 45 days, 1 user, load average: 0.12, 0.08, 0.05
[SUCCESS] 192.168.10.12 -> 02:15:31 up 12 days, 2 users, load average: 0.45, 0.32, 0.20
[SUCCESS] 192.168.10.13 -> 02:15:30 up 98 days, 1 user, load average: 0.02, 0.01, 0.00
场景四:自动化备份校验与冷数据生命周期管理
数据库与核心配置文件的备份是系统抗风险的底线。然而,“只备份、不验证”是许多技术团队的隐形灾难:如果备份文件因网络中断写入不全、或者磁盘坏道损坏,恢复时将无能为力。此外,缺乏自动清理机制的备份目录极易撑满数据盘。
Python 可以轻松协调本地系统命令(如 mysqldump 或 tar),随后自动计算备份文件的哈希校验和(如 SHA256)记录于日志中,最后根据文件最后修改时间(mtime)清理超出保存期限的历史文件:
# backup_and_cleanup.py
# 运行环境:Python 3.8+ 标准库
import os
import time
import hashlib
from pathlib import Path

BACKUP_DIR = Path("/data/backups")
RETENTION_DAYS = 30  # 保留最近30天的文件

def calculate_sha256(filepath):
    """分块读取计算哈希,避免大文件占用过多内存"""
    sha256_hash = hashlib.sha256()
    with open(filepath, "rb") as f:
        for byte_block in iter(lambda: f.read(65536), b""):
            sha256_hash.update(byte_block)
    return sha256_hash.hexdigest()

def purge_expired_backups(directory, days):
    current_time = time.time()
    cutoff_time = current_time - (days * 86400)
    purged_count = 0

    for item in directory.glob("*.tar.gz"):
        if item.is_file() and item.stat().st_mtime < cutoff_time:
            item.unlink()
            print(f"[清理旧备份] 已移除过期归档: {item.name}")
            purged_count += 1
    return purged_count

def verify_and_record(filepath):
    if not filepath.exists() or filepath.stat().st_size == 0:
        raise ValueError(f"备份文件异常或为空: {filepath}")

    checksum = calculate_sha256(filepath)
    size_mb = filepath.stat().st_size / (1024 * 1024)
    print(f"[备份完整性确认] 文件: {filepath.name} | 大小: {size_mb:.2f} MB")
    print(f"[SHA256 校验和] {checksum}")

if __name__ == "__main__":
    test_file = BACKUP_DIR / "db_20261017.tar.gz"
    # 模拟验证已生成的备份文件
    if test_file.exists():
        verify_and_record(test_file)
    # 清理过期历史文件
    removed = purge_expired_backups(BACKUP_DIR, RETENTION_DAYS)
    print(f"清理完成,共移除 {removed} 个历史归档。")
场景五:API 胶水开发与即时通信工作流集成
在现代化运维协同体系中,通知与告警需要第一时间同步至工程师日常使用的协作软件中,例如飞书、企业微信、钉钉或 Slack。通过 Python 的 requests 模块,只需十几行代码即可实现标准化 Webhook 消息推送函数,为各处孤立的运维脚本赋能报警能力:
# alert_webhook.py
# 运行环境:Python 3.8+,需安装 requests: pip install requests
import requests
import json

WEBHOOK_URL = "https://open.feishu.cn/open-apis/bot/v2/hook/xxxxxx-xxxx-xxxx"

def send_alert_card(title, message, level="INFO"):
    color_map = {
        "INFO": "blue",
        "WARNING": "orange",
        "CRITICAL": "red"
    }

    payload = {
        "msg_type": "interactive",
        "card": {
            "header": {
                "title": {"tag": "plain_text", "content": f"[{level}] {title}"},
                "template": color_map.get(level, "grey")
            },
            "elements": [
                {
                    "tag": "div",
                    "text": {"tag": "lark_md", "content": message}
                }
            ]
        }
    }

    headers = {"Content-Type": "application/json"}
    try:
        response = requests.post(WEBHOOK_URL, data=json.dumps(payload), headers=headers, timeout=5)
        response.raise_for_status()
        print("告警卡片发送成功。")
    except requests.RequestException as e:
        print(f"告警推送失败: {e}")

if __name__ == "__main__":
    send_alert_card(
        title="核心节点磁盘空间告警",
        message="主机 **192.168.10.11** 上的 `/data` 挂载点使用率达到 **89.6%**,已触发预警阀值,请及时处理。",
        level="WARNING"
    )
生产环境落地规范与避坑指南
将 Python 脚本真正应用于生产环境的日常维护时,有几个关键规范直接决定了脚本能否稳定执行,而不会因环境问题出现“在测试机正常、到定时任务就失灵”的情况:
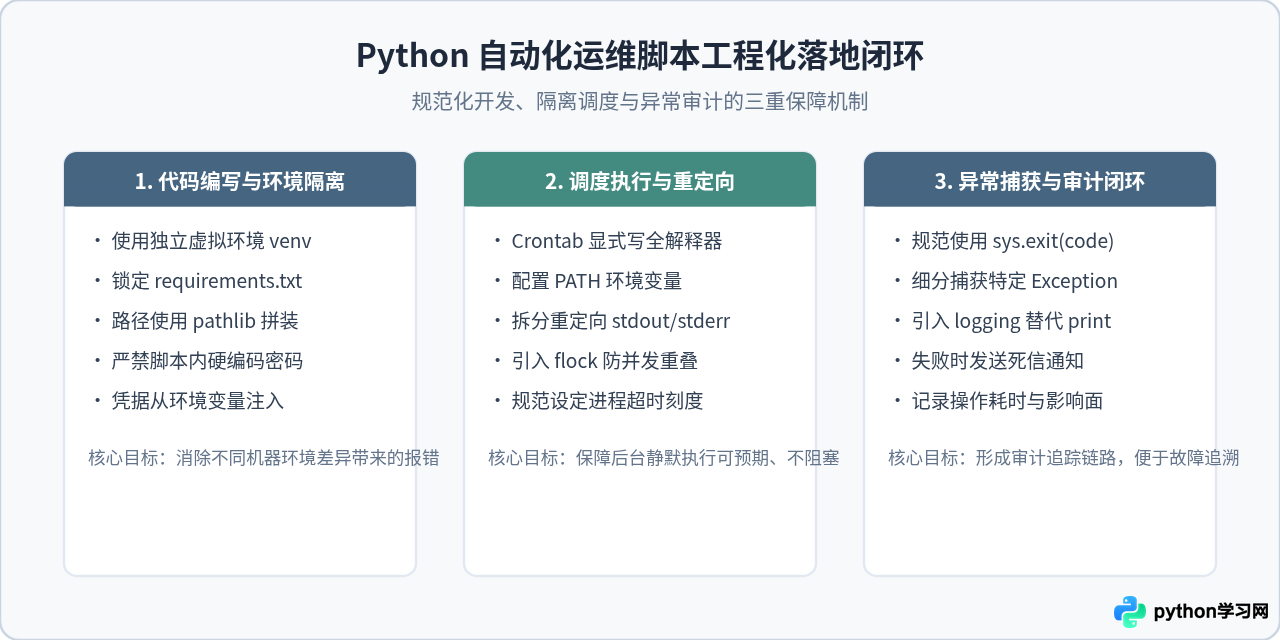
- Crontab 必须写全路径并加载环境:在 Linux 的 cron 计划任务中,默认执行环境非常精简,
PATH环境变量通常只包含基本目录,且不会自动加载用户的.bashrc。因此,调度命令必须使用虚拟环境解释器的绝对路径,如/opt/pyenv/bin/python3 /opt/scripts/monitor.py >> /var/log/monitor.log 2>&1。 - 网络请求必须显式设置 Timeout:无论是调用
requests发起 Webhook 告警,还是使用paramiko连接远程主机,都必须显式设定超时时间(例如timeout=10)。未设置超时的网络调用一旦遭遇对方服务无响应,将导致 Python 进程永久挂起。 - 善用退出状态码(Exit Code):确保主程序在正常完成时返回
sys.exit(0),发生未预期错误时返回非零值。这能让外层的自动化流编排工具(如 GitLab CI、Jenkins、Systemd)准确研判当前任务状态,从而做出重试或熔断决策。
综上所述,Python 在自动化运维领域的强大之处并非源自炫目的复杂技术,而是凭借扎实的基础库和强大的适配能力,将繁琐、易错的日常系统维护任务标准化、自动化。掌握这些实用场景,能够帮助运维和开发人员构建起坚固、可靠的底层基础设施支撑体系。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















