


Python读取网络CSV文件出现中文乱码怎么解决
详细解析使用Python和Pandas读取远程网络CSV文件时出现中文乱码的根本原因,并提供基于编码指定、BytesIO二进制流转换及自动编码检测的完整解决方案与避坑指南。
在 Python 中读取远程网络 CSV 文件时出现中文乱码,核心原因只有一个:下载得到的原始字节流编码格式与 Python 或 Pandas 预设的解码格式不一致。彻底解决该问题的直接路径包括三步:首先识别远程文件的真实编码(国内网络文件通常为 GBK、GB18030 或带 BOM 的 UTF-8);其次使用 requests 以二进制形式(response.content)获取完整字节流;最后通过 io.BytesIO 载入内存并在 pandas.read_csv() 中指定对应 encoding 参数完成解析。
一、乱码的具体表现与诊断路径
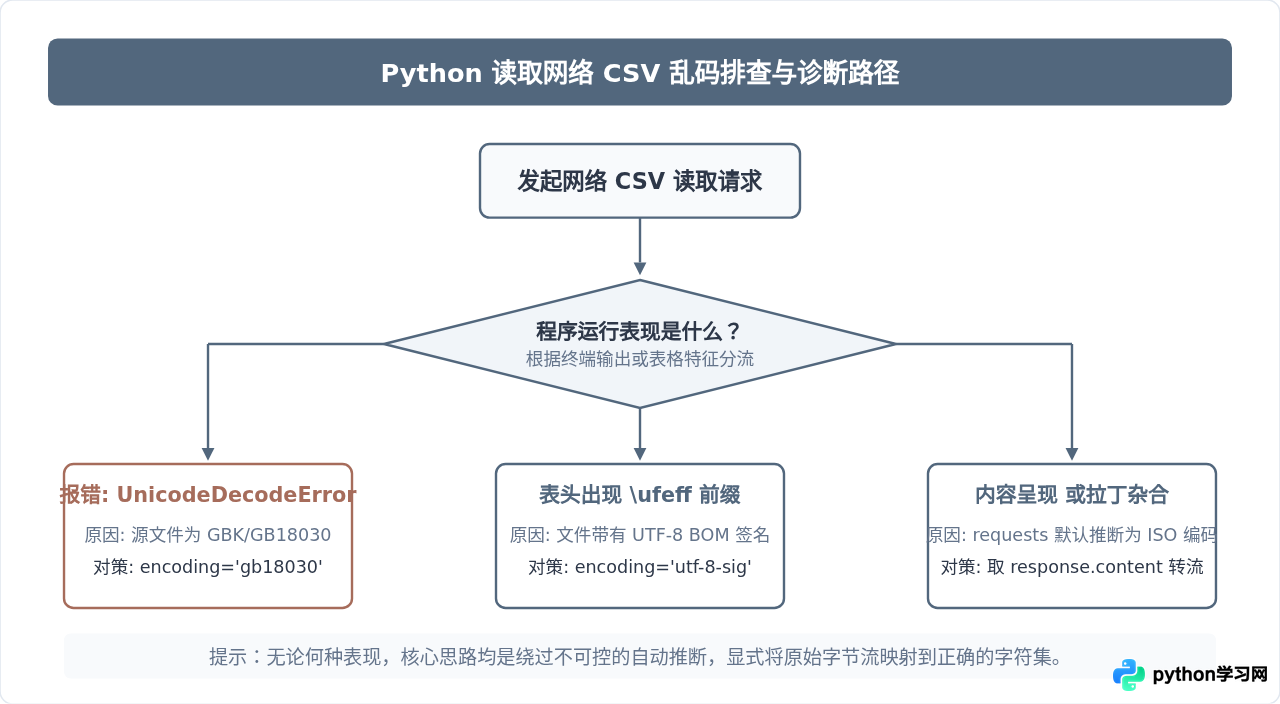
处理网络数据时,很多开发者习惯直接运行 pd.read_csv("https://example.com/data.csv")。当遇到中文内容时,通常会遇到以下三类典型故障现象:
- 直接报错崩溃:终端抛出
UnicodeDecodeError: 'utf-8' codec can't decode byte ... in position ...: invalid start byte。这表明文件实际是 GBK、GB2312 或 GB18030 编码,而 Pandas 默认尝试使用 UTF-8 规则进行逐字节解码,遇到无法匹配的字节序列时直接中断。 - 内容呈现为无意义符号(问号或菱形):程序并未抛出异常,但打印出的 DataFrame 中文字段全部显示为
。这通常是因为上游在转换过程中强行使用了不支持中文的编码(如 ASCII 或 ISO-8859-1)进行替换解码,或者底层使用了忽略错误的容错模式。 - 表头异常携带前缀符号:第一列字段名变成了
\ufeffID或类似前缀。这并非数据损坏,而是远程文件保存为了带有 BOM(Byte Order Mark)签名的 UTF-8 格式,普通的 UTF-8 解码器将该标记作为普通字符读入了表头。
二、底层机制:网络字节流与字符解码
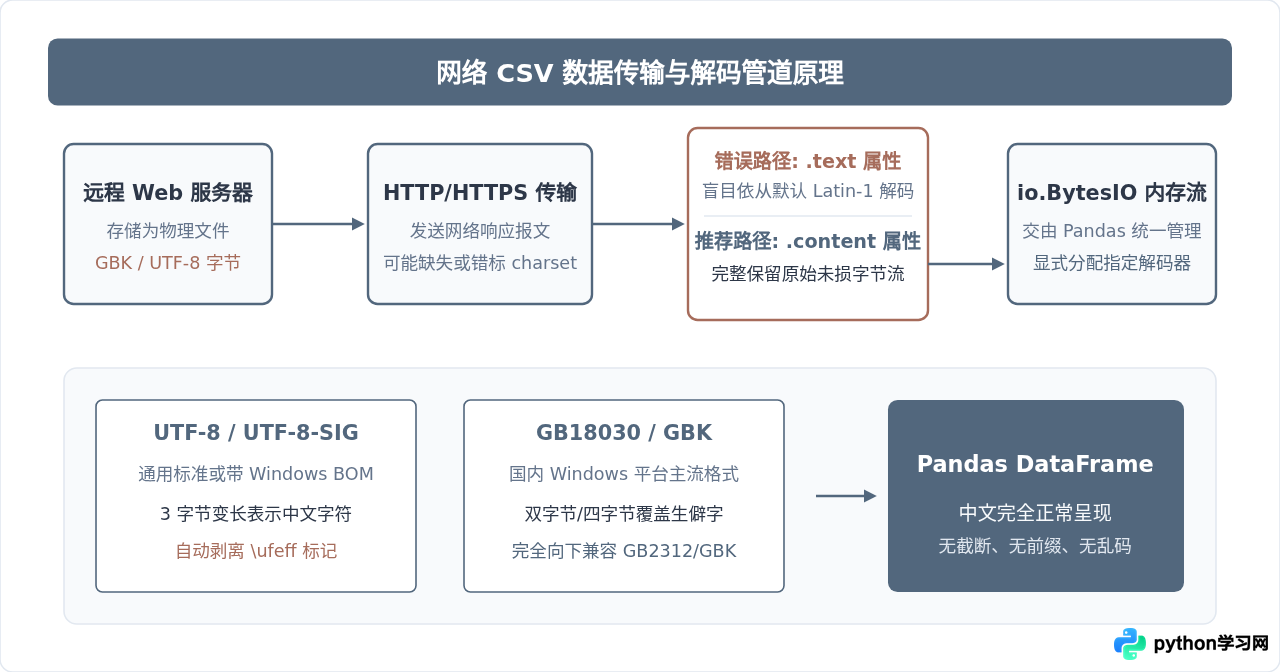
理解乱码产生的底层原理有助于在遇到复杂网络环境时迅速切中问题根源。文件在远程服务器上仅仅是一串十六进制的二进制字节(Bytes)。当通过 HTTP/HTTPS 协议请求该文件时,网络流将这些原始字节传输至本地客户端。
在 Python 中,如果直接使用 requests.get(url).text,requests 库会尝试读取 HTTP 响应头中的 Content-Type 字段。如果服务端没有显式指定 charset,按照 HTTP/1.1 规范(RFC 2616),requests 会自动回退到 ISO-8859-1(即西欧 Latin-1 编码)。此时如果强行提取 .text 并转入 Pandas,中文字符早已被西欧单字节编码破坏为形如 è¿ 的混合乱码,后续再做任何字符转换都无法还原。
三、具体解决步骤与完整代码实现
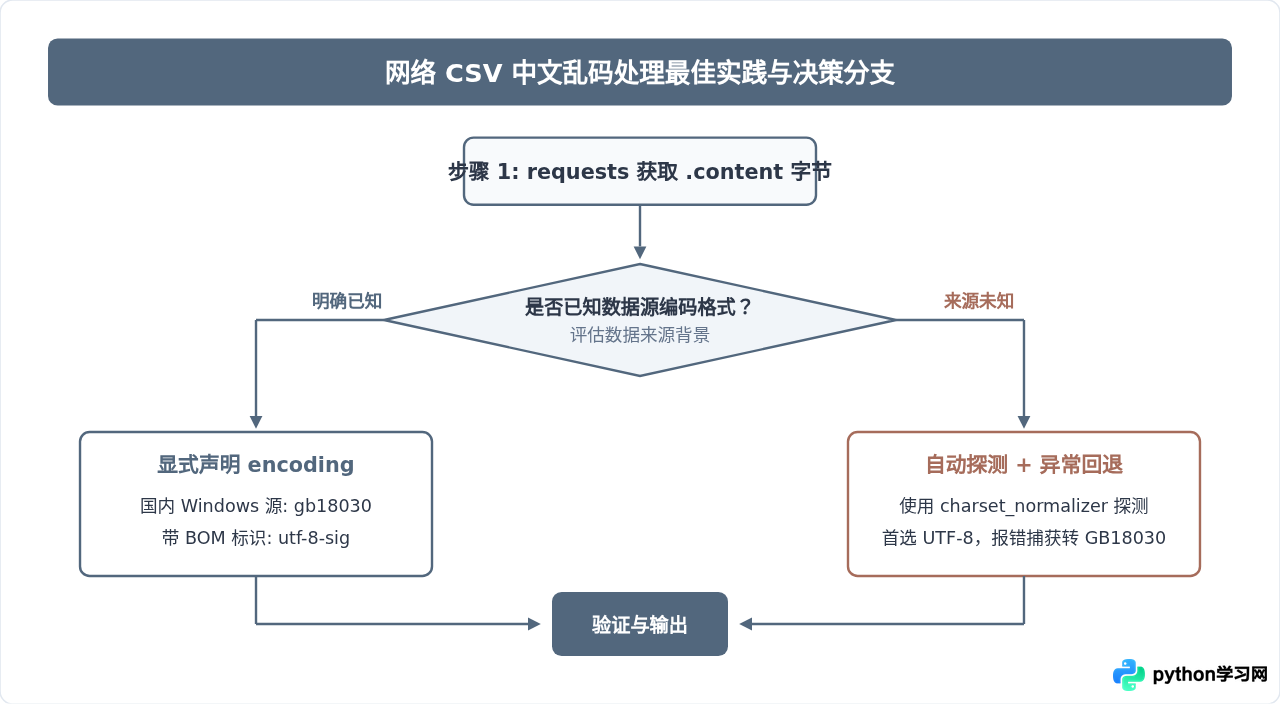
针对不同网络情况与编码确定性,解决方案可以分为三级递进策略。
1. 最直接场景:直接在 pd.read_csv 中声明 encoding
如果网络环境简单,不需要自定义 Request Header 或代理,且已知远程文件由中文 Windows 系统导出(例如国内某业务系统自动生成的报表),可直接在 read_csv 传入 URL 并指定 encoding='gb18030' 或 encoding='gbk':
import pandas as pd

# 示例:通过 encoding 指定 GB18030 兼容绝大多数中文编码文件
url = "https://example.com/export/sales_report.csv"

# 推荐使用 gb18030 而非仅使用 gbk,因为前者包含了生僻字与少数民族文字
df = pd.read_csv(url, encoding="gb18030")
print(df.head())
2. 生产级推荐:requests + BytesIO 二进制流分离法
在生产环境中直接向 pd.read_csv 传递 URL 存在明显短板:无法精细控制请求超时(Timeout)、无法添加认证 Token 或防盗链 Header,且底层 urllib 抛出的网络异常不易拦截。最稳健的工业级写法是:使用 requests 提取原始二进制内容,包装为内存流后再由 Pandas 读取。
import io
import requests
import pandas as pd

url = "https://example.com/data/network_sample.csv"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
}

# 1. 发起网络请求,设置超时时间
response = requests.get(url, headers=headers, timeout=15)
response.raise_for_status()

# 2. 核心操作:必须使用 response.content(原始 bytes),严禁使用 response.text
raw_bytes = response.content

# 3. 构造内存流,交由 pandas 解析
# 若首列出现 \ufeff,更换为 encoding="utf-8-sig"
# 若包含常规中文文件,使用 encoding="gb18030"
try:
    df = pd.read_csv(io.BytesIO(raw_bytes), encoding="utf-8")
except UnicodeDecodeError:
    df = pd.read_csv(io.BytesIO(raw_bytes), encoding="gb18030")

print("数据读取成功,前 3 行预览:")
print(df.head(3))
3. 面对未知来源:动态自动识别编码
当程序需要批量抓取大量来自不同机构的第三方网络 CSV 时,硬编码指定的字符集很容易崩溃。此时可借助轻量工具库 charset_normalizer(requests 内置集成)或 chardet 抽取前 10KB 字节推断编码类型:
import io
import requests
import pandas as pd
from charset_normalizer import from_bytes

url = "https://example.com/api/dynamic_data.csv"
response = requests.get(url, timeout=15)
response.raise_for_status()
raw_bytes = response.content

# 探测前 10KB 数据的编码(避免大文件全量扫描降低性能)
sample_bytes = raw_bytes[:10240]
best_match = from_bytes(sample_bytes).best()
detected_encoding = best_match.encoding if best_match else "utf-8"

# 对探测到的编码进行兜底规整
if detected_encoding.lower() in ["gb2312", "gbk"]:
    detected_encoding = "gb18030"

df = pd.read_csv(io.BytesIO(raw_bytes), encoding=detected_encoding)
print(f"检测到编码: {detected_encoding},成功载入 {len(df)} 行数据")
四、避坑注意事项与验证清单
在调用
pd.read_csv() 时,有些网络教程会建议传入 encoding_errors='ignore'。该参数的作用是在遇到非法字节时直接丢弃这些字节。如果一个 GBK 编码的文件被强制使用 UTF-8 忽略解析,所有中文汉字都会被强行剔除,导致最终 DataFrame 成为残缺数据表,严重影响后续数据统计。
在很多实际生产场景中,数据表中如果出现人名生僻字(如“䶮”、“赟”、“珅”)或少数民族文字,GBK 编码解析时仍会抛出
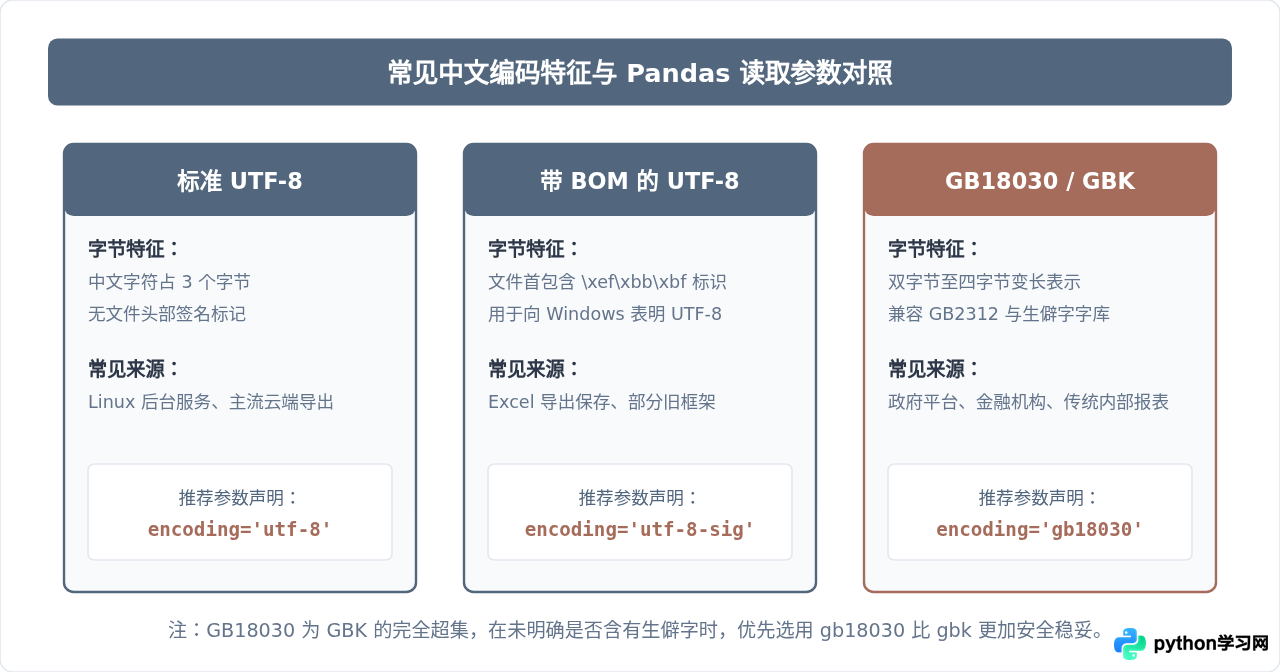
UnicodeDecodeError。因为 GB18030 强制收录了八万余个字符且完全向下兼容 GBK 与 GB2312,在处理非 UTF-8 的中文数据时,无脑填写 encoding='gb18030' 是成功率最高的选择。
完成数据载入后,请按照以下清单快速验证数据解析是否准确无误:
- 检查第一列列名:运行
print(df.columns.tolist()),观察首个列名是否干净。若发现形如\ufeff姓名,说明应当切为encoding='utf-8-sig'。 - 抽查字符串值:执行
print(df.select_dtypes(include='object').head()),肉眼确认中文字段是否存在问号、方框或拉丁重音符号。 - 校验行数完整度:对比
len(df)与远程文件的实际行数,确认是否因某些带换行的单元格或编码断点导致提前截断。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















