


Python Pandas DataFrame.head() 查看前几行数据用法
全面解析 Python Pandas 中 DataFrame.head() 方法的使用规则、核心参数、切片机制与开发实践,涵盖默认用法、指定行数、负整数参数及常见注意事项。
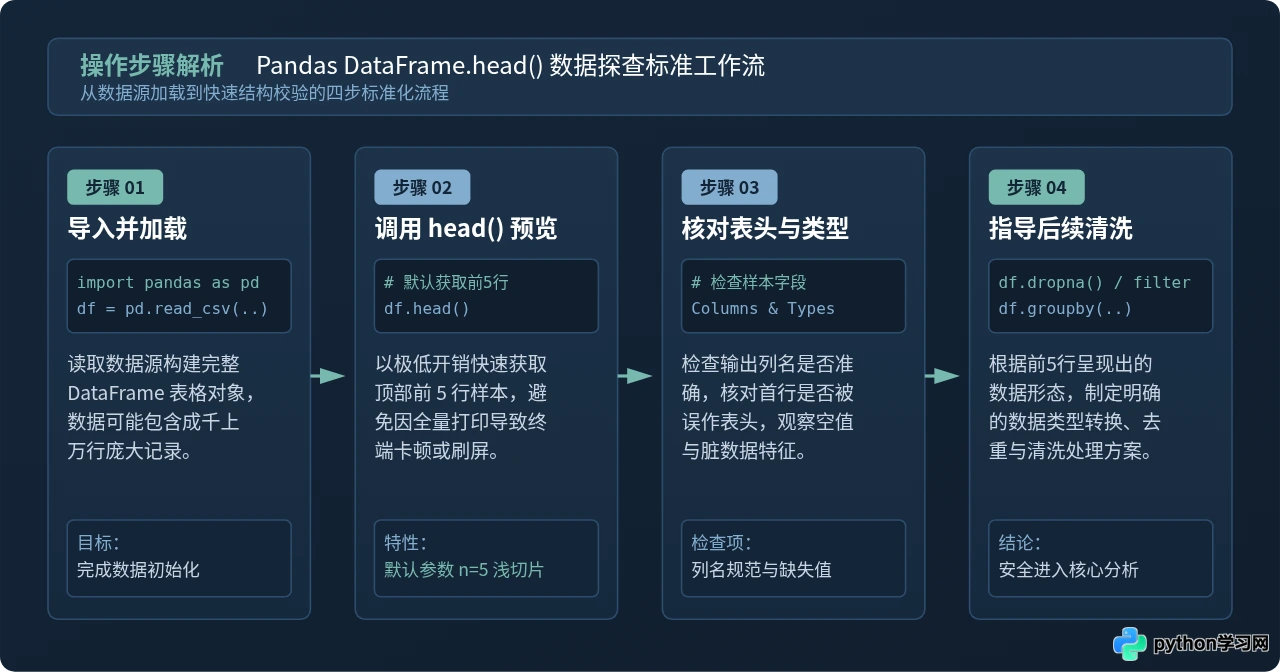
在日常数据分析和机器学习开发中,当我们通过 Pandas 读取外部 CSV 文件、数据库或接口返回的数据集时,原始表格往往包含成千上万行甚至数百万行数据。若直接在终端或交互式环境中打印整个 DataFrame 对象,不仅会占用大量屏幕空间造成内容刷屏,还可能因终端缓冲区渲染巨量文本而导致界面卡顿。Pandas 提供的 DataFrame.head() 方法正是解决这一痛点的基础工具,它能够以极低开销快速截取并呈现表格顶部的前几行数据,帮助开发者快速掌握字段命名、数据类型和整体样本形态。
一、DataFrame.head() 的核心语法与基本定义
head() 是 Pandas 库中 DataFrame 和 Series 对象内置的原生方法。该方法的设计意图是在不改变原始数据的前提下,返回当前对象的一个顶部切片子集。其官方函数签名非常简洁:
DataFrame.head(n=5)该方法只包含一个核心参数 n:
- 参数名称:
n - 参数类型:整数(
int),可为正整数、0 或负整数。 - 默认数值:
5(当不传入任何参数时,默认提取前 5 行)。 - 返回值类型:与调用主体相同类型的全新子集(返回一个新的
DataFrame或Series对象)。
二、快速上手:基础调用与参数指定步骤
为了演示 head() 的实际行为,我们构造一个包含 8 行员工信息的示例数据表。读者可以在本地 Python 3 环境下执行以下代码,观察不同传参形式的输出结果。
1. 默认参数调用(查看前 5 行)
在绝大多数排查场景中,我们直接调用无参数的 df.head(),Pandas 会自动返回前 5 行数据:
import pandas as pd

# 构建演示用 DataFrame
data = {
    '员工编号': ['E01', 'E02', 'E03', 'E04', 'E05', 'E06', 'E07', 'E08'],
    '姓名': ['张伟', '李强', '王芳', '刘洋', '陈敏', '杨帆', '赵磊', '周洁'],
    '部门': ['技术', '市场', '财务', '技术', '运营', '技术', '市场', '人事'],
    '薪资': [15000, 12000, 11000, 16500, 9500, 14000, 12500, 10500]
}
df = pd.DataFrame(data)

# 默认调用 head()
result_default = df.head()
print(result_default)
# 示例输出(Console Output 模拟示例):
员工编号 姓名 部门 薪资
0 E01 张伟 技术 15000
1 E02 李强 市场 12000
2 E03 王芳 财务 11000
3 E04 刘洋 技术 16500
4 E05 陈敏 运营 9500从输出中可以看出,返回的结果完整保留了原表格的列名(员工编号、姓名、部门、薪资)以及索引(0 至 4),仅对行数进行了精确截断。
2. 自定义指定行数(例如 n=3)
如果当前控制台宽度受限,或者我们只需要确认第一两条记录的格式规范,可以直接向 head() 传入指定的正整数:
# 指定仅查看前 3 行
result_three = df.head(3)
print(result_three)
# 示例输出(Console Output 模拟示例):
员工编号 姓名 部门 薪资
0 E01 张伟 技术 15000
1 E02 李强 市场 12000
2 E03 王芳 财务 11000三、深入理解:负整数参数与切片机制原理
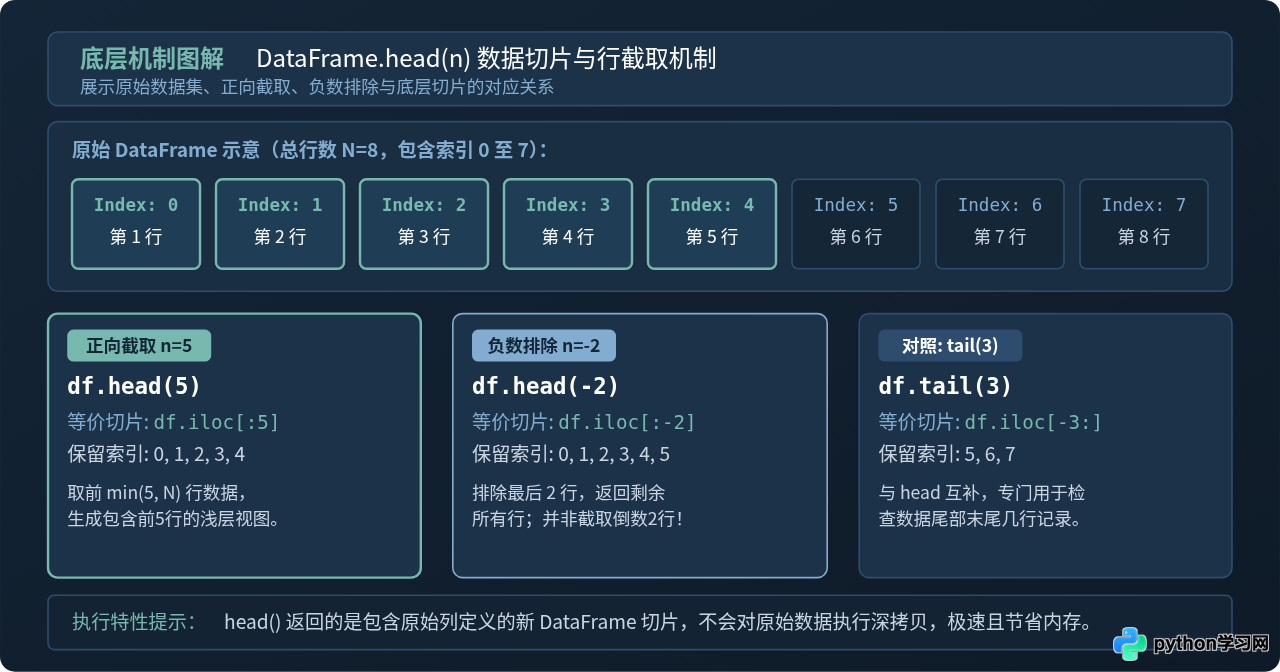
很多初学者误以为 head() 只能传入正整数,或者误认为传入负数(如 n=-2)会像 tail() 那样从后往前截取。在 Pandas 的内部实现中,head(n) 的参数逻辑完全映射了 Python 原生列表与序列的切片语法:df.iloc[:n]。
当 n 为负数时的运算规则
当传入负整数 -k 时,head(-k) 的实际含义是:“除最后 k 行之外,保留前面的所有数据”。例如,在包含 8 行的表格中执行 df.head(-2),将返回前 6 行(即第 1 行到第 6 行,排除末尾 2 行):
# 传入负数参数:排除最后 2 行
result_negative = df.head(-2)
print(result_negative)
# 示例输出(Console Output 模拟示例):
员工编号 姓名 部门 薪资
0 E01 张伟 技术 15000
1 E02 李强 市场 12000
2 E03 王芳 财务 11000
3 E04 刘洋 技术 16500
4 E05 陈敏 运营 9500
5 E06 杨帆 技术 14000df.head(-2) 或 df.head(-1) 可以非常优雅地剔除尾部非结构化干扰数据,而无需手动计算总行数。
四、常见应用场景与参数行为对比
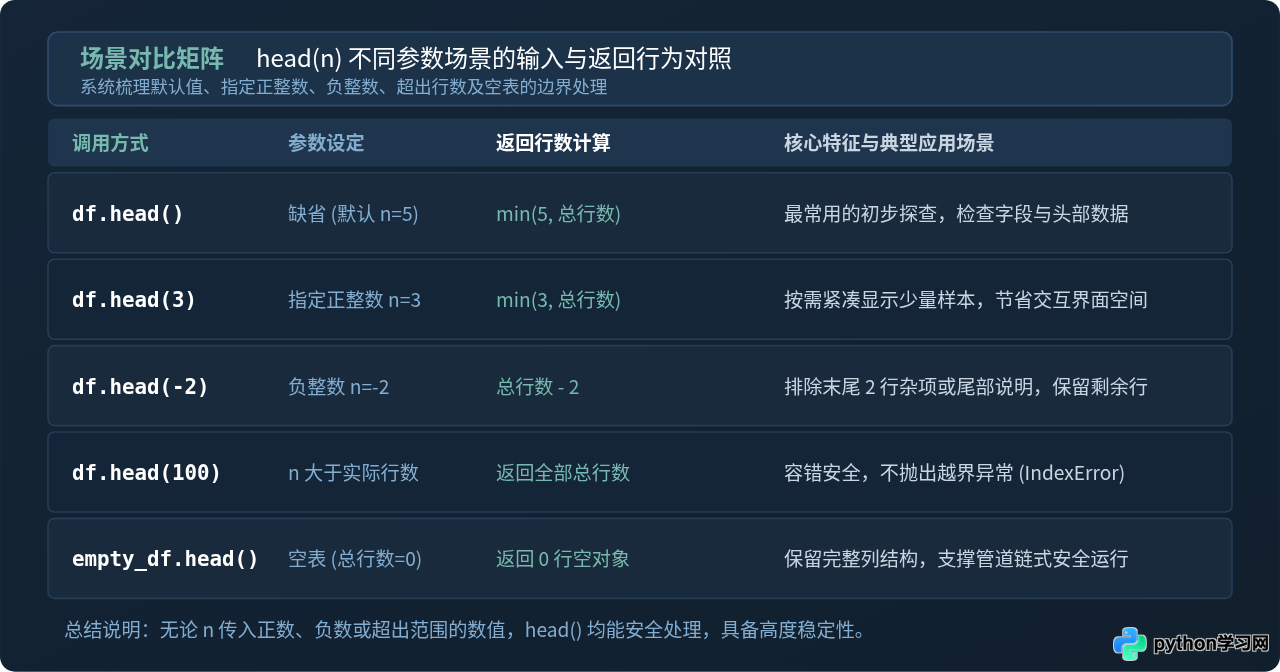
为了让读者在各种边界条件和异常输入下拥有明确预期,我们将 head(n) 在不同参数取值下的实际行为整理对比如下:
1. 当 n 大于总行数时的边界表现
如果当前数据表只有 8 行,而我们调用了 df.head(20),Pandas 不会抛出越界错误(IndexError),而是安全地返回当前表格的全部 8 行数据:
# 设定行数超过实际数据规模
result_overflow = df.head(50)
print(f"返回行数: {len(result_overflow)}")
# 示例输出(Console Output 模拟示例):
返回行数: 82. 在 Series 对象上的同等表现
除 DataFrame 外,从表格中提取出的单列 Series 对象同样具备完全一致的 head() 方法:
# 对单列 Series 执行 head()
salary_series = df['薪资'].head(3)
print(salary_series)
# 示例输出(Console Output 模拟示例):
0 15000
1 12000
2 11000
Name: 薪资, dtype: int64五、开发注意事项与常见避坑指南
虽然 DataFrame.head() 语义直观且易于上手,但在实际工程代码中,开发者仍需注意以下关键细节:
调用
df.head() 仅仅是返回一个新的数据切片,它绝不会改变变量 df 原本所包含的行数。如果你希望永久保留前 5 行并丢弃后续内容,必须显式重新赋值:df = df.head(5)
由
head() 返回的对象通常是原始底层数据的切片视图(View)。如果你直接对切片结果进行列修改,可能会触发 Pandas 的 SettingWithCopyWarning 警告。若需要对截取后的数据独立修改,建议显式调用 .copy():sample_df = df.head(5).copy()
除上述注意事项外,在探索性数据分析(EDA)中,也不要过度依赖 head():
- 排序偏差:数据源通常是按时间或自增主键排序的,只看
head()容易误以为全表数据都具有相同特征。建议结合df.tail()查看末尾,或使用df.sample(5)进行全表随机抽样。 - 性能开销:对于已经载入内存的 DataFrame,调用
head()仅涉及索引元数据切片,耗时通常在微秒级别,无需担心性能损耗。
六、总结与关键实践建议
DataFrame.head() 是数据分析流程中最核心的“前哨战”工具。它不仅帮助我们在交互式环境中安全预览样本,避免输出溢出,更在数据流水线构建、清洗规则验证以及排错排查中扮演着不可替代的角色。
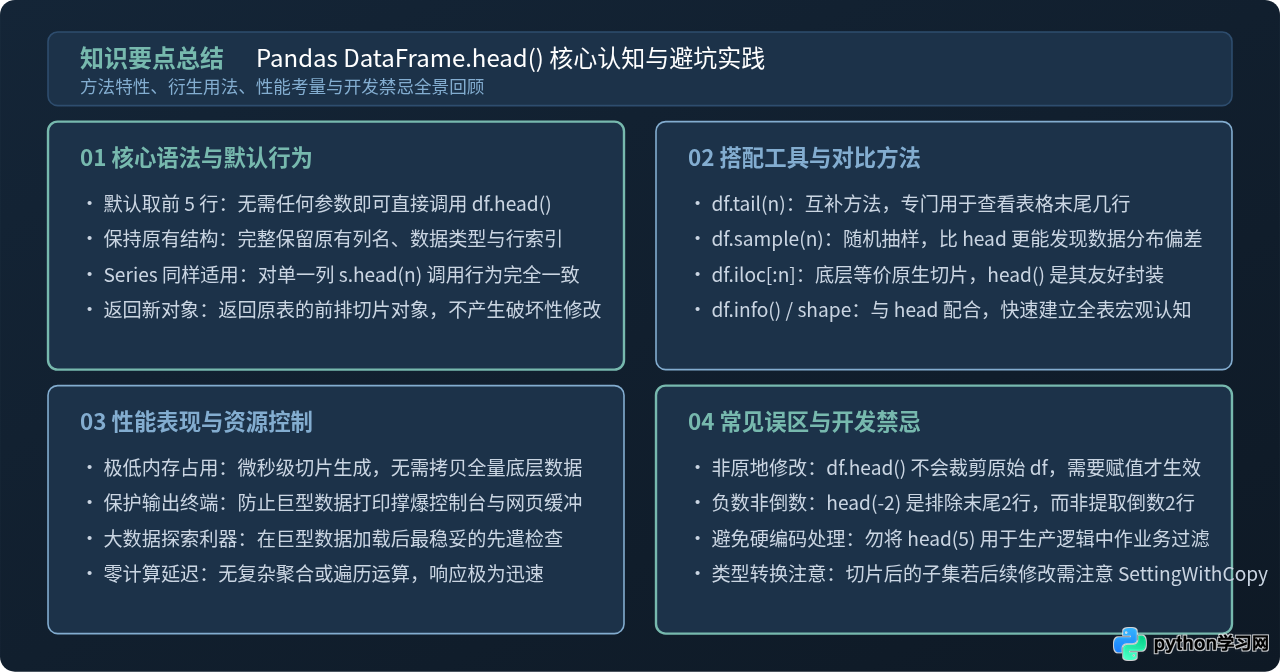
在编写实际业务脚本或进行数据探索时,建议将 df.head() 作为数据接入的第一道工序,结合 df.info() 查看数据类型、缺失值,以及结合 df.tail() 确认末尾行边界,从而构建严谨高效的数据处理流水线。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















