


Python遍历字典时修改内容导致RuntimeError怎么解决
深入解析在Python遍历字典过程中添加或删除键导致RuntimeError的原因,并提供使用list()快照、字典推导式、延迟删除列表及值更新等多种实用解决方案与代码示例。
for 循环直接遍历字典的过程中尝试增加或删除键时,解释器会立即抛出 RuntimeError: dictionary changed size during iteration。解决该问题最标准且可靠的做法,是在循环前为待遍历的键建立静态列表副本(如 list(dict.keys()) 或 list(dict)),或者使用字典推导式直接生成经过滤的新字典。
一、报错复现与典型场景
假设我们正在开发一个配置清理或用户数据过滤模块,需要剔除字典中所有状态为无效(或数值不合规)的键值对。很多初学者会自然写出如下代码:
# 示例代码:遍历字典时尝试删除键
user_scores = {
    "alice": 95,
    "bob": 58,
    "charlie": 82,
    "david": 45
}

# 遍历字典并尝试删除低于60分的键
for name, score in user_scores.items():
    if score < 60:
        del user_scores[name]
运行上述代码后,程序并没有按预期完成删除,而是会在第二次进入循环或删除发生时中断,并输出如下报错信息:
Traceback (most recent call last):
File "cleanup.py", line 10, in <module>
for name, score in user_scores.items():
RuntimeError: dictionary changed size during iteration
不仅是 del user_scores[name],包括调用 user_scores.pop(name) 或者在循环体内向字典添加新键 user_scores["new_key"] = val,只要改变了字典的键总数,都会立刻触发这一异常。
二、核心原理解析:为什么 Python 禁止遍历时改变字典大小?
理解这个报错背后的设计初衷,有助于我们在编写代码时避开潜在的并发与迭代陷阱。
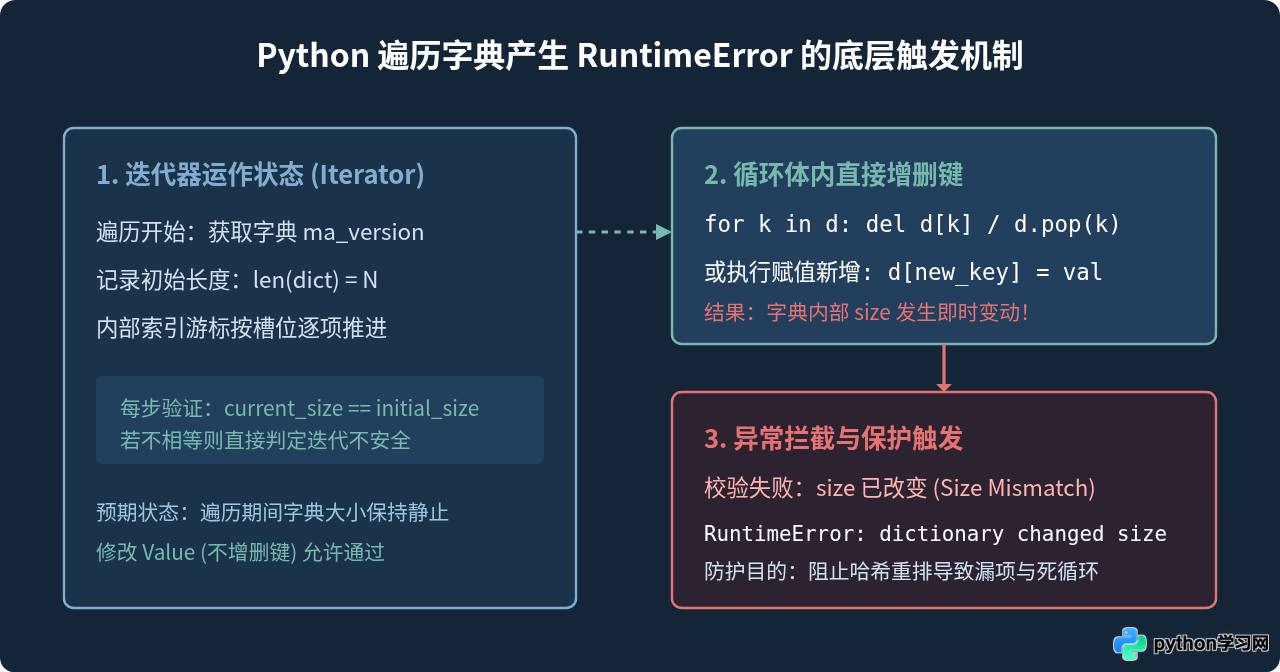
在 Python 底层实现中,字典是基于哈希表(Hash Table)构建的高效数据结构。自 Python 3.6 起,字典采用了更加节省内存的紧凑布局:内部维护了一个稀疏索引数组(indices)和一个连续存储键值对的实体数组(entries)。
当你创建一个字典迭代器(无论是通过 for k in dict、dict.keys() 还是 dict.items())时,迭代器内部维护了一个指向当前槽位的游标指针,以及该字典在迭代启动时的初始大小(以及内部版本号 ma_version_tag)。
如果在遍历过程中删除了某个键,实体数组可能会被压缩或标记为废弃(dummy);如果新增了键,当哈希表装载因子达到上限时,还会触发整个哈希表的重新分配(Resize / Rehash)。此时如果允许迭代器继续沿原游标前进,将极易导致以下严重问题:
- 元素遗漏:后续元素因位置重排向前移动,游标步进后将跳过原本尚未遍历的元素。
- 死循环或重复处理:新增的键被哈希分配到了游标之后的位置,导致刚刚插入的内容被再次遍历,甚至引发无线循环。
- 底层内存越界:重哈希后原有底层内存块可能已失效,盲目寻址会带来致命的内存错误。
因此,Python 的 C 语言底层在每次调用迭代器的 __next__ 方法时,都会严格比对当前字典大小是否与初始记录一致。一旦发现大小变动,立刻抛出 RuntimeError 快速失败(Fail-Fast)。
user_scores[name] = score + 5,字典的大小保持不变,这种情况是完全安全且合法的,不会抛出任何异常。
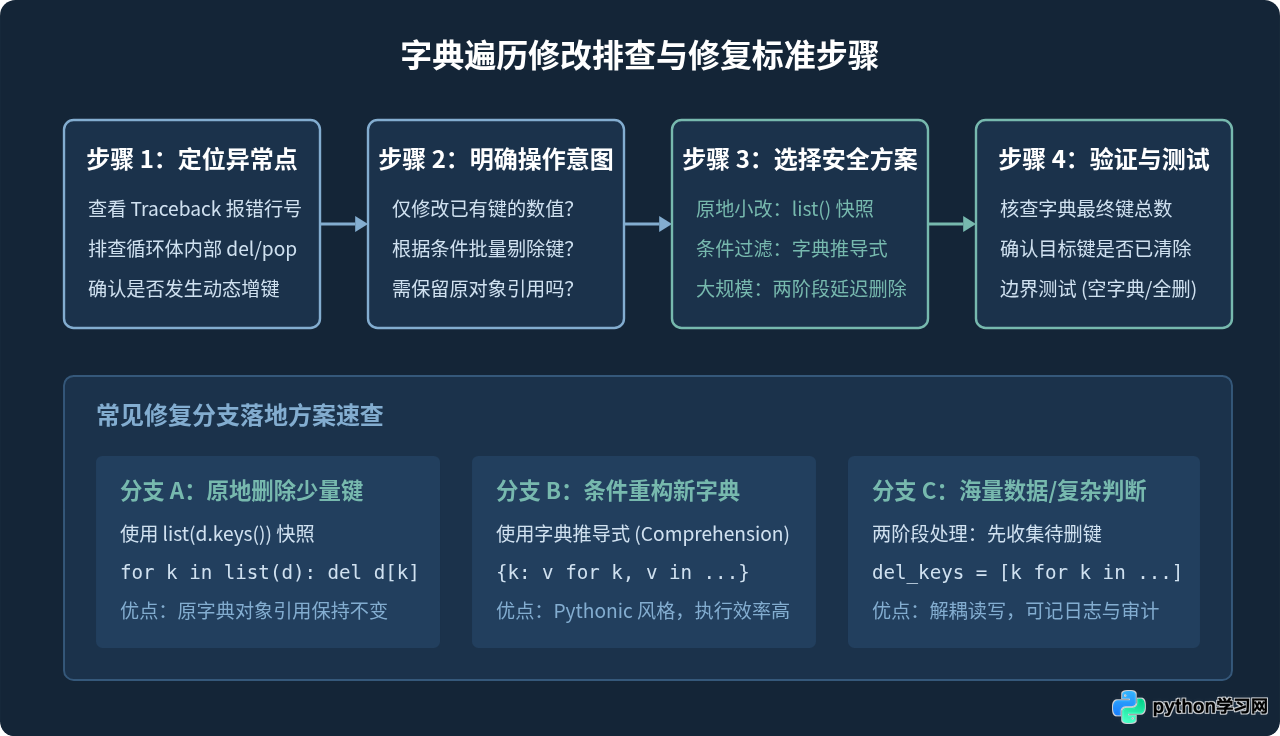
三、排查与修复标准步骤
遇到该报错时,可以按照以下清晰的步骤进行诊断与修复:
四、解决该报错的四种实用方案
方案 1:使用 list() 创建静态键快照(推荐度高)
这是最直接、最符合直觉的改写方式。我们不再直接迭代动态的字典视图(如 dict.keys()),而是通过内置函数 list() 将所有键提取出来,生成一个完全独立的列表。由于列表的生命周期已与字典脱钩,在后续循环中对字典执行删除或新增,不会影响正在遍历的列表。
# 解决方案 1:使用 list() 快照迭代
user_scores = {
    "alice": 95,
    "bob": 58,
    "charlie": 82,
    "david": 45
}

# 通过 list(user_scores.keys()) 或简写 list(user_scores) 创建快照
for name in list(user_scores.keys()):
    if user_scores[name] < 60:
        del user_scores[name]

print("清理后的字典:", user_scores)
# 示例输出:清理后的字典: {'alice': 95, 'charlie': 82}
适用场景:需要在原字典上进行修改(例如该字典被其他变量所引用),且字典规模适中。
方案 2:使用字典推导式生成新字典(最 Pythonic)
如果业务逻辑本质上是“根据条件保留符合要求的项”,那么直接使用字典推导式重新生成一个过滤后的字典,通常是性能最高且代码最为清晰的方案。
# 解决方案 2:使用字典推导式进行条件筛选
user_scores = {
    "alice": 95,
    "bob": 58,
    "charlie": 82,
    "david": 45
}

# 仅保留大于等于 60 分的数据
filtered_scores = {name: score for name, score in user_scores.items() if score >= 60}

print("过滤后的字典:", filtered_scores)
# 示例输出:过滤后的字典: {'alice': 95, 'charlie': 82}
如果函数外部持有了
user_scores 的引用,直接执行 user_scores = {...} 只是改变了局部变量指向,外部变量仍然指向旧对象。若要既享受推导式的高效,又保持原地更新,可以结合 clear() 与 update():
user_scores.clear()
user_scores.update({name: score for name, score in backup.items() if score >= 60})
方案 3:两阶段延迟删除(适用于大字典与复杂逻辑)
当字典体量非常庞大(例如数十万到数百万条记录),而实际需要删除的记录只有极少数时,直接对全量键执行 list(dict) 会瞬间占用较多内存。此时可以采用“两阶段法”:第一阶段只遍历、不修改,把符合删除条件的键记录在一个小列表或集合中;第二阶段统一遍历该小集合执行删除。
# 解决方案 3:两阶段延迟删除
large_data = {
    f"user_{i}": i for i in range(100000)
}

# 第一阶段:只遍历,收集符合条件的键
keys_to_remove = []
for key, val in large_data.items():
    if val % 20000 == 0:  # 假设只有极少数键需要剔除
        keys_to_remove.append(key)

# 第二阶段:遍历待删除键列表,安全执行删除
for key in keys_to_remove:
    del large_data[key]

print(f"已成功删除 {len(keys_to_remove)} 个键,剩余 {len(large_data)} 项")
# 示例输出:已成功删除 5 个键,剩余 99995 项
方案 4:仅需更新 Value 时的就地修改
很多开发者在遇到此报错后产生心理误区,以为遍历字典时不能做任何修改。实际上,只要不改变键的数量,修改对应键的值是完全允许且零内存开销的。
# 解决方案 4:纯 Value 修改(无需使用任何列表拷贝)
user_scores = {
    "alice": 95,
    "bob": 58,
    "charlie": 82
}

# 给不及格的分数统一加 5 分补偿分(安全执行)
for name in user_scores:
    if user_scores[name] < 60:
        user_scores[name] += 5

print("调整后的分数:", user_scores)
# 示例输出:调整后的分数: {'alice': 95, 'bob': 63, 'charlie': 82}
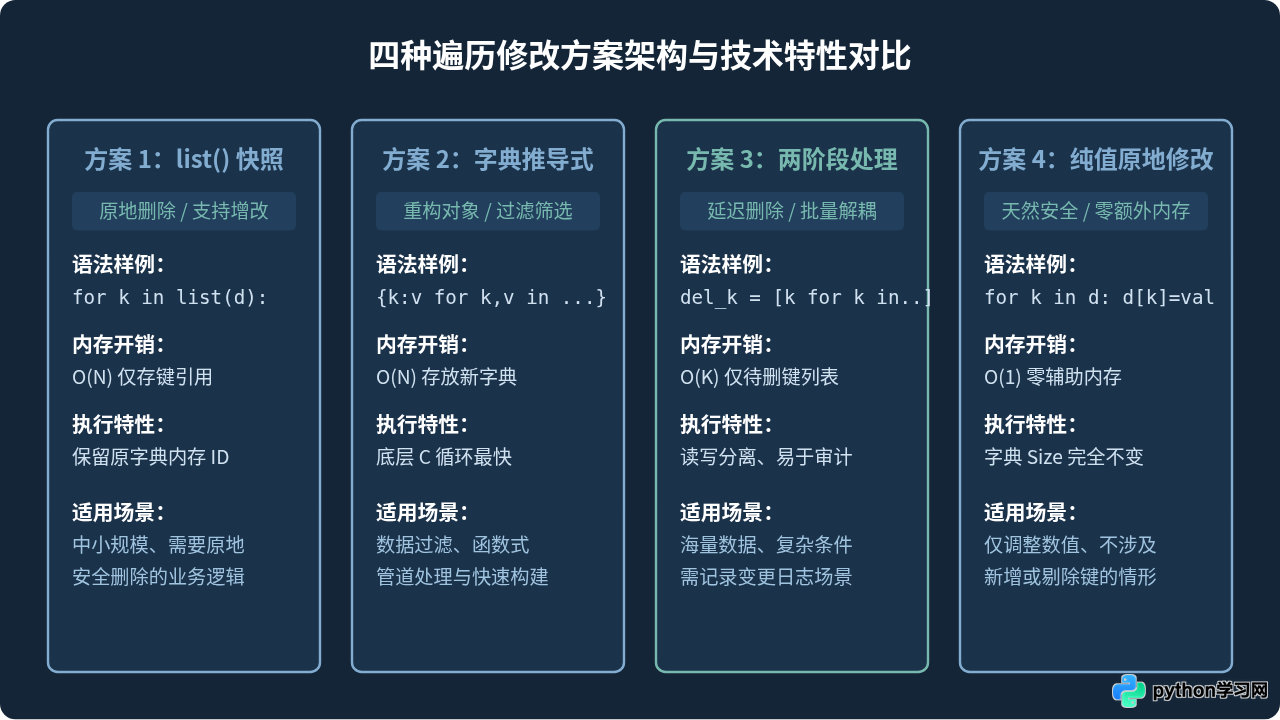
五、各方案横向对比与选型依据
为了在实际工程中做出合理的架构权衡,下表总结了各处理方式的核心指标:
| 方案名称 | 核心语法形式 | 空间复杂度 | 是否原地修改 | 最适合业务场景 |
|---|---|---|---|---|
| list() 快照迭代 | for k in list(d): |
O(N) 仅键引用 | 是(保留原对象) | 字典大小在数万级以内,逻辑简单直接 |
| 字典推导式 | {k: v for k, v in ...} |
O(N) 新字典 | 否(生成新对象) | 纯过滤筛选,偏好函数式与可读性代码 |
| 两阶段收集 | del_keys = [...] |
O(K) 仅待删项 | 是(保留原对象) | 海量字典(百万级),待删键仅占少数 |
| 就地更新 Value | for k in d: d[k] = ... |
O(1) 零开销 | 是(保留原对象) | 业务仅修改值,绝不增加或减少键 |
六、高频边界与避坑提醒
1. 为什么不能直接使用 for k in d.keys(): 解决?
在 Python 2 中,d.keys() 返回的是一个真实的独立 list,因此在 Python 2 时代很多代码能够侥幸运行;但自 Python 3 起,d.keys()、d.values() 和 d.items() 返回的都是动态视图对象(dict_keys、dict_items)。视图对象直接映射字典底层,并未复制数据,因此必须显式用 list() 将其转换为静态列表。
2. 多层嵌套字典的递归修改
处理树状或嵌套字典时,若需要在递归中删除深层键,外层字典的遍历可能不受影响,但正在被处理的那一层字典依然受制于该规则。确保每一层递归执行删除前,该层循环都使用 list() 保护当前层级的键视图。
3. 多线程并发修改风险
即使在当前线程中没有在循环体内写 del,如果其他线程在并发向该字典执行 d[new_key] = val,遍历线程依然会在下一轮检测时抛出 RuntimeError。对于多线程共享字典,必须加互斥锁(threading.Lock)保护,或者在进入循环前对字典执行浅拷贝 d.copy()。
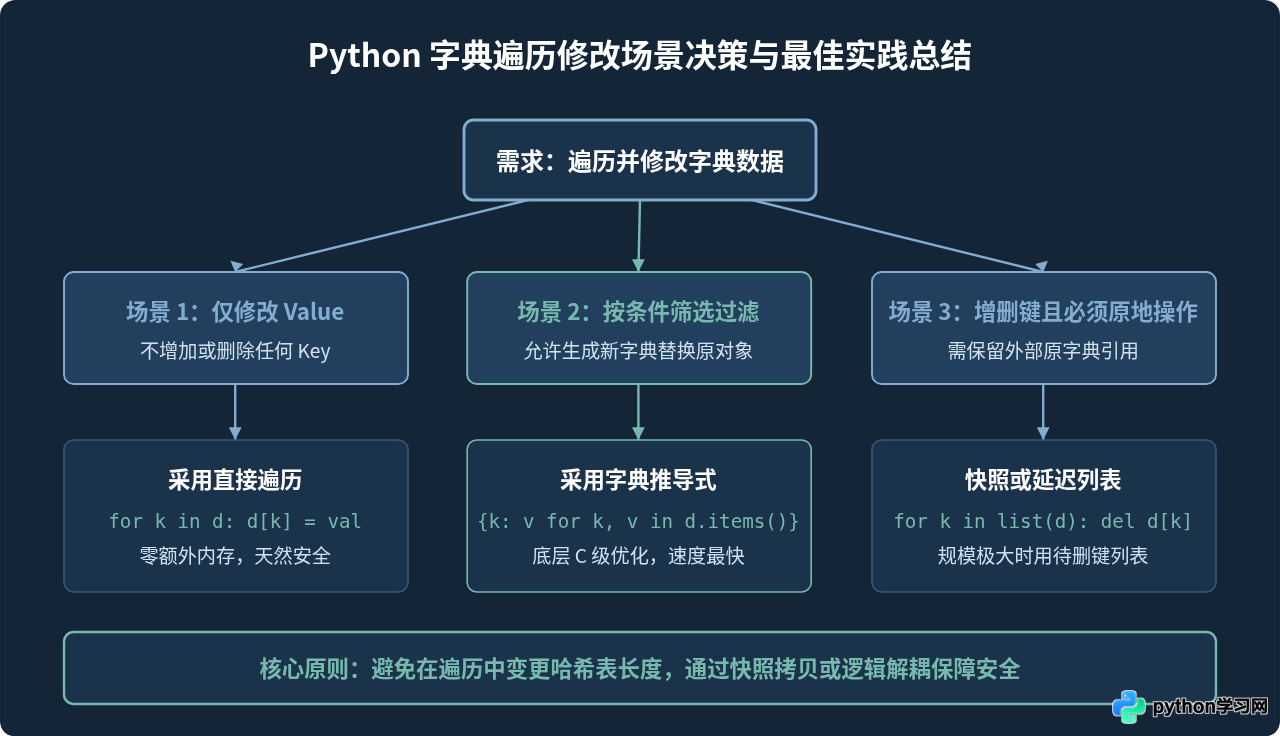
七、总结
RuntimeError: dictionary changed size during iteration 是 Python 语言在哈希表遍历安全机制上的积极防御措施。解决它的核心思路非常纯粹:将“读取与遍历”同“结构的增删修改”在物理上隔离开来。
在日常编码实践中:
- 如果只是做数据的过滤与清洗,优先使用字典推导式,优雅简洁且性能优异;
- 如果需要在现有数据结构上原地剔除或修改键,使用
list(dict)建立临时键快照是最快捷可靠的修复方式; - 在面对海量数据时,采用两阶段延迟删除能够显著控制额外内存开销;
- 如果仅是改写键对应的数值,则无需做任何包裹,直接遍历原字典赋值即可。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















