


Python怎么遍历字典:keys、values和items的使用区别
全面解析Python遍历字典的四种核心方式:直接遍历、keys()、values()与items()的使用方法、底层机制差异、集合操作与动态视图特性,并提供遍历修改字典的安全避坑指南。
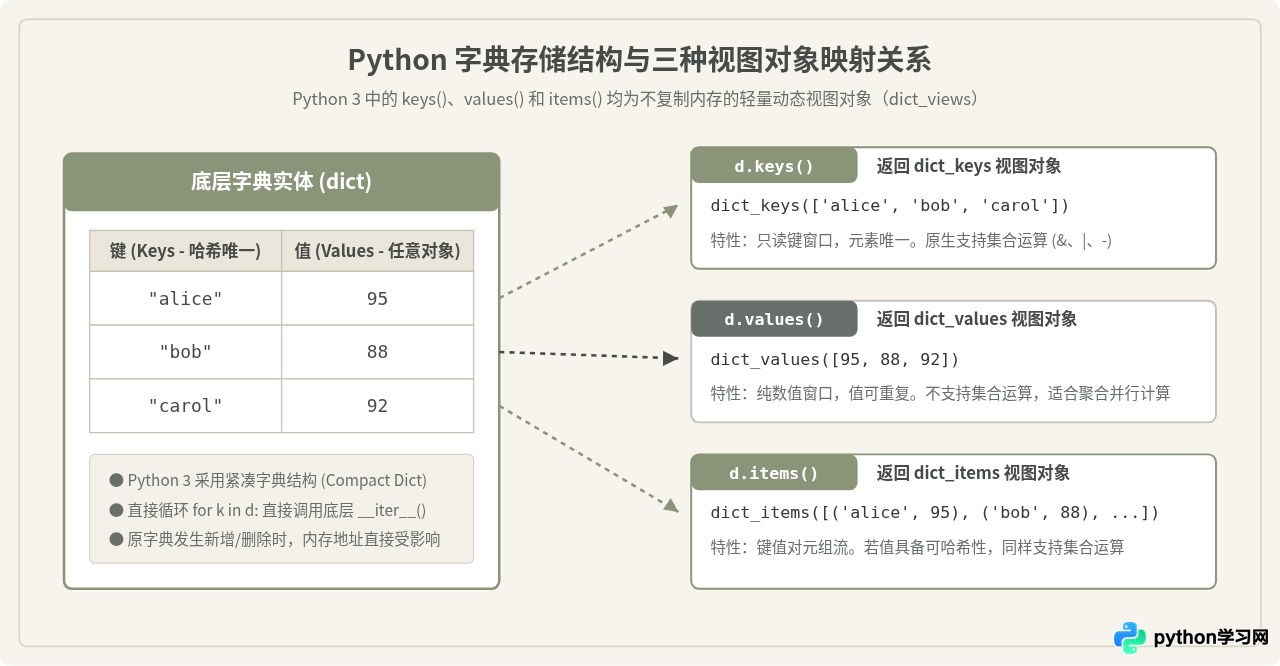
在 Python 中遍历字典,核心方式共有四种:直接对字典对象迭代、使用 keys()、使用 values() 以及使用 items()。直接遍历和 keys() 用于读取字典的键,values() 用于读取所有的值,而 items() 则用于同时获取键和值组成的键值对。在 Python 3 中,后三者返回的不是独立的列表副本,而是与原字典动态绑定的“视图对象”(View Objects),具有极高的内存效率与实时的动态特性。掌握这三者的适用边界与底层区别,是写出优雅、高效且健壮的 Python 代码的基础。
一、四种字典遍历方式的具体用法与代码示例
在实际编码中,很多开发者习惯在所有场合都调用 .keys() 或只依赖 .items()。根据任务需要选择语义最明确的方法,不仅能提升可读性,还能避免不必要的数据查找开销。我们以一个记录用户成绩的字典 scores = {"alice": 95, "bob": 88, "carol": 92} 为例逐一演示。
1. 直接遍历字典:获取键名(推荐方式)
字典本身就是一个可迭代对象。直接将其传入 for 循环时,Python 会调用字典的默认迭代器,按顺序依次产出键(Key)。
scores = {"alice": 95, "bob": 88, "carol": 92}

for student in scores:
print(student)alice
bob
carol
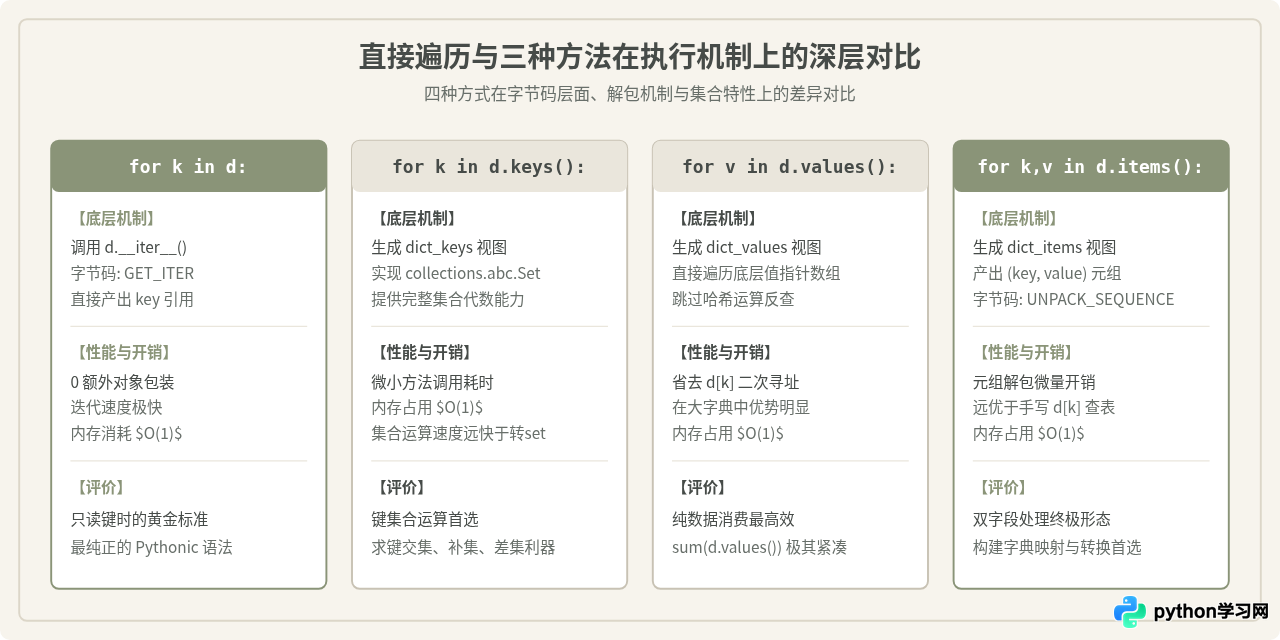
直接遍历字典是最地道(Pythonic)的写法。它的语法最干净,没有任何额外的方法调用开销。当你的循环逻辑中只需要使用键名时,直接遍历字典是首选。
2. 使用 dict.keys() 遍历:显式获取键视图
调用 scores.keys() 返回一个 dict_keys 对象。在循环中迭代该对象,产出的内容与直接遍历字典完全相同。
for student in scores.keys():
    print(student)
虽然产出相同,但显式调用 keys() 会多一次属性查找与方法调用的过程。日常普通键遍历通常不需要写 .keys();但如果需要体现与 .values() 对称的明确意图,或者需要进行集合运算时,keys() 会发挥特殊作用。
3. 使用 dict.values() 遍历:仅获取数值
如果业务逻辑只需要字典中的数值(例如统计总分、计算平均数、提取有效配置),使用 values() 是最直接的方式,不需要先取出键再去字典中通过 scores[k] 反查。
for score in scores.values():
print(score)95
88
92
很多初学者会写出 for k in scores: score = scores[k] 这样的代码。如果循环体内完全不使用 k,那么通过哈希查找 scores[k] 属于多余的计算开销。直接使用 scores.values() 能从底层连续读取存储区中的值,代码更加轻快。
4. 使用 dict.items() 遍历:同时获取键和值
当业务处理中既需要键又需要对应的值时,items() 是唯一的正确选择。它在每次循环迭代时产出一个形如 (key, value) 的双元素元组,结合 Python 的多变量解包特性,可以直接分别赋予对应的变量名。
for student, score in scores.items():
print(f"学生: {student}, 成绩: {score}")学生: alice, 成绩: 95
学生: bob, 成绩: 88
学生: carol, 成绩: 92
使用 for student, score in scores.items(): 避免了写成 scores[student]。这不仅减少了二次哈希寻址,而且让代码语意极为凝练。
二、认知辨析:既然直接遍历就是键,为什么还需要 keys()?
很多 Python 学习者会产生一个常见疑问:“既然 for k in d 已经能拿到所有的键,那 d.keys() 岂不是多余的设计?”
这个说法看似有道理,但只在“纯粹使用 for 循环做顺序迭代”这一单一场景下成立。在以下两个关键场景中,显式使用 keys() 具有不可替代的作用:
1. 集合运算(Set Operations)
在 Python 3 中,dict_keys 和 dict_items 实现了 collections.abc.Set 抽象基类的接口。这意味着 keys() 返回的对象本质上具备集合特性,可以直接与其他集合或字典键视图执行交集、并集和差集运算,无需手动将字典转为 set():
dict_a = {"苹果": 10, "香蕉": 20, "橙子": 15}
dict_b = {"香蕉": 25, "西瓜": 30, "橙子": 18}

# 1. 查找两个字典共有的键(交集 &)
common_keys = dict_a.keys() & dict_b.keys()
print(common_keys)  # {'香蕉', '橙子'}

# 2. 查找只在 dict_a 中存在的键(差集 -)
only_a_keys = dict_a.keys() - dict_b.keys()
print(only_a_keys)  # {'苹果'}
如果直接写 dict_a & dict_b,Python 解释器会抛出 TypeError: unsupported operand type(s) for &: 'dict' and 'dict'。字典对象本身并不支持位与/交集操作,只有通过 .keys() 暴露出来的键视图才具备集合运算能力。
2. 代码自解释性与 API 契约
当函数设计需要返回对象的所有键名,或者与 .values() 并列展示对比时,return d.keys() 能够明确传达“这里只对外提供只读的键集合”这一契约意图,让代码的自解释性更高。
三、字典遍历方式的选型决策流程
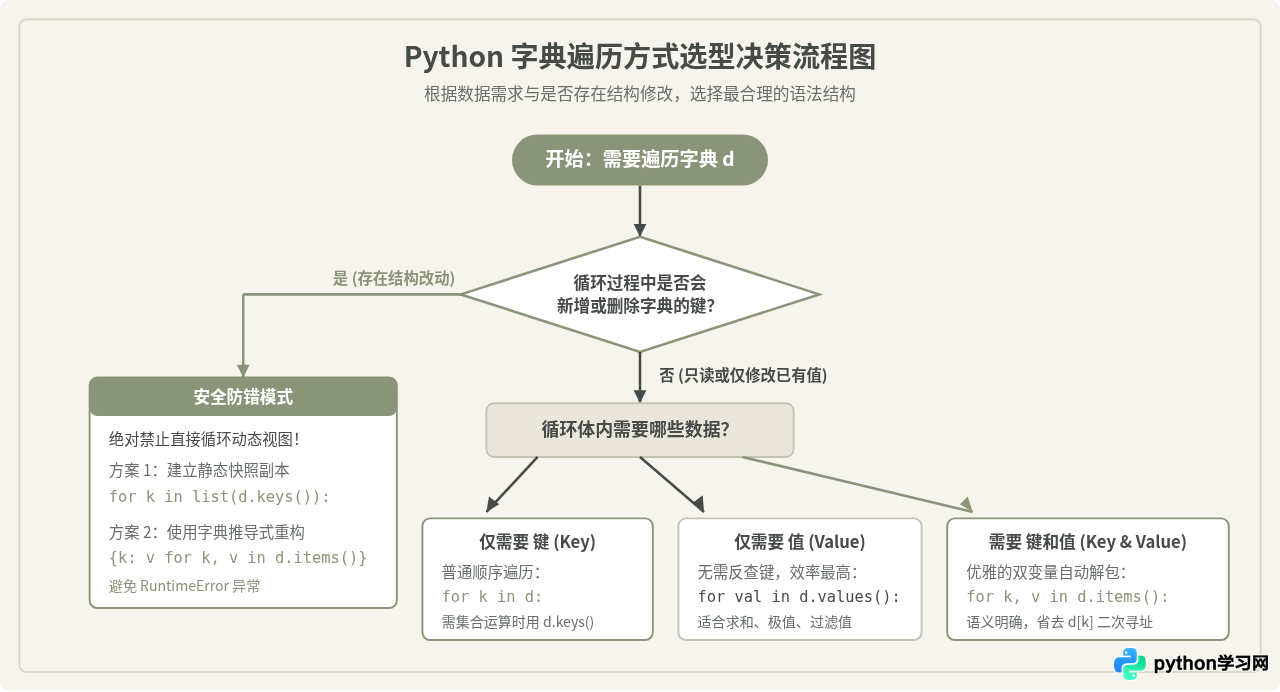
在实际工程开发中,面对一个字典变量,究竟应该选择哪一种遍历方式?我们可以通过下面的结构化决策路径来快速判定:
四、底层原理与多维度差异对比
在 Python 2 时代,keys()、values()、items() 会在内存中一次性分配并返回一个崭新的完整列表(当时的惰性版本为 iterkeys()、itervalues()、iteritems())。
在 Python 3 中,旧式的列表构建被完全废弃,keys()、values() 和 items() 统一返回轻量级视图对象(dict_keys、dict_values、dict_items)。视图对象不复制数据,其大小始终为常量级别($O(1)$ 内存占用),并且能够实时感知原字典的状态。
1. 动态视图(Dynamic Views)特性验证
什么是“动态感知”?看下面这组代码:
user_roles = {"admin": "张三", "editor": "李四"}

# 获取键视图与值视图
k_view = user_roles.keys()
v_view = user_roles.values()

# 修改原字典:新增一个键值对
user_roles["viewer"] = "王五"

# 视图自动同步反映变化,无需重新调用 .keys() 或 .values()
print(k_view)  # dict_keys(['admin', 'editor', 'viewer'])
print(v_view)  # dict_values(['张三', '李四', '王五'])
视图对象就像是在底层字典上方放置的一面滤镜窗口,它不保存具体的键值列表,而是直接读取原字典的指针与长度。因此无论原字典多大,创建视图对象的耗时和内存消耗都可以忽略不计。
2. 四种遍历方式的核心特性横向对比
| 遍历方式 | 返回/产出内容 | 内存空间复杂度 | 是否支持集合运算 | 最佳适用场景 |
|---|---|---|---|---|
直接遍历 for k in d: |
直接产出 key |
$O(1)$ 常量 | 否(字典对象本身) | 仅按键读取、最简洁优雅的基础遍历 |
d.keys() |
dict_keys 视图 |
$O(1)$ 常量 | 是(支持交/并/差集) | 需要对键做集合运算、对外提供只读键接口 |
d.values() |
dict_values 视图 |
$O(1)$ 常量 | 否(值允许重复) | 仅需读取值进行统计、聚合或验证 |
d.items() |
dict_items 视图,每项为 (k, v) 元组 |
$O(1)$ 常量 | 若值可哈希则支持 | 同时需要使用键和值、格式化输出、字典重构 |
五、高频踩坑:遍历时修改字典为什么会报错?
在所有与字典遍历相关的错误中,发生率最高的是在循环体内对原字典进行增删操作:
data = {"a": 1, "b": 2, "c": 3}

# 错误演示:遍历过程中删除键
for k in data:
    if data[k] == 2:
del data[k] # 抛出 RuntimeError!RuntimeError: dictionary changed size during iteration
1. 报错背后的根本原因
Python 字典内部维护着一个名为 ma_version_tag 的全局版本计数器。当一个字典开始被迭代时,迭代器会记录当下的版本号。如果循环体内发生了 del data[k] 或 data['new'] = 4 等改变字典尺寸的操作,底层哈希表的桶布局可能发生重排(Resize/Rehash),版本计数器也会随之自增。
当迭代器进入下一步循环时,比对版本号发现不一致,为了防止由于哈希重排导致元素重复访问或漏读,Python 会立即主动抛出 RuntimeError 进行快速失败(Fail-Fast)。
2. 注意:“修改值”是安全的,“改动键”才会报错
需要明确区分的是:只有影响字典键集合大小的增删操作才会引发此异常。如果在遍历中只是修改已有键对应的数值,字典的容量和哈希结构并没有变化,这是完全合法的:
# 安全操作:就地修改键对应的数值
for k in data:
    data[k] = data[k] * 10  # 完全合法,不会报错
3. 安全删除或过滤键的正确实践
如果业务确实需要在遍历逻辑中剔除某些键,有以下两种安全可靠的模式:
做法 A:转为静态列表副本(推荐用于原地删除少量键)
# 通过 list() 将 keys 固化为静态列表快照,脱离与原字典的动态迭代器绑定
for k in list(data.keys()):
    if data[k] % 2 == 0:
        del data[k]
做法 B:字典推导式(推荐用于过滤生成新结果)
# 不原地修改原字典,直接生成符合条件的新字典
filtered_data = {k: v for k, v in data.items() if v % 2 != 0}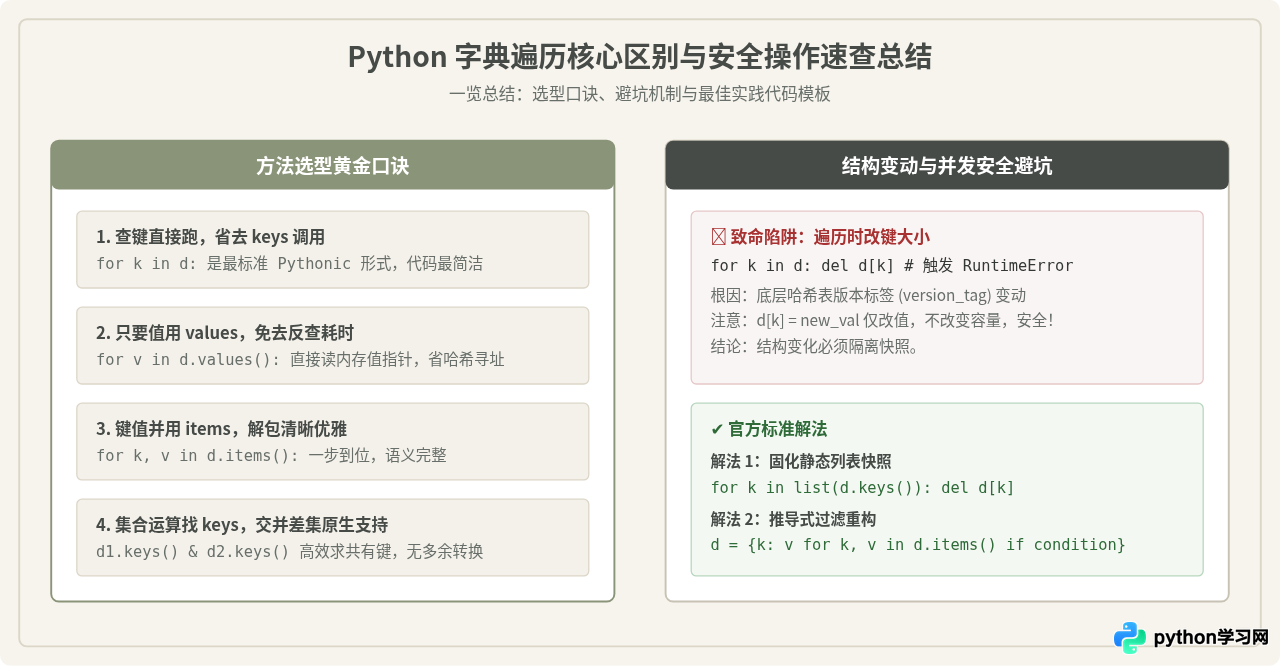
六、总结与实践建议
综上所述,Python 字典的遍历并非单一的代码形式,而是根据实际场景有着清晰的分工:
- 只读取键名:直接书写
for k in d:,保持代码纯粹自然; - 需要交集、并集或差集运算:使用
d.keys()发挥视图对象的集合能力; - 只统计或提取数值:使用
for v in d.values():,跳过哈希查表,性能最优; - 键值协同处理:使用
for k, v in d.items():自动解包,兼顾性能与清晰语意; - 涉及增删键操作:务必使用
list(d.keys())剥离动态绑定,或采用推导式生成全新字典。
理解这四种遍历方式背后的视图机制与数据流动,能够帮助你在日常编码中写出更加严谨、高效且自解释的 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















