


Python字符串拼接:str.join()方法的语法与常见误区
深入解析Python中str.join()字符串拼接方法的语法规则、内存底层运作原理,系统总结开发中常见的TypeError、调用对象混淆等误区及高效解决方案。
str.join() 是官方推荐的标准做法。它通过预先计算总长度实现一次性内存申请,避免了连续 + 操作频繁开辟内存所带来的性能损耗。然而,其反直觉的“分隔符主导”调用语法以及对序列元素类型的强制要求,常让初学者甚至经验丰富的工程师产生混淆。本文将系统拆解 str.join() 的语法逻辑、运行机制,并剖析高频出现的开发误区与规避方案。
一、str.join() 的基本语法与运行逻辑
初学 Python 时,很多人的直觉是“对一个列表执行拼接方法”,例如写出类似 list.join(',') 的语句。但在 Python 标准库设计中,join() 并不是列表(list)或元组(tuple)的方法,而是字符串(str)实例的方法。
其标准语法结构如下:
separator.join(iterable)这里包含两个核心要素:
- 分隔符(separator):负责发起调用的字符串对象。它将插入到序列中每两个相邻元素之间。如果不需要间隔,可以使用空字符串
"".join(...)。 - 待拼接序列(iterable):作为参数传入的可迭代对象,例如
list、tuple、set或生成器。序列中的每一个元素都必须是字符串类型。
看一个标准的执行范例:
languages = ["Python", "Java", "Go", "Rust"]
result = ", ".join(languages)

# 示例输出
# result -> "Python, Java, Go, Rust"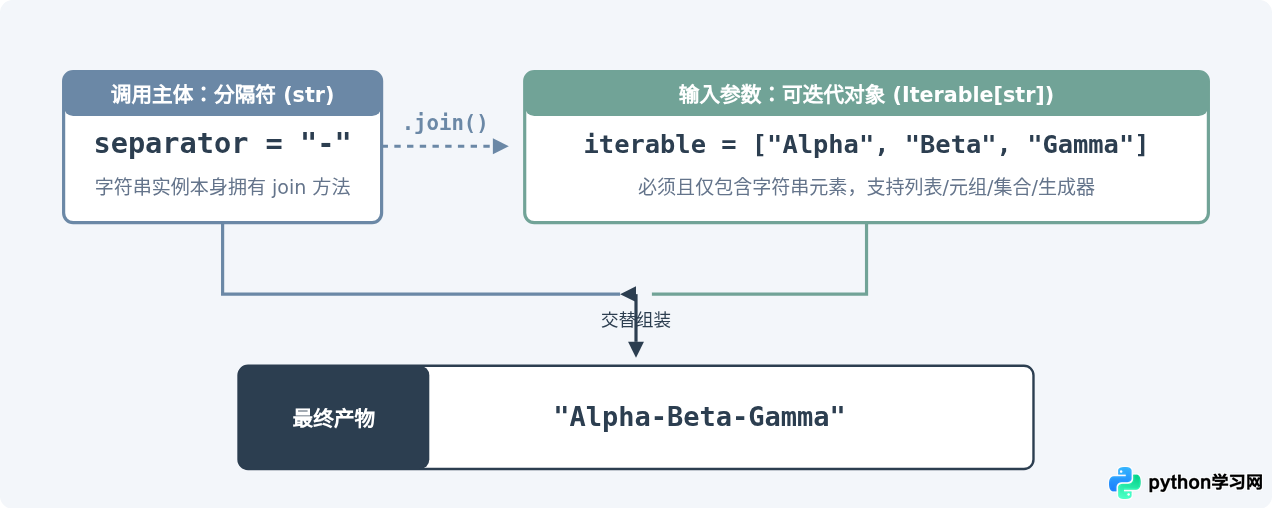
二、底层机制:为什么 join() 优于“+”操作符拼接?
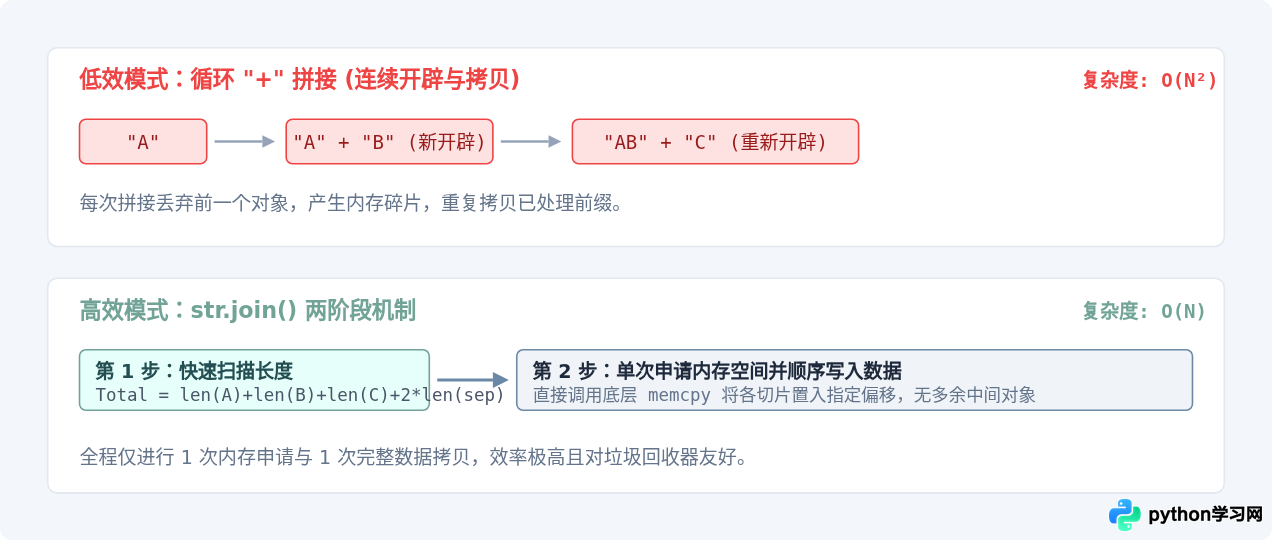
在 Python 中,字符串是不可变对象(Immutable)。一旦创建,其在内存中的内容和长度便不可修改。这意味着,如果在一个循环中不断使用 s += item:
- 每一次
+操作,Python 都必须在内存中分配一块全新的空间; - 将原有字符串的内容完整拷贝到新空间中;
- 将新追加的字符拷贝到末尾;
- 旧的字符串对象失去引用,等待垃圾回收(GC)。
当拼接 \(N\) 个字符串时,总共需要进行约 \(O(N^2)\) 次字符拷贝操作。随着序列变长,执行时间将急剧攀升。
而 str.join() 采用了完全不同的两阶段构建策略:
- 第一阶段(预扫描长度):遍历一次输入的可迭代对象,提取所有子字符串的长度,并加上所需分隔符的总长度,精确计算出最终字符串所需的绝对字节大小;
- 第二阶段(单次内存分配与填充):向底层内存管理器一次性申请对应大小的内存块,随后通过底层 C 语言层级的内存拷贝指令(如
memcpy),将元素与分隔符直接填入对应内存偏移位置。
这一机制确保了时间复杂度保持在严格的 \(O(N)\),无论是在处理数万行日志拼接还是大型文本生成时,性能都极为稳健。
三、常见误区与避坑指南
在实际编码中,围绕 str.join() 出现的异常往往集中在参数类型与语法习惯上。以下是 5 个最典型的误区与对应解法。
误区 1:颠倒主体与参数(AttributeError)
受到其他编程语言(如 JavaScript 中的 Array.prototype.join())的影响,开发者常常习惯性地以数组为主体进行调用:
items = ["apple", "banana", "cherry"]

# 错误写法:在列表上直接调用 join
result = items.join(",")
# 抛出异常: AttributeError: 'list' object has no attribute 'join'join() 被收口在 str 类型下。正确写法:始终用预期的分隔符来调用,即
",".join(items)。
误区 2:可迭代对象中包含非字符串类型(TypeError)
join() 对参数集合内的元素类型非常严格,不会自动隐式调用 str()。只要存在非字符串元素(如整数、浮点数、None、布尔值或字典),就会立即抛出 TypeError。
numbers = [101, 202, 303]

# 错误写法:直接拼接非字符串列表
result = "-".join(numbers)
# 抛出异常: TypeError: sequence item 0: expected str instance, int found
解决该问题有两种通用做法:
- 使用生成器表达式转换(推荐用于大序列):
result = "-".join(str(num) for num in numbers) - 使用内置函数 map 映射转换:
result = "-".join(map(str, numbers))
误区 3:对字典直接调用 join 导致的“键拼接”困惑
当开发者将字典传入 join() 时,由于字典默认的迭代行为是遍历其键(keys),最终结果往往出乎意料:
user_info = {"name": "Alice", "role": "admin", "city": "Beijing"}

# 本意可能想拼接值,但直接传入字典:
result = " | ".join(user_info)
# 输出: "name | role | city" (只拼接了键)避坑准则:明确指明要拼接的部分。若拼接值,请显式使用 user_info.values();若拼接键值对,建议使用推导式组合:
# 拼接键值对
result = "; ".join(f"{k}={v}" for k, v in user_info.items())
# 输出: "name=Alice; role=admin; city=Beijing"
误区 4:边界情况的非预期表现(空列表与单元素)
在处理空序列或单元素序列时,初学者有时会担心是否会出现多余的分隔符。需要明确其既定规则:
- 空序列:
",".join([])会直接返回空字符串"",不会抛错,也不会包含分隔符。 - 单元素序列:
",".join(["solo"])会直接返回该元素内容"solo",不会添加任何分隔符。只有当元素数量大于等于 2 时,分隔符才会出现在元素之间。 - 空字符串元素:若列表中本身包含空字符串,分隔符仍然会正常插入,例如
"-".join(["a", "", "b"])将返回"a--b"。
误区 5:在少量常量拼接场景下过度使用 join
虽然 join() 性能卓越,但主要体现在动态集合或较长列表的处理上。对于少量明确命名的变量拼接,过度使用 join() 反而会损害可读性并带来额外的元组打包开销:
first_name = "Guido"
last_name = "Rossum"

# 不推荐:写法繁琐且可读性差
full_name = " ".join([first_name, last_name])

# 推荐:使用 f-string,直观、清晰且在底层经由编译器优化
full_name = f"{first_name} {last_name}"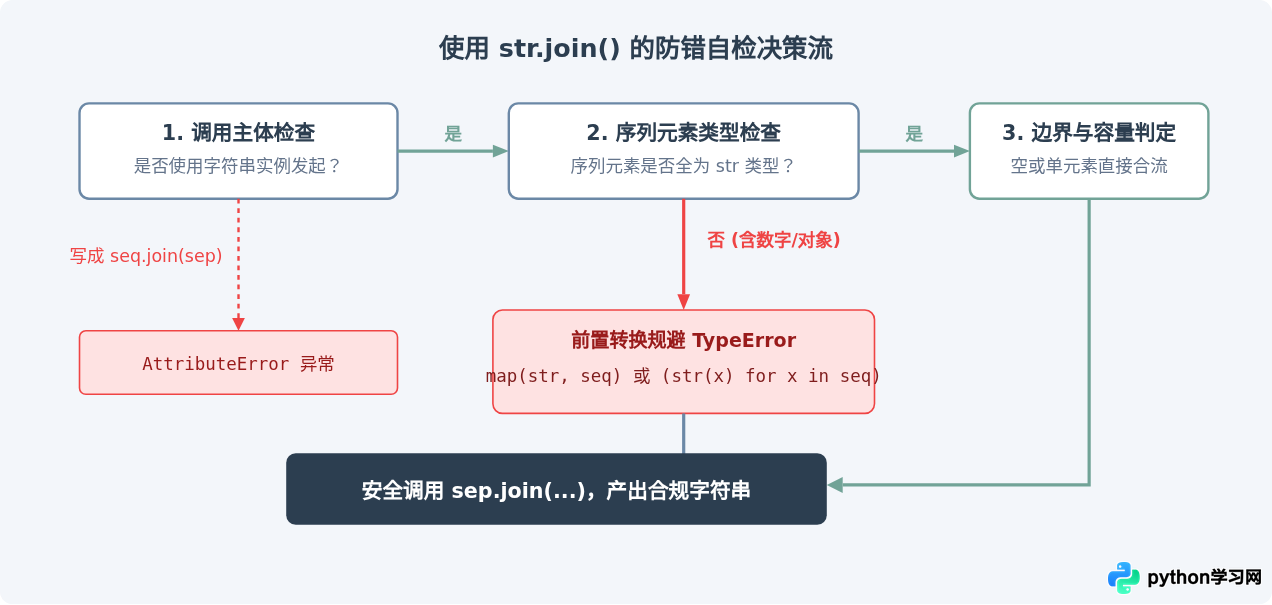
四、字符串拼接场景选型对比
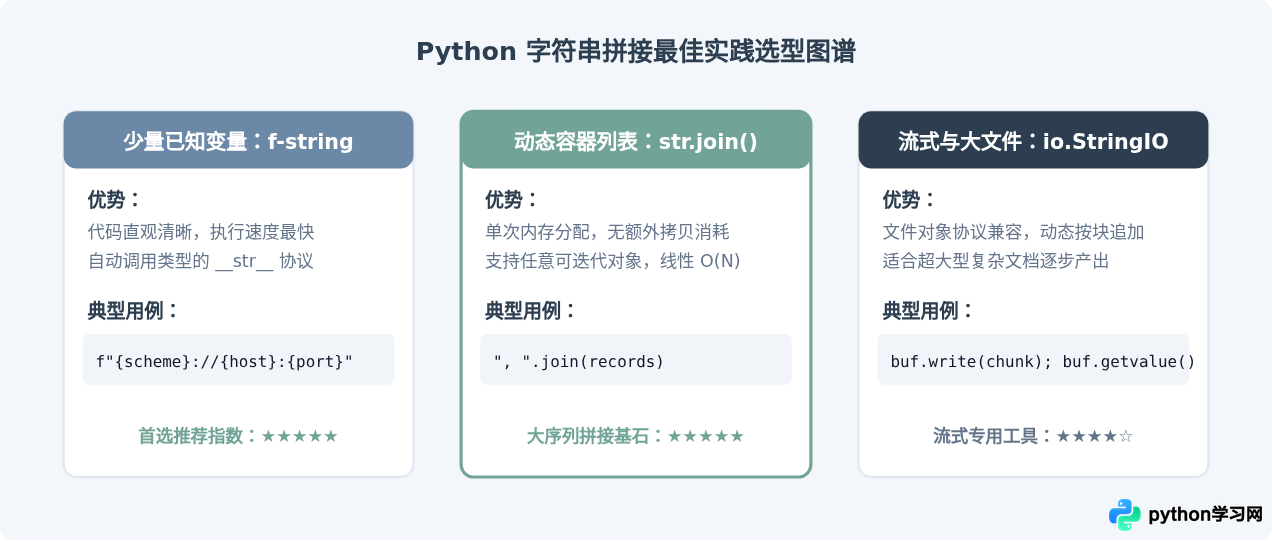
在日常 Python 工程中,字符串拼接有多种实现手段。合理根据输入规模与应用场景选择,既能保障执行性能,又能提升代码的可读性与维护性。
| 方案 | 典型语法 | 时间复杂度 | 适用场景 | 主要缺陷 / 限制 |
|---|---|---|---|---|
| str.join() | ",".join(seq) |
\(O(N)\) | 列表/迭代器的大量元素拼接、动态文本组装 | 要求元素全为 str;语法调用略反直觉 |
| f-string (格式化) | f"{var1}-{var2}" |
\(O(1)\) (常数级) | 数量明确的局部变量组合、文本插值 | 无法直接处理不定长的动态序列 |
| 加号操作符 (+) | a + b + c |
\(O(N^2)\) | 极少数字符串常量拼合(≤ 2 个) | 循环内使用性能劣化严重,内存碎片多 |
| io.StringIO | buf.write(s) |
\(O(N)\) | 复杂流式文件构建、逐步生成并导出的长篇文档 | 需要导入额外模块并维护缓冲区生命周期 |
五、全文总结
掌握 str.join() 是编写高品质 Python 代码的基础素养。记住以下核心要点,即可彻底远离拼接相关的语法错误与性能陷阱:
- 语法口诀:
分隔符.join(序列)。是“用分隔符把序列串起来”,而不是列表自己调用。 - 类型严谨:所有传入元素必须是
str。面对数字或其他复合对象,优先使用map(str, ...)或推导式做防御性转换。 - 复杂度保证:底层依赖两次扫描预申请内存,复杂度稳定在 \(O(N)\),拒绝在循环中使用
+=拼接序列。 - 按需选型:少量已知项选
f-string,未知长序列选str.join(),巨型流式文本选io.StringIO。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















