


Python单行与多行注释语法详解:#号与三引号的区别
深入详解Python单行与多行注释语法,分析井号(#)与三引号('''与""")在语法解析、AST抽象语法树、字节码编译及内存分配层面的底层区别,提供规范用法与选型指南。
在 Python 编程中,为代码添加清晰的注释是保证项目可读性与可维护性的基础。很多初学者甚至有一定经验的开发者常把井号(#)与三引号(''' 或 """)混为一谈,习惯性地将 # 称为单行注释,把未赋值的三引号称为多行注释。然而,从 Python 语言的规范与底层实现来看,# 是 Python 语法层面唯一定义的“真正的注释标记”,而三引号本质上是多行字符串字面量(Multiline String Literal)。理解两者的根本差异,不仅能帮助开发者写出更符合规范的代码,还能有效规避因误用三引号引发的缩进错误、内存常驻与运行时异常。
| 对比维度 | 井号注释(#) | 三引号字符串(''' 或 """) |
|---|---|---|
| 语法属性 | 真正的语法级注释(Comment) | 多行字符串字面量(String Literal) |
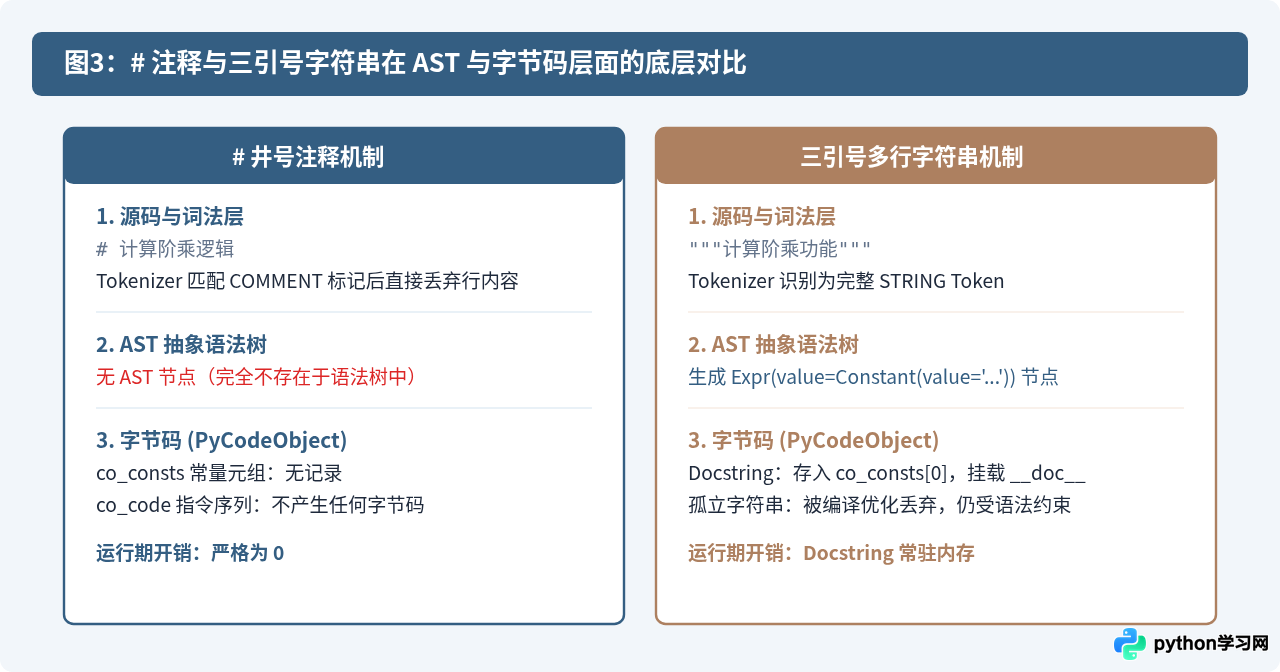
| 词法分析与 AST | 被 Tokenizer 直接过滤,不产生 AST 节点 | 产生完整字符串 Token,生成 Expr 表达式节点 |
| 字节码与内存开销 | 完全不参与编译,零字节码、零内存开销 | 若作为 Docstring 存入常量表常驻内存;孤立使用仍受语法制约 |
| 缩进与语法敏感度 | 完全不受所在代码块缩进影响 | 必须遵守严格的代码块缩进,否则抛出 IndentationError |
| 主要规范用途 | 行内说明、逻辑分支解释、临时屏蔽代码 | 模块、类、函数的接口说明文档(Docstring)及多行文本 |
一、# 号注释:Python 真正的语法级注释
在 Python 中,任何以 # 开头的内容都会被解释器视为注释。注释的作用是向阅读源码的人解释代码的设计意图、算法逻辑或注意事项,计算机在运行程序时会完全忽略这部分内容。
1. 单行注释与行尾注释的规范写法
单行注释可以独占一行,也可以紧跟在代码语句之后(行尾注释)。根据 Python 官方编码风格指南(PEP 8)的规范:
- 独占一行:
#后面应当紧跟一个半角空格,随后书写解释文字,并与被解释的代码保持相同的缩进层次。 - 行尾注释:在代码语句与
#之间必须保留至少两个空格,#与注释内容之间保留一个空格。行尾注释应尽量克制使用,避免分散对核心逻辑的注意力。
# 独占一行的单行注释:初始化重试计数器与最大尝试上限
retry_count = 0
MAX_RETRIES = 5  # 行尾注释:距离代码至少两个空格,#后空一格

def calculate_tax(amount: float) -> float:
    # 按照当地统一标准折算基准税额
    base_tax = amount * 0.08
    return round(base_tax, 2)
2. 多行连续注释的标准做法
Python 语言本身并没有专门设计形如 C 语言 /* ... */ 的块级注释语法。在 Python 中编写跨越多行的逻辑说明时,官方标准推荐的做法是连续使用多个以 # 开头的单行注释。现代主流编辑器(如 VS Code、PyCharm)均支持一键快捷键(Ctrl + / 或 Cmd + /)批量添加与移除 #。
# -------------------------------------------------------------
# 数据同步校验流程说明:
# 1. 首先核验本地数据库事务流水号与远端主库是否一致;
# 2. 若存在差额,触发轻量补偿机制拉取最近 10 分钟的 binlog;
# 3. 校验完成后将游标写入持久化缓存中,供下次拉取使用。
# -------------------------------------------------------------
def sync_transactions():
    pass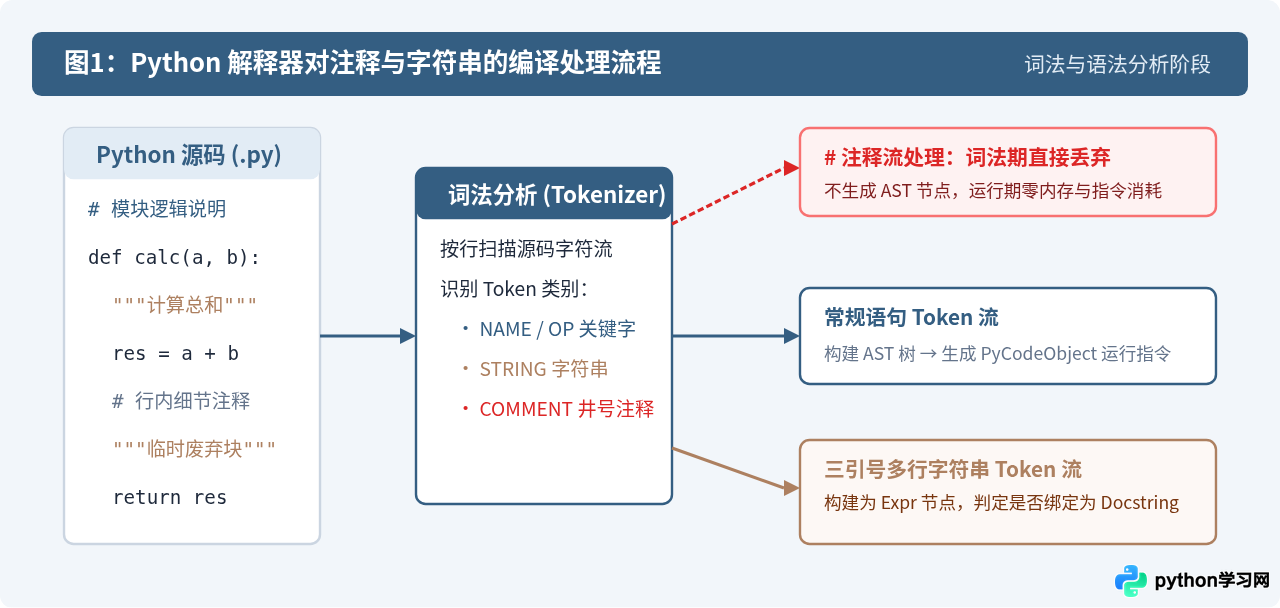
二、三引号('''与"""):多行字符串与文档字符串
由连续三个单引号 ''' 或连续三个双引号 """ 括起来的内容,在 Python 语法体系中是合法的多行字符串字面量。它并不是注释,但由于其允许多行换行且在未被引用时常被解释器在生成执行指令时忽略,导致许多人习惯将其视作“多行注释语法”。
1. 规范的用途一:文档字符串(Docstring)
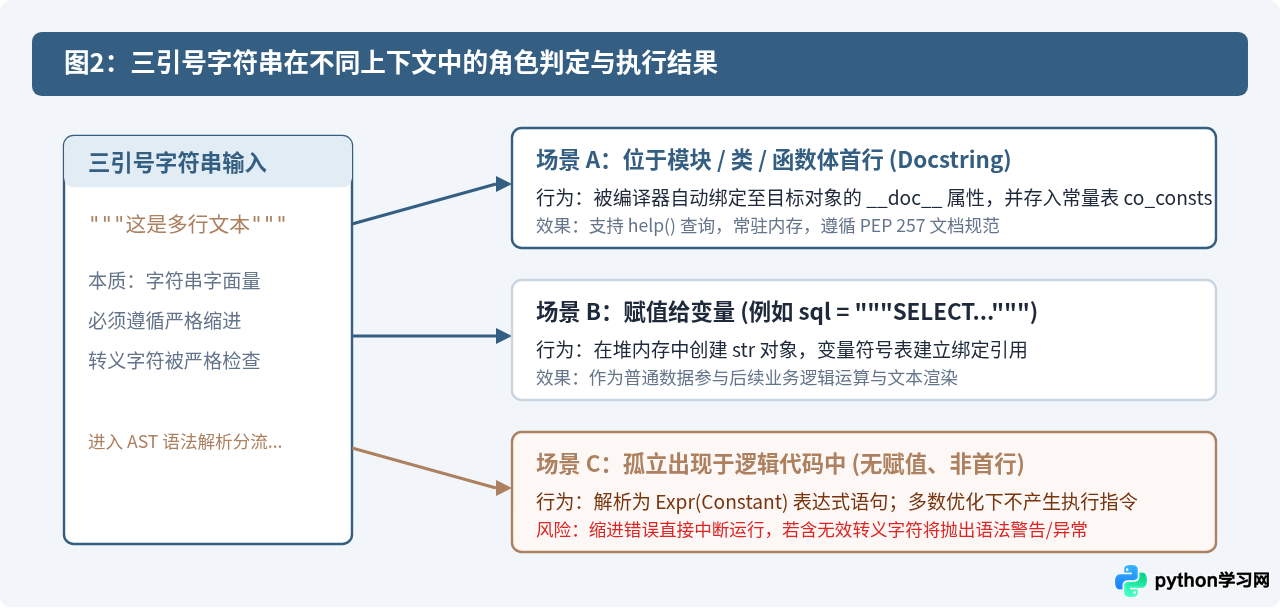
当一个三引号多行字符串紧跟在模块、函数、类或方法的定义语句之后,作为该作用域内的第一个逻辑语句时,Python 解释器会将其识别为 Docstring(PEP 257 规范)。
Docstring 会在编译期间被直接绑定到目标对象的 .__doc__ 内置属性中,使得开发者与自动化工具能够在运行期通过 help(obj) 或反射机制动态提取帮助文档:
def render_svg(width: int, height: int) -> str:
    """生成包含标准视口的 SVG 根画布标签。

    参数:
        width (int): 图像逻辑宽度,必须为正整数。
        height (int): 图像逻辑高度,必须为正整数。

    返回:
        str: 构造完毕的 SVG 根标签字符串。
    """
    return f'<svg width="{width}" height="{height}" viewBox="0 0 {width} {height}">'

# 运行期可通过 __doc__ 属性反查说明内容
print(render_svg.__doc__)
2. 规范的用途二:长文本与多行字符串赋值
在常规赋值语句中,三引号用于定义跨越多行的文本数据(例如复杂的 SQL 查询语句、HTML 模板、多行格式化字符串),内部可以直接换行而无需显式输入 \n:
query_sql = """
SELECT user_id, username, created_at
FROM system_users
WHERE status = 'active'
ORDER BY created_at DESC
LIMIT 10;
"""
3. 孤立多行字符串的陷阱:缩进错误与语法限制
当三引号字符串既没有赋值给变量,也没有作为 Docstring 出现在作用域首行时,它在语法上是一个孤立的表达式语句(Expression Statement)。许多开发者直接用它来注释大段代码,这隐藏着两个关键风险:
- 严格缩进要求:作为表达式语句,三引号的每一行都必须符合当前代码块的缩进要求。如果多行字符串内部的首行缩进不当,会直接引发致命的
IndentationError,导致程序无法通过编译。 - 转义字符检查:
#之后的字符完全不受语法解析影响,但三引号内容依然要经过字符串转义解析。如果内部包含不合规的反斜杠转义序列(例如 Windows 路径"""C:\users\temp"""),将触发SyntaxWarning甚至SyntaxError。
三、底层机制对比:AST 抽象语法树与字节码反汇编
为了从根本上厘清两者的技术分界,我们可以通过 Python 内置的 ast 模块和 dis 字节码反汇编工具进行实测对照。
1. 字节码指令层面分析
考虑以下包含 # 注释和孤立多行字符串的代码示例:
import dis

def demo_function():
    # 这是井号注释
    a = 10
    """这是写在中间的孤立多行字符串"""
    return a * 2

dis.dis(demo_function)
反汇编输出的指令序列如下(示例输出):
  5           0 LOAD_CONST               1 (10)
              2 STORE_FAST               0 (a)

  7           4 LOAD_FAST                0 (a)
              6 LOAD_CONST               2 (2)
              8 BINARY_MULTIPLY
             10 RETURN_VALUE
从输出结果可以看出:
- 第 4 行的
# 这是井号注释完全没有出现在指令表与常量池中; - 第 6 行的孤立三引号虽然没有生成额外的
LOAD_CONST执行指令(在 CPython 编译器优化阶段被剥离),但它在编译前必须经历完整的语法树构建; - 如果是写在首行的 Docstring,它会被强制保留在当前代码对象的常量元组
__code__.co_consts的首位,在整个程序生命周期中始终占用内存。
四、规范使用与选型决策指南
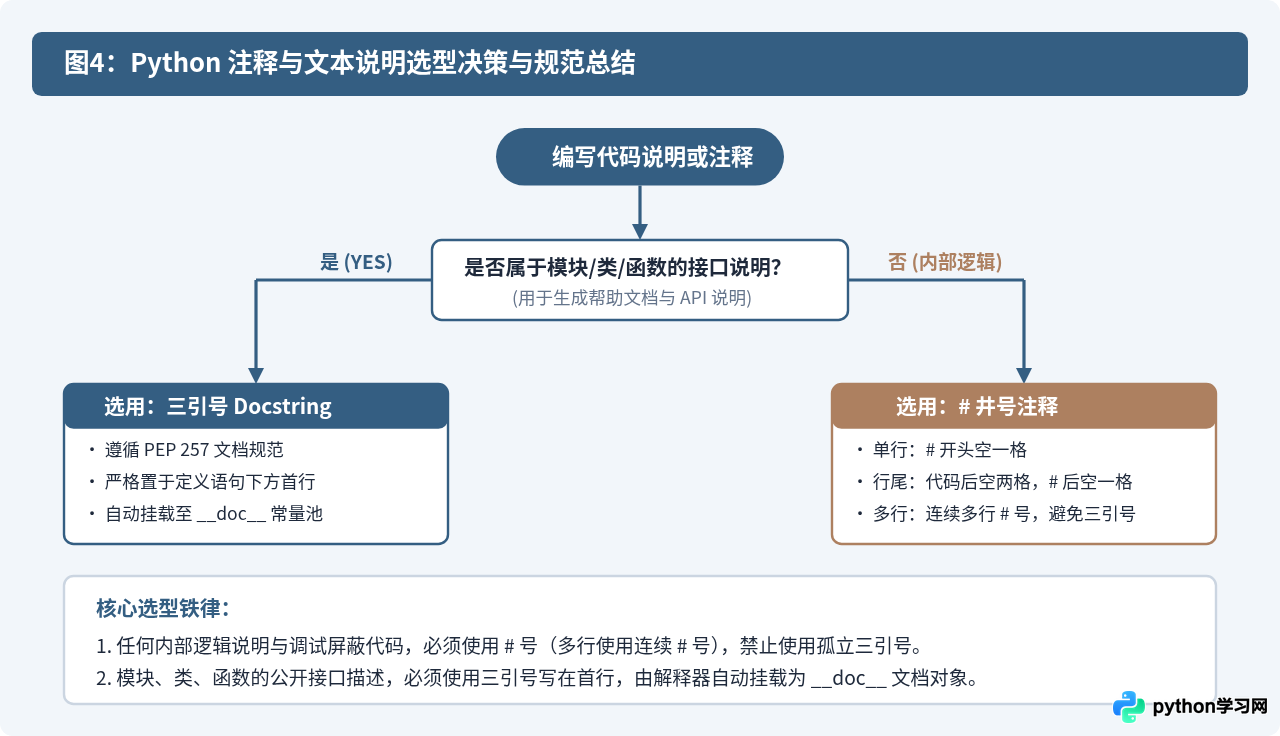
在日常开发过程中,选择 # 还是三引号并不取决于“文字有多长”,而取决于文字承担的语义职责。
1. 什么时候必须使用 # 号?
- 代码行解释:对当前行或紧邻的几行算法、数学公式、业务规则进行直观说明。
- 跨行逻辑描述:对一个复杂代码段进行背景说明或分步拆解时,连续使用多个
#注释。 - 临时调试代码屏蔽:在排查 Bug 或测试时需要临时注释掉若干行可执行语句。使用
#绝不会因为代码原本的缩进引起歧义。 - 文件编码或环境声明:如放在脚本最开头的
#!/usr/bin/env python3(Shebang)以及# -*- coding: utf-8 -*-。
2. 什么时候必须使用三引号?
- 模块/类/函数文档字符串:编写正式的对外 API 接口文档,详细描述功能、参数类型、返回值与异常说明。
- 长文本常量赋值:需要跨行书写的大段 JSON 模板、SQL 脚本、Markdown 或邮件提示文本。
不要在业务逻辑代码内部使用未赋值的三引号作为多行注释。一方面这违背了 PEP 8 规范,另一方面团队协作时,代码格式化工具(如 Black、YAPF)或语法检查器(Flake8、Pylint)会对多行字符串缩进与未使用表达式报出告警。
五、常见问题排查与注意事项
1. 误用三引号引发的 IndentationError
很多开发者在条件分支或循环体内部尝试使用三引号注释掉一段代码,例如:
def process_user(user):
    if user.is_authenticated:
"""
临时屏蔽原有鉴权逻辑
validate_token(user.token)
"""
        user.mark_active()
上述代码会在编译期直接报错 IndentationError: expected an indented block after 'if' statement。这是因为三引号本身是一个表达式,其左对齐的缩进破坏了 if 语句要求的代码块缩进。改用 # 则完全不会产生这种问题:
def process_user(user):
    if user.is_authenticated:
        # 临时屏蔽原有鉴权逻辑
        # validate_token(user.token)
        user.mark_active()
2. 文档字符串放置位置错误导致 __doc__ 丢失
在编写函数或类时,若在三引号前插入了其他可执行语句(甚至仅仅是一条变量赋值),该三引号便不再具备 Docstring 资格,无法通过 .__doc__ 访问:
def bad_docstring():
    status = "INIT"  # 首句被赋值占据
    """这个三引号不再被识别为 Docstring"""
    return status

print(bad_docstring.__doc__)  # 输出结果将为 None!
3. 总结清单
- 真正意义上的注释:只有以
#开头的字符流是 Python 的真正注释,完全不进入语法树与字节码。 - 三引号的本质:是可跨行的字符串对象。处于作用域首句时特化为 Docstring 并常驻内存;处于赋值右侧时为普通字符串;孤立放置时是容易引发缩进异常的无用表达式。
- 编写建议:代码逻辑与多行调试必须使用
#;接口规范说明必须在首行使用三引号 Docstring。遵循规范可以彻底杜绝潜在隐患。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















