


Python分页计算中怎么应用向上取整
在Python中开发数据列表、接口和管理后台时,分页计算是最高频的需求之一。本文系统讲解在Python分页计算中如何应用向上取整计算总页数,对比math.ceil、整数算术偏移、双重取反整除及divmod等方案,并深入解析边界值防御与工程实践。
在后端服务、数据接口以及各类管理系统的列表开发中,分页计算是最高频的运算场景之一。计算总页数的核心逻辑在于:无论最后一页是否排满,只要存在剩余数据,就必须为其分配一个完整的页码。在数学计算中,这种“只要除不尽就向数值更大的方向进一位”的运算即为向上取整(Ceil)。本文将针对 Python 语言特性,系统讲解向上取整在分页中的具体实现方案、不同写法的运行原理以及必须处理的边界异常。
一、分页为什么必须使用向上取整
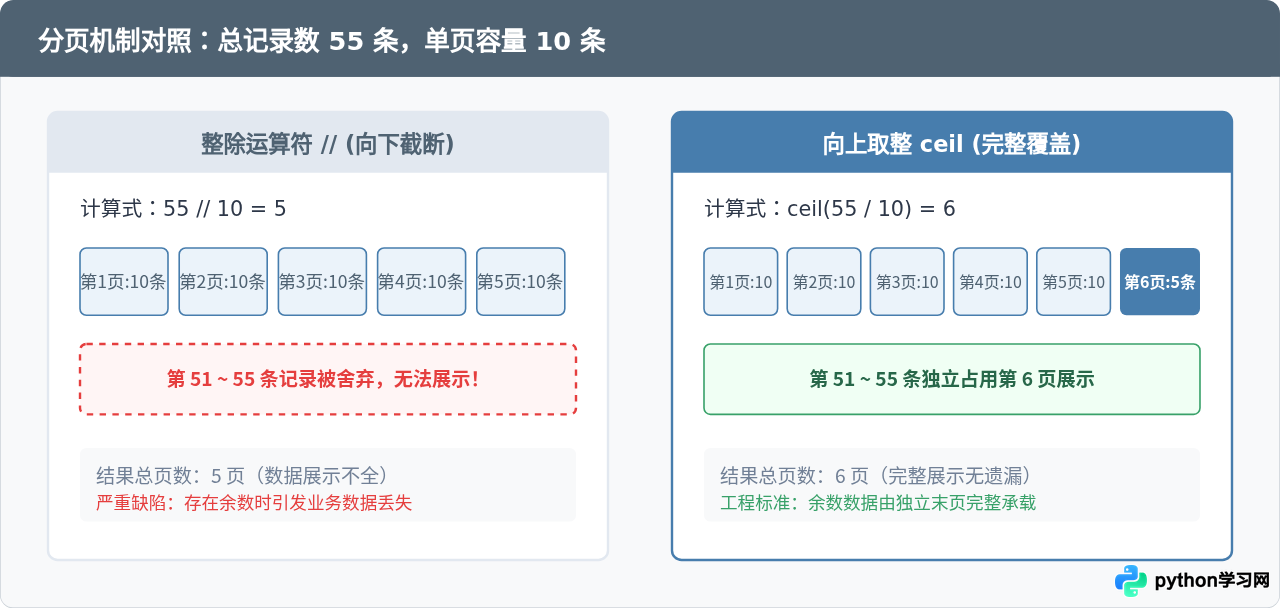
假设数据库中共有 55 条待展示记录,前端配置为每页展示 10 条数据。直觉上使用除法运算 55 / 10,得到浮点数 5.5。如果直接采用 Python 默认的整数除法运算符 //,运算结果为 55 // 10 = 5。这里的整数除法本质是向下取整(Floor),它直接丢弃了小数部分。结果将导致第 51 到 55 条这 5 条有效记录无法被第 6 页展示,直接造成数据丢失。
要让所有数据都能被完整检索,分页算法必须满足一个基本准则:前 50 条数据填满前 5 页,剩余的 5 条数据单独占用第 6 页。这就是向上取整在分页中的核心价值。以下图表直观展示了向下取整导致的数据丢失与向上取整的完整性保障:
二、Python 实现向上取整的四种具体方法
在 Python 实际编码中,实现总页数向上取整有四种常见方式。每种方式在可读性、执行性能以及对边界值的依赖上各有特点。
方法 1:使用标准库 math.ceil() 函数
这是语义最直观、阅读门槛最低的实现方式。Python 内置的 math 模块提供了 ceil 函数,用于返回大于或等于给定浮点数的最小整数。
import math

total_count = 55
page_size = 10

# 浮点数除法后向上取整
total_pages = math.ceil(total_count / page_size)
print(f"总页数: {total_pages}")  # 输出: 总页数: 6
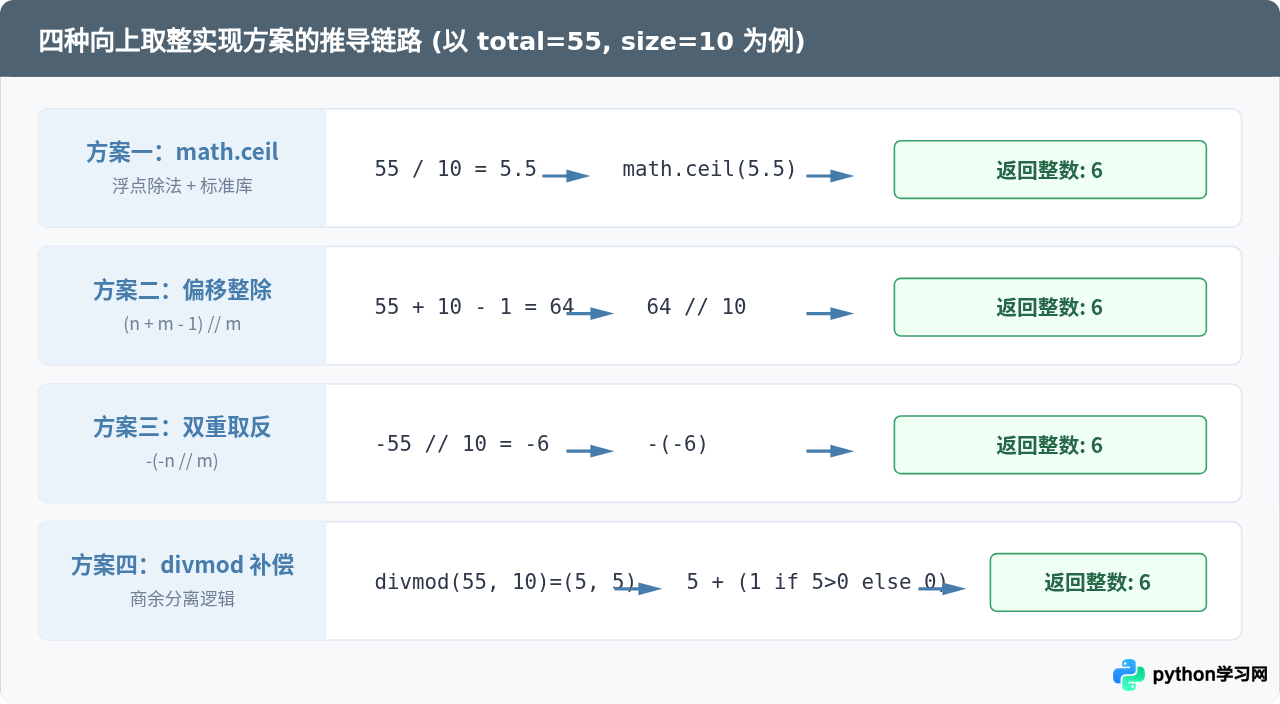
执行原理:55 / 10 执行真除法得到浮点数 5.5,math.ceil(5.5) 返回整数 6。如果记录数刚好整除,例如 50 / 10 = 5.0,math.ceil(5.0) 则返回 5,结果同样准确。
方法 2:纯整数算术偏移公式 (total + page_size - 1) // page_size
在无需导入模块的高性能计算场景或底层框架中,通常采用经典的整数算术偏移法:
total_count = 55
page_size = 10

total_pages = (total_count + page_size - 1) // page_size
print(f"总页数: {total_pages}")  # 输出: 总页数: 6
推导原理:
- 当
total_count = 50(刚好整除)时:分子变为50 + 10 - 1 = 59,而59 // 10 = 5,偏移量page_size - 1不足以跨入下一个整除区间,保持原有页数不变。 - 当
total_count = 51(存在微小余数 1)时:分子变为51 + 10 - 1 = 60,60 // 10 = 6,刚好被推入下一页区间。 - 纯整数运算完全避免了浮点数转换,在大规模批处理循环中执行效率极高。需要注意该公式在
total_count == 0时结果为0(在非负整数范围内成立)。
方法 3:利用负数整除的双重取反法 -(-total // page_size)
Python 中的整除运算符 // 始终遵循向下取整(朝负无穷大方向取整)。这一特性使得负数整除天然具备“向上进位”的镜像效果:
total_count = 55
page_size = 10

total_pages = -(-total_count // page_size)
print(f"总页数: {total_pages}")  # 输出: 总页数: 6
执行原理:首先计算 -55 // 10,数学结果为 -5.5。向负无穷方向取整后得到 -6;再次对其取负运算 -(-6),即可得到正数 6。若刚好整除,-50 // 10 = -5,再取负即为 5。这种语法极其紧凑,且同样完全运行在整数域。
方法 4:利用内置函数 divmod() 显式判断余数
如果业务中不仅需要计算总页数,还需要获知最后一页实际包含多少条记录,可以使用 Python 内置的 divmod() 函数:
total_count = 55
page_size = 10

quotient, remainder = divmod(total_count, page_size)
total_pages = quotient + (1 if remainder > 0 else 0)

print(f"完整页数: {quotient}, 末页余数: {remainder}, 总页数: {total_pages}")
# 输出: 完整页数: 5, 末页余数: 5, 总页数: 6
下图展示了这四种计算方式在底层执行上的推导与转换链路:
三、边界场景与工程防御性校验
生产环境中的数据输入往往包含异常或极端情况。如果直接将原始参数代入计算公式,容易引发除零异常、浮点精度失真或不符合业务约定的页码。
1. 单页容量 page_size <= 0 的防御
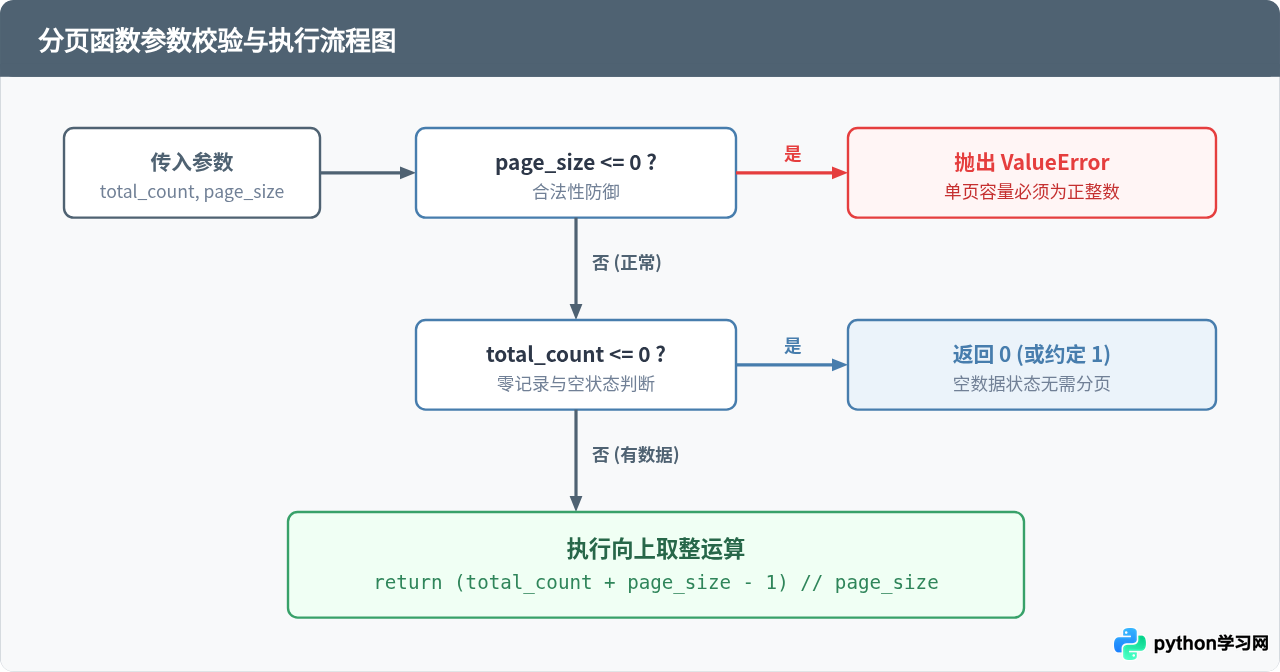
当客户端传入非法参数(例如 page_size = 0 或负数)时,除法运算会直接抛出 ZeroDivisionError。在函数入口处必须进行防御性检查:
if page_size <= 0:
    raise ValueError("page_size 必须为大于 0 的正整数")
2. 数据总量 total_count == 0 时的业务定义
数据总量为 0 属于高频正常业务场景(例如用户发起无匹配结果的搜索)。在数学上,0 条数据对应 0 页;但在很多前端 UI 组件(如 Element UI、Ant Design)的设计中,列表空状态依然要求处于“第 1 页”,且总页数显示为 1 或 0 取决于具体交互规范:
- 标准 RESTful API 规范:通常约定
total_pages = 0,以便前端准确识别当前无数据内容。 - 兼容传统视图模板:常约定
total_pages = 1,确保用户处于合法的第一页视图。
3. 大整数场景下的浮点精度丢失
Python 3 的原生整型 int 拥有任意精度,支持无限长整数运算。但如果使用 math.ceil(total_count / page_size),中间的 / 运算会强制将整数转换为双精度浮点数(IEEE 754 标准,有效位数约为 53 位二进制,即 15~17 位十进制数)。当记录数超出 2^53(约 9007 万亿)时,浮点转换将发生精度截断,进而导致向上取整计算失真。因此,在海量分布式数据或高精度计数场景下,纯整数计算法 (n + m - 1) // m 是唯一安全的方案。
综合以上边界检查逻辑,下图梳理了企业级分页函数的防御流程:
四、可直接复用的封装函数示例
基于上述分析,在实际工程项目中建议将分页计算统一封装为通用工具函数。以下代码给出了包含类型注解、入参校验和空值兼容处理的标准实现:
def get_total_pages(total_count: int, page_size: int, allow_zero: bool = True) -> int:
    """
    计算数据列表的总页数(应用向上取整)

    :param total_count: 数据总记录数(必须大于等于0)
    :param page_size: 单页容量(必须大于0)
    :param allow_zero: 当 total_count 为 0 时,是否允许返回 0 页;
                       若为 False,则最少返回 1 页以适应特定 UI 组件
    :return: 向上取整后的总页数
    """
    if page_size <= 0:
        raise ValueError(f"page_size 必须为正整数,当前传入: {page_size}")
    if total_count < 0:
        raise ValueError(f"total_count 不能为负数,当前传入: {total_count}")

    if total_count == 0:
        return 0 if allow_zero else 1

    # 使用纯整数运算,兼顾性能与大整数安全性
    return (total_count + page_size - 1) // page_size


# 验证测试用例
if __name__ == "__main__":
    print(get_total_pages(55, 10))        # 正常向上取整 -> 输出: 6
    print(get_total_pages(50, 10))        # 刚好整除 -> 输出: 5
    print(get_total_pages(1, 10))         # 单条数据 -> 输出: 1
    print(get_total_pages(0, 10))         # 空数据 -> 输出: 0
    print(get_total_pages(0, 10, False))  # 空数据兜底 -> 输出: 1
测试验证说明:运行上述代码,依次验证余数进位(55 条得 6 页)、整除不变(50 条得 5 页)、单条最小边界(1 条得 1 页)以及空列表两种业务模式(0 页或 1 页),所有输出均完全符合分页预期。
五、方案选型矩阵与工程总结
不同实现方式在日常开发中的选型参考如下表所示:
| 实现方案 | 标准库依赖 | 代码可读性 | 超大整数精度 | 推荐应用场景 |
|---|---|---|---|---|
math.ceil(n / m) |
需导入 math | 极高(语义明确) | 存在浮点上限(>2^53) | 日常业务接口、管理后台、代码易读性优先的团队 |
(n + m - 1) // m |
无依赖 | 较高(通用算法经典) | 完全支持(任意精度) | 高性能批处理、基础中间件、ORM底层封装 |
-(-n // m) |
无依赖 | 较低(语法较为隐晦) | 完全支持(任意精度) | 追求极致精简单行表达的场景 |
divmod(n, m) |
内置无依赖 | 高(结构清晰) | 完全支持(任意精度) | 需要同时获取总页数与末页剩余条数的复杂场景 |
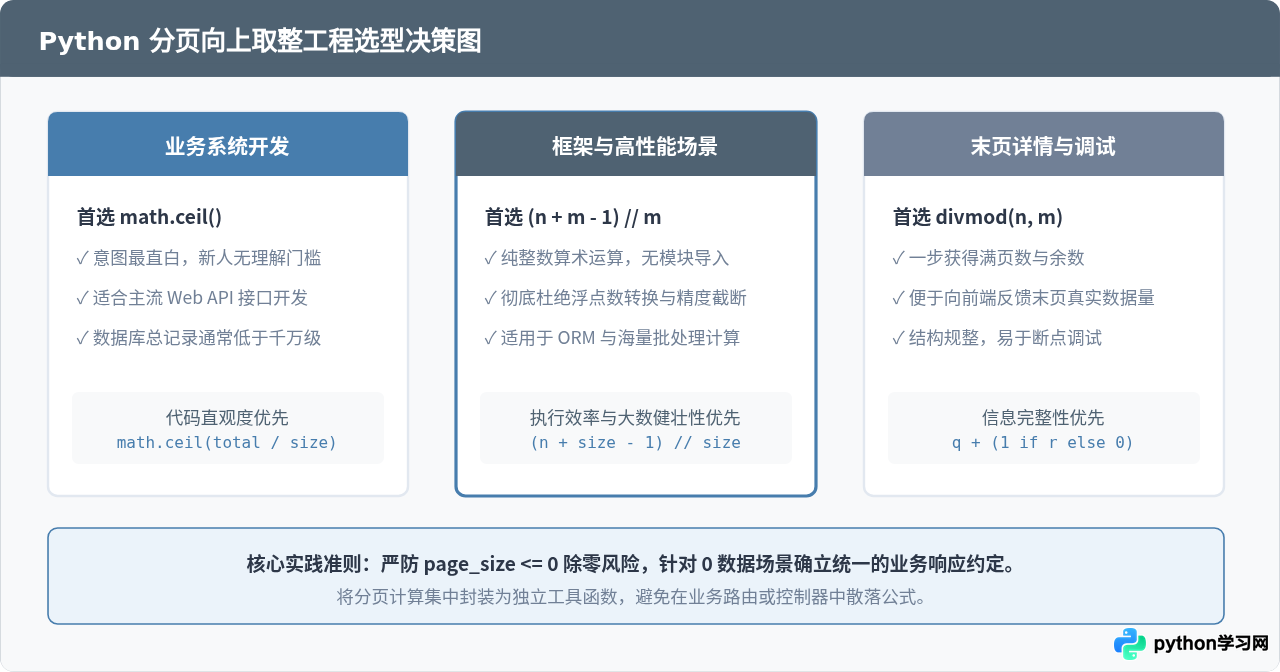
综上所述,在 Python 分页计算中应用向上取整并不复杂,关键在于根据系统定位选择恰当的实现方式:在大多数通用 Web 业务中,推荐直接使用 math.ceil 保证逻辑清晰易懂;在底层框架或对性能、超大数值有严格要求的场合,则推荐使用 (total + page_size - 1) // page_size 纯整除公式,并务必在入口处完成边界条件防御。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















