


Python数据分析常用库有哪些?Pandas、NumPy与Matplotlib简介
全面解析Python数据分析最核心的三大基础库:NumPy、Pandas与Matplotlib。详细讲解各库核心概念、工作机制、基础操作代码示例以及三者之间的协同配合流程。
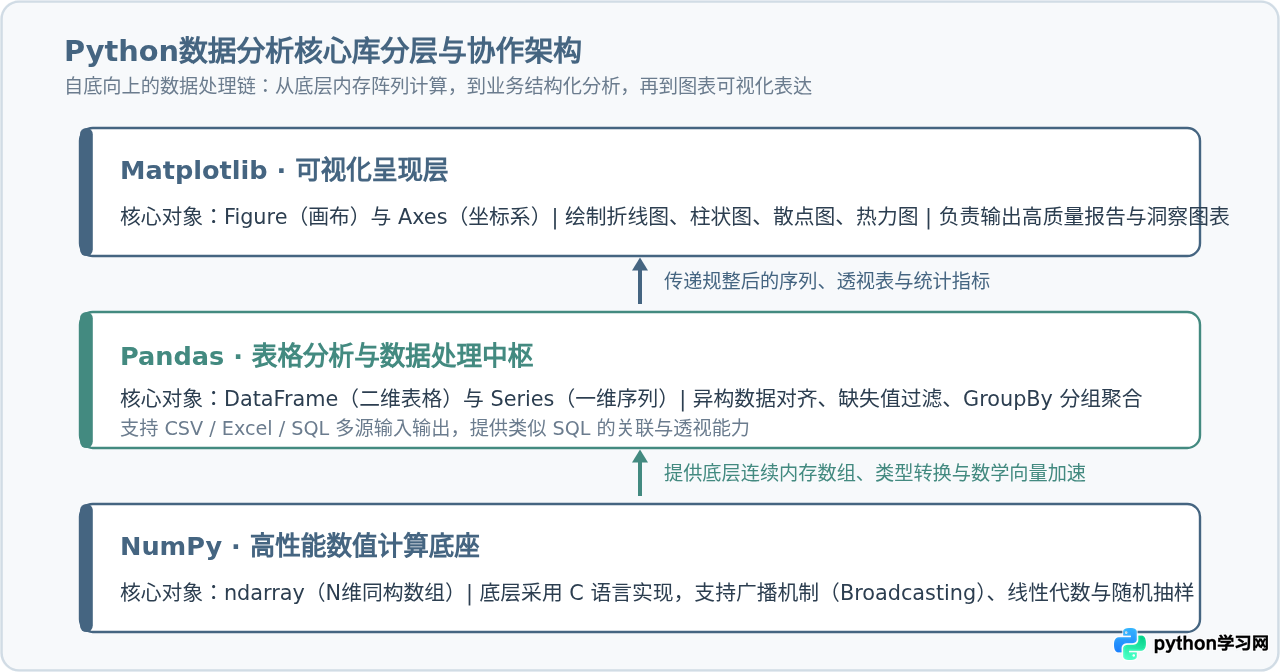
在 Python 数据分析技术栈中,NumPy、Pandas 与 Matplotlib 被公认为最核心、使用频次最高的三大基础库。它们各司其职又紧密联动:NumPy 负责底层高性能多维数组运算与数学支撑;Pandas 专注于结构化表格数据的读取、清洗、重塑与统计分析;Matplotlib 则承担将数据规律转化为直观图表的视觉呈现任务。掌握这三个库的核心对象与协作流程,是开展任何真实数据分析工作的基石。
一、NumPy:高性能数值计算基石
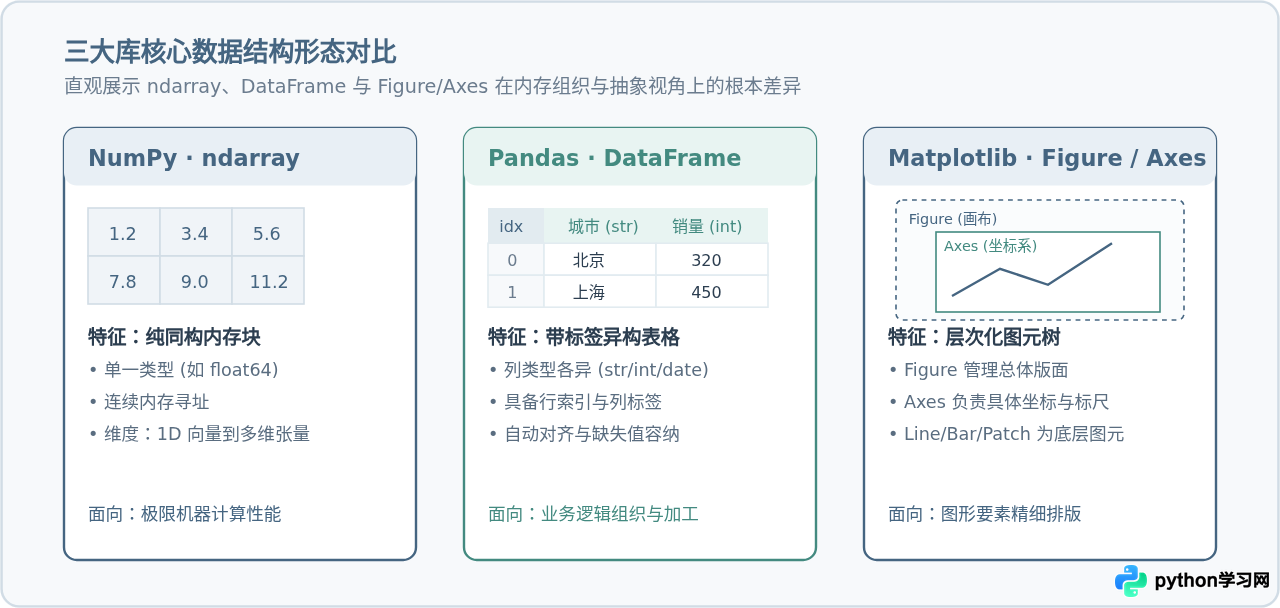
NumPy(Numerical Python)是整个 Python 科学计算生态的基石。Python 原生内置的 list 属于动态类型指针数组,元素在内存中离散分布,进行大规模数值计算时存在严重的寻址开销与类型检查损耗。NumPy 针对此痛点,引入了基于连续内存块的同构多维数组对象——ndarray。
1. 核心机制与优势
- 连续内存与强类型:
ndarray中的所有元素必须具有相同的类型(如int64或float64),数据在内存中紧凑排列,能够充分利用 CPU 高速缓存(L1/L2 Cache)和 SIMD 指令集。 - 向量化运算(Vectorization):无须编写显式
for循环,即可对整个数组执行算术或逻辑操作,底层直接由优化的 C 语言代码批量执行,运行速度通常比纯 Python 循环快数十倍乃至上百倍。 - 广播机制(Broadcasting):当两个形状不同的数组进行运算时,NumPy 会在符合维度兼容规则的前提下自动扩展较小的数组,无须冗余复制数据。
2. 常用操作与代码示例
import numpy as np

# 1. 创建一维与二维数组
arr_1d = np.array([10, 20, 30, 40, 50])
arr_2d = np.array([[1, 2, 3], [4, 5, 6]])

# 2. 向量化运算(无需循环)
scaled = arr_1d * 1.5 + 5
print("向量化计算结果:", scaled)
# 输出: [20.  35.  50.  65.  80.]

# 3. 统计汇总计算
print("均值:", np.mean(arr_1d))
print("标准差:", np.std(arr_1d))
print("矩阵沿列求和 (axis=0):", np.sum(arr_2d, axis=0))
# 输出: [5 7 9]

# 4. 布尔索引切片
mask = arr_1d > 25
print("大于25的元素:", arr_1d[mask])
# 输出: [30 40 50]arr.copy()。
二、Pandas:结构化数据清洗与分析利器
如果说 NumPy 解决了“纯数值矩阵的高速计算”,那么 Pandas 则解决了“真实世界杂乱数据的清洗与加工”。在实际业务中,数据往往以表格形式存在,包含文字、日期、浮点数以及大量缺失值(NaN),Pandas 专为此类异构表格数据而设计。
1. 两个核心数据结构
- Series(一维带标签序列):由一组数据以及一组与之相关的行索引(Index)组成,类似于带命名的单列数组。
- DataFrame(二维异构数据表格):由多个共享相同索引的 Series 并排组成。每一列可以拥有独立的数据类型(如文本列、数值列、布尔列),具备完备的行标签与列标签。
2. 核心操作场景
数据分析工作中 80% 的时间通常消耗在数据准备与清洗阶段。Pandas 提供了简洁且表现力极强的方法来处理这些问题:
- 文件读写:通过
pd.read_csv()、pd.read_excel()、pd.read_sql()可一键接入不同来源数据。 - 缺失值处理:快速排查缺失位置(
df.isna().sum())、删除缺失行(df.dropna())或按策略填补(df.fillna())。 - 分组聚合(GroupBy):实现“拆分-应用-合并”范式,例如按照产品分类统计总销量与平均客单价。
import pandas as pd

# 构造模拟销售数据
data = {
    '部门': ['技术部', '销售部', '市场部', '技术部', '销售部'],
    '员工': ['张伟', '李强', '王芳', '刘洋', '陈敏'],
    '销售额': [12000, 35000, 21000, 18000, 42000],
    '绩效评分': [4.5, 4.8, 3.9, 4.2, 4.9]
}
df = pd.DataFrame(data)

# 1. 数据筛选:查找销售额大于20000的记录
high_sales = df[df['销售额'] > 20000]
print("高销售额记录:\n", high_sales)

# 2. 分组聚合统计
dept_summary = df.groupby('部门').agg(
    总销售额=('销售额', 'sum'),
    平均绩效=('绩效评分', 'mean')
).reset_index()

print("\n部门汇总报表:\n", dept_summary)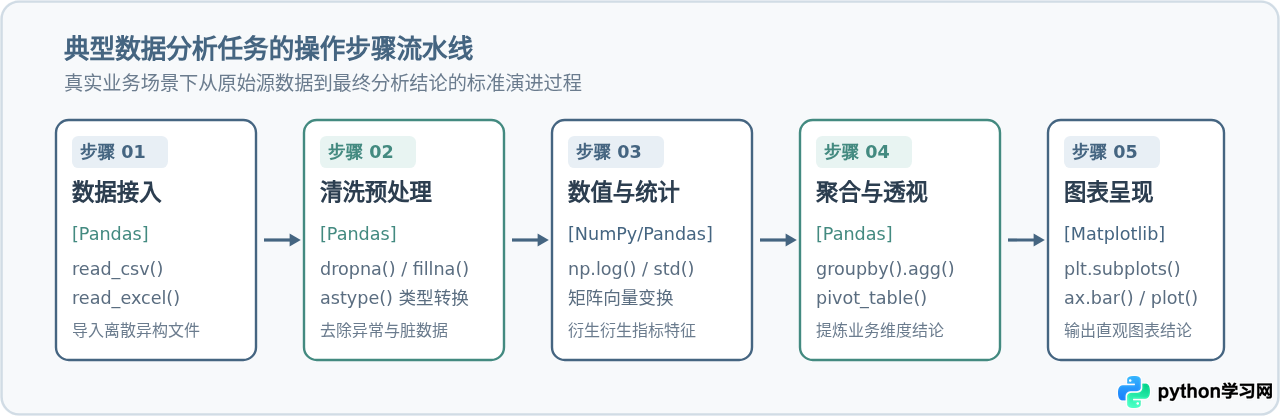
三、Matplotlib:数据洞察的图表可视化引擎
人类对图形的感知能力远胜于枯燥的数字矩阵。Matplotlib 是 Python 中应用最广泛的基础绘图库,几乎所有高阶可视化工具(如 Seaborn、Pandas 内置绘图功能)底层都建立在 Matplotlib 之上。
1. 理解绘图体系:Figure 与 Axes
许多初学者容易混淆 plt.plot() 与面向对象接口的差异。在 Matplotlib 的设计模型中:
- Figure(画布):指代整个窗口或图像页面,可以容纳多个子图、全局标题和图例。
- Axes(子图 / 坐标系):属于 Figure 的一部分,包含实际的数据绘图区域、X 轴、Y 轴、刻度线(Ticks)以及数据曲线。一个 Figure 可以包含一个或多个并排、堆叠的 Axes。
2. 推荐使用方式:面向对象接口风格
虽然可以直接使用 plt.plot() 进行快捷出图,但在实际工程与多子图排版中,推荐使用面向对象风格(Object-Oriented Style),显式掌控 fig 和 ax 对象:
import matplotlib.pyplot as plt

# 解决中文显示与负号乱码问题
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei']
plt.rcParams['axes.unicode_minus'] = False

# 1. 创建画布与坐标系 (1行2列的子图布局)
fig, (ax1, ax2) = plt.subplots(nrows=1, ncols=2, figsize=(10, 4))

# 2. 在第一个子图绘制折线走势图
months = ['1月', '2月', '3月', '4月', '5月']
sales = [120, 150, 180, 140, 210]
ax1.plot(months, sales, marker='o', color='#456581', linewidth=2, label='销售额趋势')
ax1.set_title('月度销售增长曲线')
ax1.set_ylabel('万元')
ax1.grid(True, linestyle='--', alpha=0.5)
ax1.legend()

# 3. 在第二个子图绘制柱状对比图
categories = ['产品A', '产品B', '产品C']
shares = [45, 30, 25]
ax2.bar(categories, shares, color=['#456581', '#438A80', '#6B7C8E'])
ax2.set_title('各产品市场份额占比')
ax2.set_ylabel('占比 (%)')

# 4. 调整版面边距并保存
plt.tight_layout()
plt.savefig('sales_report.png', dpi=300)
# plt.show()
四、三库协同实战:从清洗到可视化的完整闭环
在实际业务中,这三个库从不孤立存在。典型的数据工作流是:NumPy 快速构造或转换数值特征,Pandas 进行分组加工,最后将结果直接传递给 Matplotlib 输出图形。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# 1. 模拟生成时间序列数据 (利用 NumPy 生成随机指标)
np.random.seed(42)
dates = pd.date_range('2024-01-01', periods=100)
raw_values = np.random.randn(100).cumsum() + 50

# 2. 组装并清洗数据 (利用 Pandas 构造 DataFrame 并计算滚动均值)
df = pd.DataFrame({'日期': dates, '日访问量': raw_values})
df['7日平滑均线'] = df['日访问量'].rolling(window=7).mean()

# 3. 结果呈现 (利用 Matplotlib 绘图输出)
fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(df['日期'], df['日访问量'], color='#A0B2C6', alpha=0.6, label='原始波动')
ax.plot(df['日期'], df['7日平滑均线'], color='#438A80', linewidth=2.2, label='7日移动平均趋势')

ax.set_title('核心业务指标日度走势监控')
ax.set_ylabel('访问人次')
ax.grid(True, linestyle=':', alpha=0.6)
ax.legend()

plt.tight_layout()
# 此时完成了一个完整闭环:NumPy算子 -> Pandas时序分析 -> Matplotlib图表导出
五、核心库特性速查与选型参考
为了在遇到具体需求时快速定位合适的工具,以下梳理了三大库的选型参考与核心差异:
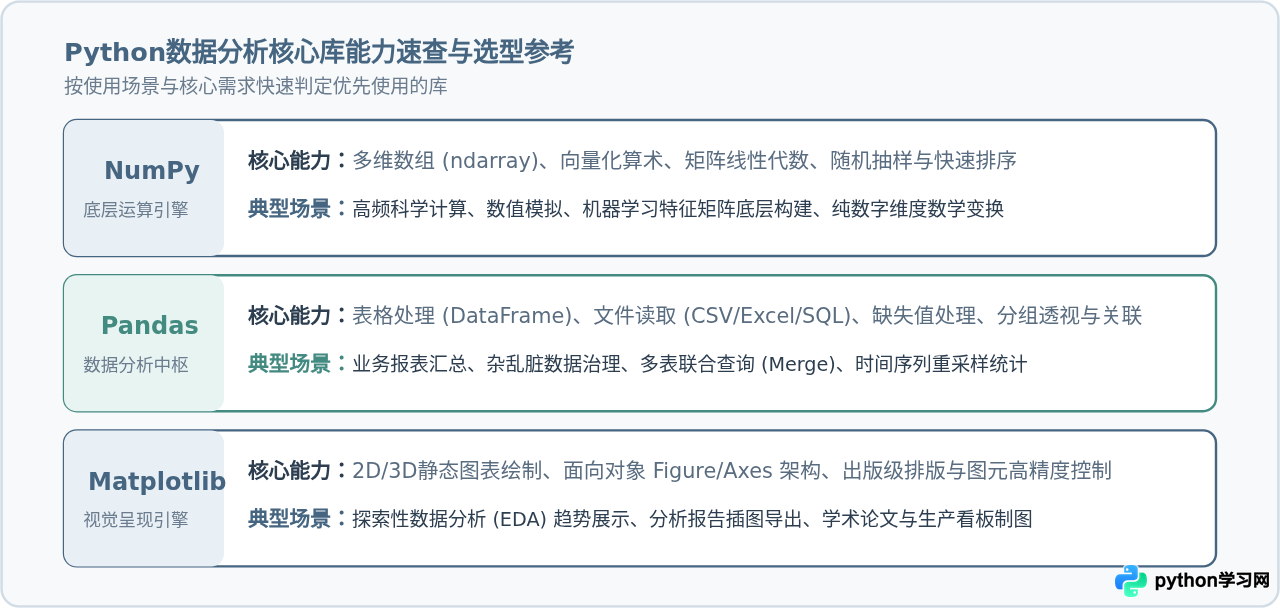
| 库名称 | 主要关注点 | 代表性数据对象 | 最常见配合方式 |
|---|---|---|---|
| NumPy | 同构连续数组的高效计算 | numpy.ndarray |
为 Pandas 和 Matplotlib 提供数值计算底层能力 |
| Pandas | 真实业务表格的清洗加工 | DataFrame、Series |
承上启下,接收数据并汇总,向下输出绘图数据 |
| Matplotlib | 图形排版与视觉结论呈现 | Figure、Axes |
直接接收 NumPy 数组或 Pandas 序列并绘制图表 |
综上所述,Python 数据分析的常规路径是:首先借助 NumPy 理解底层矩阵与数值运算原理;随后以 Pandas 为日常工作主战场完成数据抽取、清洗与聚合加工;最后通过 Matplotlib 绘制规范图表以交付洞察。三个库环环相扣,构成了 Python 数据科学最稳固的基础设施。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















