


Python Pandas中head()函数怎么用:查看DataFrame前几行数据
详细讲解Python Pandas中head()函数的用法与核心原理,涵盖默认参数、指定返回行数、负数参数切片技巧、典型操作流程及与tail()的对比,帮助快速高效检查DataFrame数据。
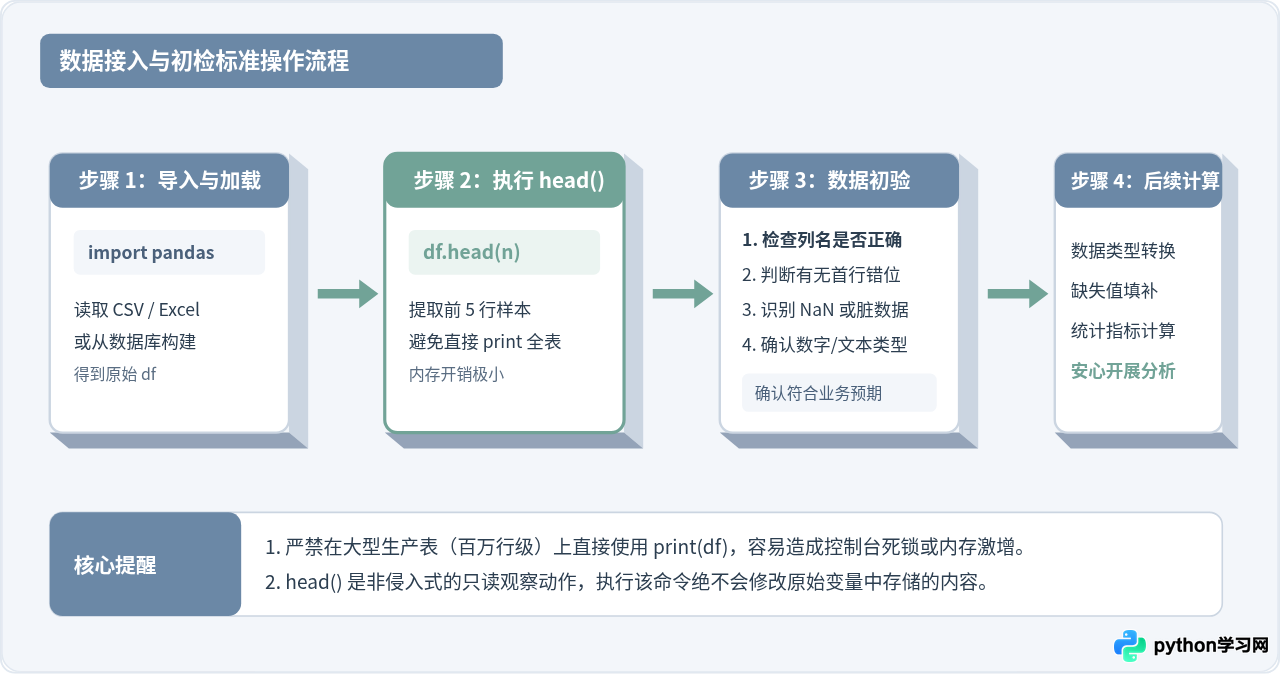
在数据分析和数据清洗流程中,导入或构造好一个 Pandas DataFrame 之后,首要动作通常不是直接计算指标,而是快速观察前几行记录。head() 函数正是为此设计的核心工具:它默认提取数据帧的前 5 行,帮助开发者在不加载或打印全量海量数据的前提下,快速确认列名拼写、数据类型、索引排列以及是否存在异常缺失值。
一、head() 函数的语法规范与核心机制
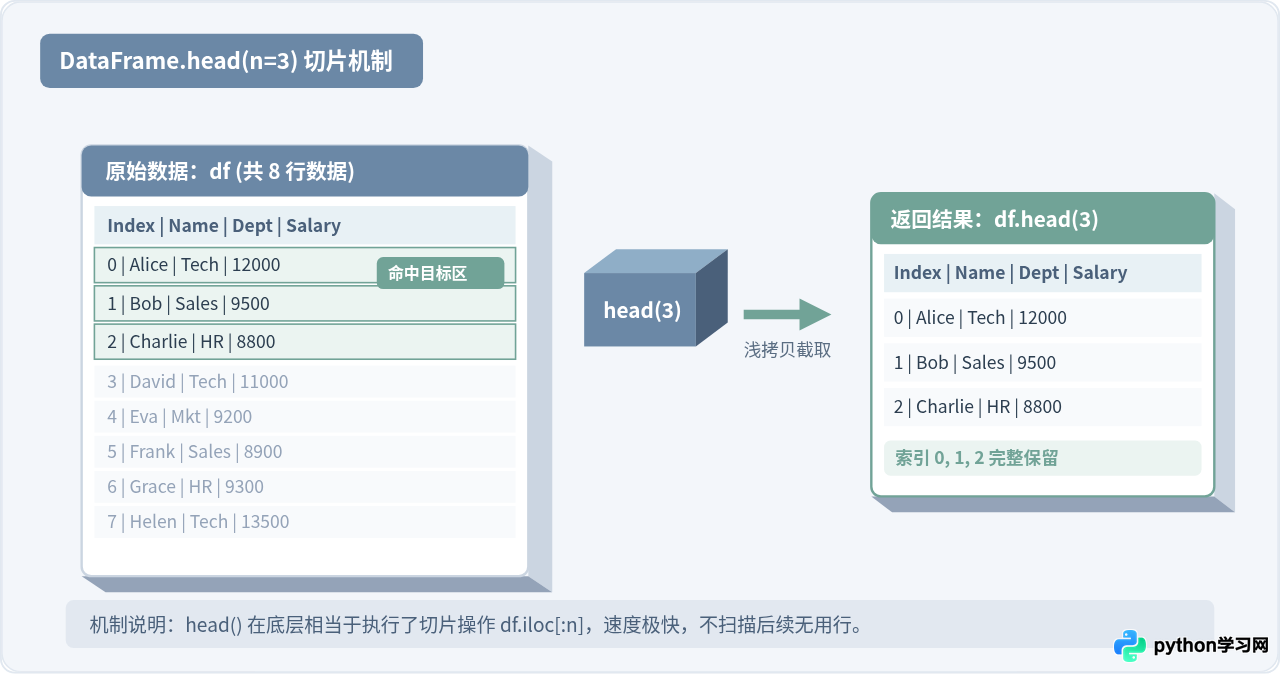
DataFrame.head() 属于 Pandas 的常用检查方法,其底层是通过行切片机制返回目标数据集上部的子集视图或浅拷贝,不会改动原数据帧的物理内容。
DataFrame.head(n=5)该函数的参数极其精简,只有一个可选参数 n:
- n(整数,默认值为 5):指定要返回的行数。若传入正整数,则返回自顶部算起的对应行数;若不传参,则默认返回前 5 行。
- 返回值:返回一个新的 DataFrame(如果作用于 Series 则返回 Series),包含截取出的前几行数据,保留原有行索引(Index)与列名(Columns)。
二、基础操作步骤与代码示例
下面演示在 Python 环境中导入 Pandas,构建示例数据并运用 head() 进行查看的具体操作步骤。
步骤 1:导入模块并构造测试 DataFrame
在 Python 脚本或 Jupyter Notebook 中,先引入 Pandas 库并构建一个具有 7 条记录的员工信息表:
import pandas as pd

# 构造示例数据
data = {
    '姓名': ['张伟', '王芳', '李强', '赵敏', '孙磊', '周杰', '吴桐'],
    '部门': ['技术部', '市场部', '技术部', '运营部', '财务部', '市场部', '技术部'],
    '薪资': [14500, 11000, 15000, 9500, 12000, 10500, 16000],
    '工龄': [3, 2, 4, 1, 3, 2, 5]
}

df = pd.DataFrame(data)
步骤 2:默认调用 head() 查看前 5 行
直接调用 df.head(),不传入任何参数:
# 默认返回前 5 行
preview = df.head()
print(preview)
终端示例输出:
   姓名    部门     薪资  工龄
0  张伟  技术部  14500   3
1  王芳  市场部  11000   2
2  李强  技术部  15000   4
3  赵敏  运营部   9500   1
4  孙磊  财务部  12000   3
可以看到,原本包含 7 行的 DataFrame 仅输出了索引 0 至 4 的前 5 条记录。列名完全对应,行索引依原样输出。
三、进阶传参技巧:自定义行数与负数切片
虽然默认值 n=5 已经能满足绝大多数日常需求,但在需要特定观察范围时,合理利用参数 n 能带来更高的灵活性。
1. 查看指定数量的正向行数(n > 0)
当只需要快速看 2 行或需要看更宽泛的 10 行时,直接在括号中填入正整数:
# 查看前 2 行
print(df.head(2))

# 查看前 10 行(若数据总量不足 10 行,则返回全部现有行,不会报错)
print(df.head(10))注意边界情况:如果 DataFrame 总共只有 7 行,执行 df.head(10) 不会抛出 IndexError,而是宽容地返回所有现存的 7 行。
2. 传入负数参数:排除尾部剩余(n < 0)
很多初学者不知道 head() 接受负整数。当传入负数时,其含义与 Python 原生切片 [:-k] 完全一致,表示:“除了末尾指定的 k 行之外,返回前面的所有数据”。
# 排除末尾的 2 行,获取前面所有的 5 行(7 - 2 = 5)
preview_neg = df.head(-2)
print(preview_neg)
输出结果:
   姓名    部门     薪资  工龄
0  张伟  技术部  14500   3
1  王芳  市场部  11000   2
2  李强  技术部  15000   4
3  赵敏  运营部   9500   1
4  孙磊  财务部  12000   3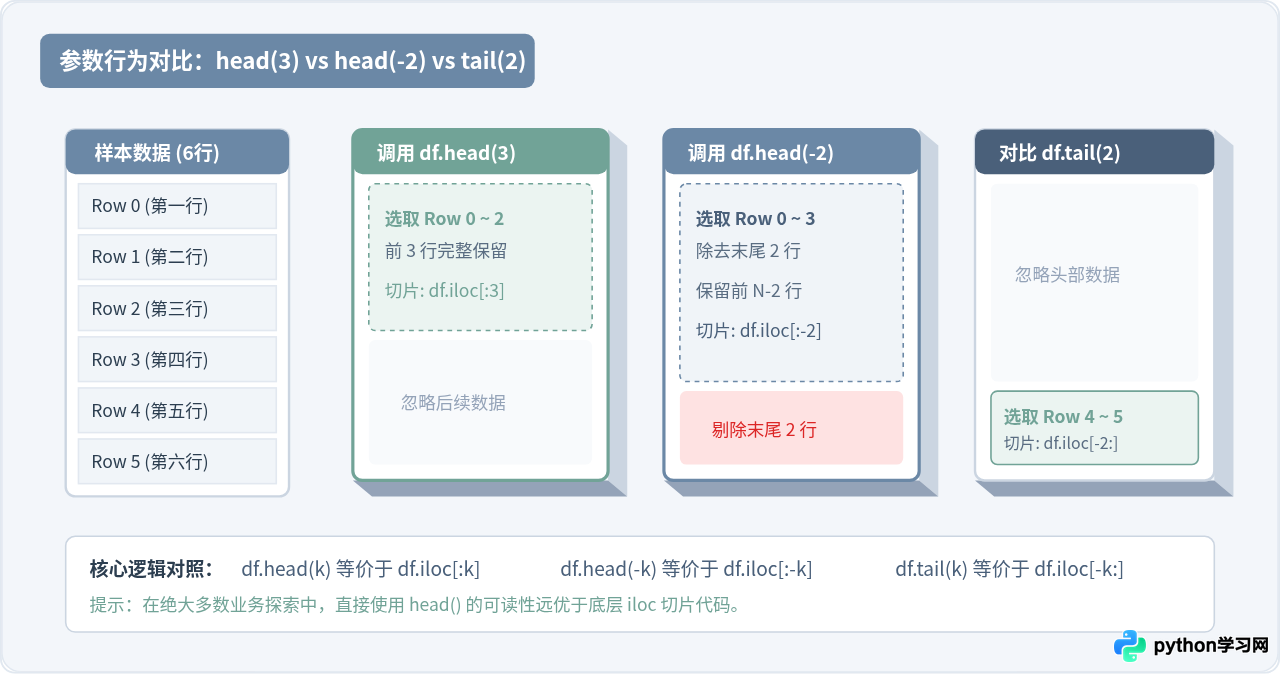
3. 在 Series(单列对象)上使用 head()
head() 不仅可以在整个二维表(DataFrame)上调用,也可以对单一列(Series)调用。这在快速预览某一个特定指标列时非常实用:
# 仅预览“薪资”列的前 3 个数值
salary_preview = df['薪资'].head(3)
print(salary_preview)
输出结果:
0    14500
1    11000
2    15000
Name: 薪资, dtype: int64
四、实际应用与易错点辨析
为了在实际工程中安全、高效地使用 head(),需要明确以下几点核心特性与注意事项:
1. 视图(View)与副本(Copy)问题
避坑指南:df.head() 返回的子集通常是浅拷贝或切片视图。尽量只用它做“查看”或“只读操作”。
如果对 sub_df = df.head(3) 中的某一列进行就地赋值修改(例如 sub_df['薪资'] = 0),Pandas 可能会抛出著名的 SettingWithCopyWarning 警告。若确实需要基于前几行创建新的独立数据集进行操作,应显式调用 .copy():
# 安全创建前几行独立副本
safe_subset = df.head(3).copy()
safe_subset.loc[0, '薪资'] = 20000  # 安全修改,不会影响原 df
2. head() 与直接切片 df[:n] 的差异
在功能上,df.head(n) 和 df.iloc[:n] 完全等价,但推荐优先使用 head() 的原因包括:
- 链式调用更自然:例如
df.sort_values(by='薪资', ascending=False).head(3)可以非常直观地求出“薪资前三名”,语法流畅。 - 语义明确:代码阅读者一眼就能明白这是在提取头部代表性样本,而无需解析切片下标。
3. head() 与 tail()、sample() 的协同配合
| 函数方法 | 查看位置 | 典型适用场景 |
|---|---|---|
df.head(n) |
数据起始头部(前 n 行) | 检查列名、初始排序、字段对齐、第一条记录是否为有效数据 |
df.tail(n) |
数据末尾尾部(后 n 行) | 检查是否包含汇总总计行、文件末尾脏字符、时间序列最新时间戳 |
df.sample(n) |
全表随机抽取 n 行 | 排除头部聚集偏差,全面观察中间分布特征 |
五、全文总结
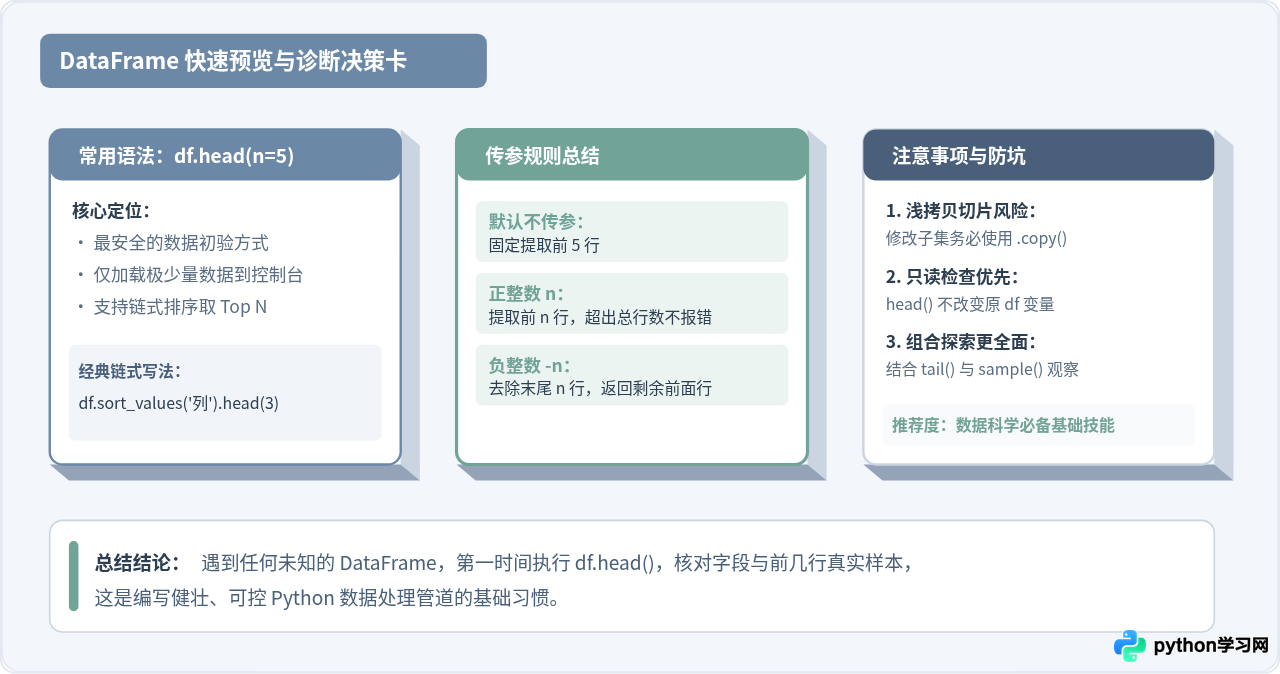
掌握 Pandas 中的 head() 函数并不复杂,其核心要点可以归结为以下三句话:
- 核心功能:用于极速预览 DataFrame 或 Series 的前几行,默认返回 5 行,保护控制台不被海量输出淹没。
- 参数机制:支持正整数直接提取顶部记录,支持负整数剔除尾部记录;超出总行数时自适应返回全部内容,容错率高。
- 工程实践:仅用于只读观察或与排序搭配提取极值;若要对切片结果进行派生修改,记得配合
.copy()保证数据安全。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















