


Python变量存储求和结果时的初始值设置与类型注意
深入解析在Python中利用变量存储求和与累加结果时的初始值设定原则、底层类型演变机制、浮点数精度陷阱及非数值累加注意事项。
在编写 Python 程序处理数据统计、批量计算与业务汇总时,使用变量存储累加求和结果是最基本的操作之一。虽然语法看似简单,但变量初始值的设定以及累加过程中的类型变化直接决定了计算结果的准确性、程序的健壮性与运行效率。如果初始值设置不当,轻则导致结果偏离预期或空数据集统计异常,重则在特定数值边界下触发隐蔽的精度丢失或类型运行时错误。本文将系统梳理 Python 中累加求和变量的初始化规则、底层类型演进机制以及常见避坑要点。
一、累加器变量初始值的设定原则与数学依据
在循环结构或迭代流程中累加数据时,用来记录阶段结果的变量通常被称为“累加器(Accumulator)”。累加器的初始值必须遵循代数运算中的加法单位元(Additive Identity)原则,即对于任何被加数 x,都必须满足 0 + x = x。因此,在常规算术数值累加中,初始值应严格设为 0。
将初始值设为 0 能够直接规避两个最常见的结构性错误:
- 空序列安全性(Empty Sequence Safety):当待处理的集合或列表没有任何元素时,循环体不会执行。此时累加器直接保留初始值,
0准确反映了“没有任何元素时的总和为零”,而不会引发未定义行为或产生脏数据。 - 避免初值污染累加基数:若错误地将初始值预设为序列首项或非零常量(例如习惯性写成
total = 1),一旦未同步跳过首项,就会导致整体计算发生不可逆的偏移(Off-by-One 偏移或偏移基数)。
# 标准数值累加示例:空集安全与加法单位元
numbers = [12, 35, 7, 24]
total = 0  # 显式设定加法单位元 0

for num in numbers:
    total += num

print(f"求和结果: {total}")  # 输出: 78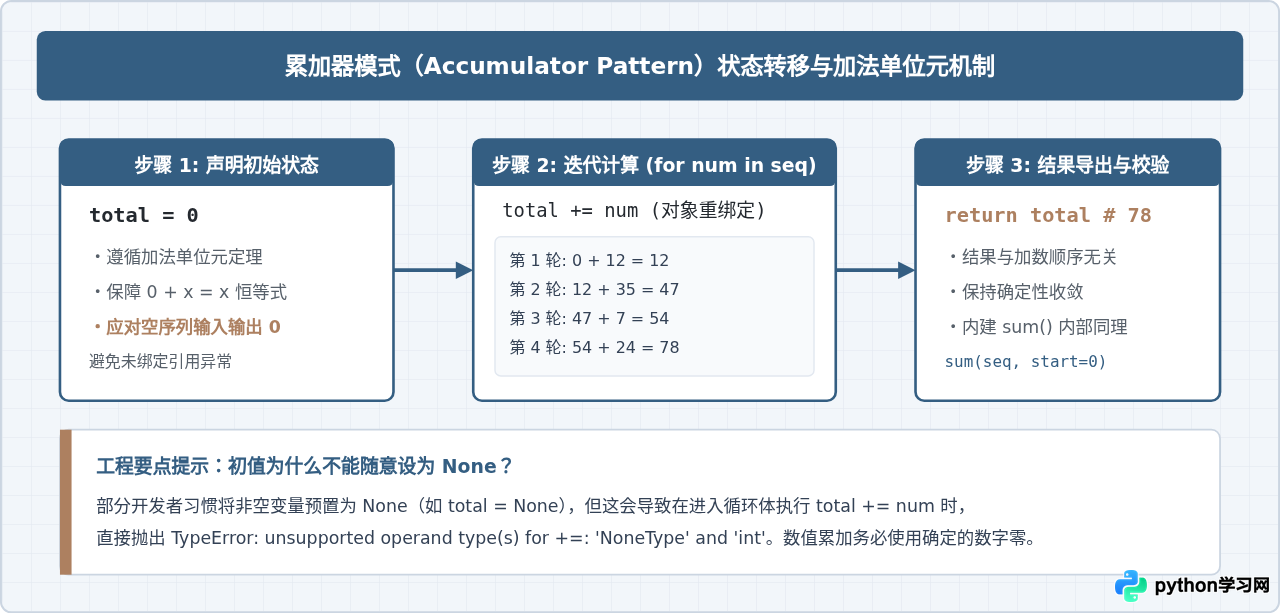
二、初始值类型与累加过程中的类型演变机制
Python 是动态强类型语言。变量本身不具备固有类型,变量名仅仅是对内存中对象的引用。然而,在执行 total += item 时,Python 会根据运算符两侧对象的类型,调用对应的底层魔术方法(如 __iadd__ 或 __add__),并发生类型提升或隐式转换。
1. 整型累加(int):任意精度的安全保障
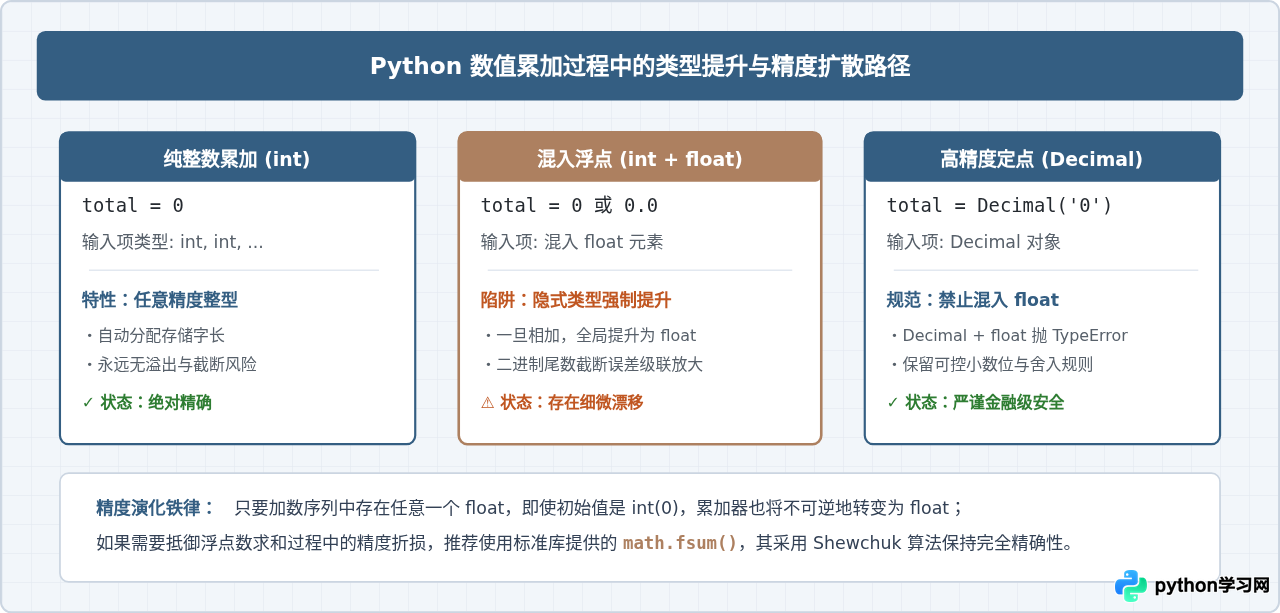
在 Python 3 中,int 类型具有任意精度特性(仅受可用系统内存限制),不会像 C/C++ 或 Java 那样在达到 32 位或 64 位上限后发生整数溢出。如果数据源全部为整数,使用 total = 0 可以自始至终保持 100% 的数学精确性,无需担心大数回绕问题。
2. 浮点型累加(float):初始值与累积误差
当累加序列中包含小数,或者初始值显式写成 total = 0.0 时,Python 会采用 IEEE 754 双精度浮点数存储结果。浮点数在底层以二进制科学计数法存储,这意味着大多数十进制小数(例如 0.1)在转换为二进制时为无限循环小数,只能截断为 53 位二进制尾数。
在连续累加数千或数万个浮点数时,微小的截断误差会随着加法过程被不断放大。更关键的是,浮点加法在数学上不满足严格的结合律:由于大数吞噬小数现象,加法执行的顺序不同,最终计算出的小数位可能会有显著差异。
# 浮点数直接累加的精度丢失现象
total = 0.0
for _ in range(10):
    total += 0.1

print(f"直接累加 10 次 0.1: {total}")  # 输出: 0.9999999999999999 而非 1.0
print(f"相等性判断: {total == 1.0}")   # 输出: False
3. 高精度小数(Decimal)与分数(Fraction)的类型纯度
在电商财务、计费统计与金融结算场景中,必须使用标准库 decimal.Decimal 替代内置 float。此时初始值的类型设置具有严格的排他性:
- 初始值必须声明为
Decimal('0')或Decimal(0),不能使用整数0或浮点0.0作为初始值后随意混加。 - 严禁传入浮点数来构造 Decimal,如
Decimal(0.1)会直接将浮点数的精度缺陷固化,必须使用字符串入参Decimal('0.1')。 - Python 不允许
float与Decimal发生隐式混合加法,二者相加会立即触发TypeError,这种严谨性有助于在开发阶段拦截类型混杂的隐患。
三、非数值对象与容器聚合的求和陷阱
在日常开发中,有时会遇到需要聚合字符串、展平多维列表或合并字典的需求。初学者常尝试套用数值累加的逻辑,但这种做法隐藏着严重的性能瓶颈与类型限制。
1. 为什么不能用 sum() 拼接字符串?
Python 内置的 sum(iterable, /, start=0) 函数在底层对字符串拼接做了显式防御机制。如果尝试执行 sum(['a', 'b', 'c']),Python 会主动抛出异常:
# 尝试对字符串列表求和
words = ["Python", "变量", "求和"]
try:
    result = sum(words)
except TypeError as e:
    print(e)
# 输出: TypeError: sum() can't sum strings [use ''.join(seq) instead]
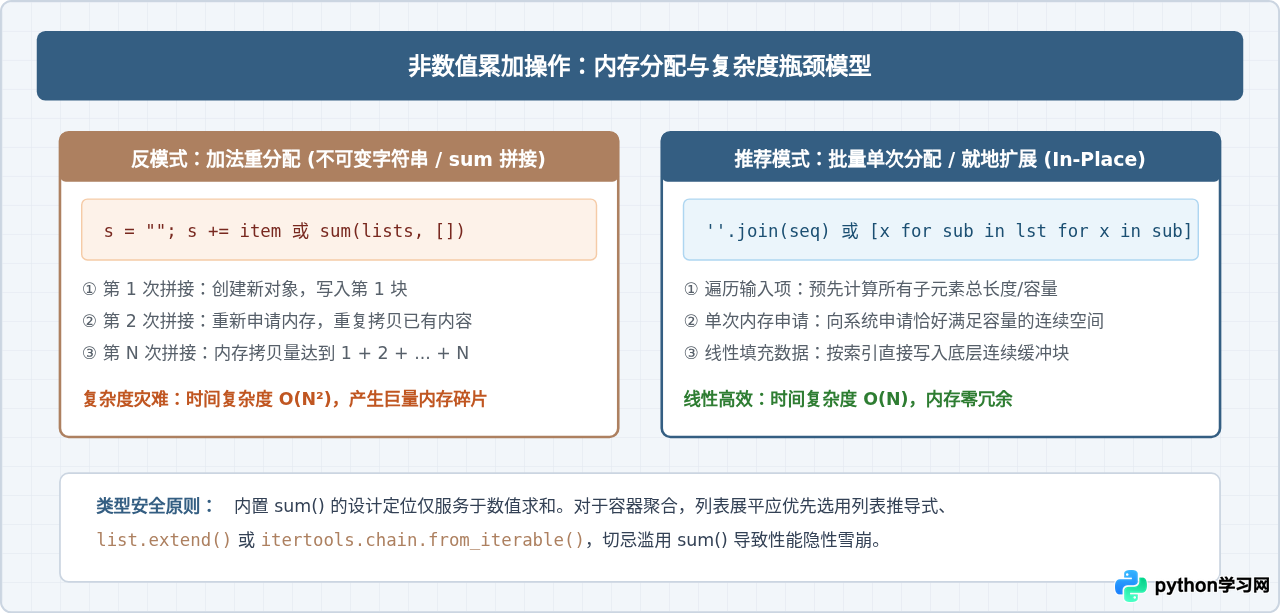
这一限制是出于执行效率的考虑。字符串在 Python 中属于不可变对象(Immutable),如果使用加法累加,每一次 s += item 都必须向系统申请新的内存空间,并将已有字符串全部拷贝一次。累加 $N$ 个字符串的时间复杂度将退化至 $O(N^2)$。官方推荐的做法是始终使用 ''.join(iterable),其通过预先计算总长度实现一次性内存分配,时间复杂度仅为 $O(N)$。
2. 列表展平与 sum(..., []) 的内存开销
虽然 sum() 阻止了字符串相加,但它允许通过设定初始值 start=[] 来合并子列表,例如 sum([[1, 2], [3, 4]], [])。然而这种做法与字符串累加具有相同的 $O(N^2)$ 性能陷阱:每合并一个子列表,Python 都会新建一个列表并拷贝此前所有元素。
四、常见开发错误与最佳工程实践
在工程实践中,累加求和逻辑若想达到健壮无误,还需要特别警惕以下几个经典错误:
1. 作用域泄露与脏初值残留
在嵌套循环或批量批次统计时,如果在内层循环开始前遗漏了重置初值语句,累加器就会持续携带上一轮循环的残留值,造成跨批次的数据叠加污染:
# 错误示例:批次求和时未在内层循环重置初始值
batches = [[1, 2, 3], [4, 5], [6, 7, 8]]
total = 0  # 错误:定义在外部,各批次未独立重置

for batch in batches:
    for item in batch:
        total += item
    print(f"批次小计: {total}")  # 输出递增的累积总和,而非单个批次总和
2. 生成器与迭代器消耗后无法二次求和
当数据源来自于生成器表达式(Generator Expression)或文件流读取器时,迭代器是一次性消耗品。如果先用 sum() 计算了总和,后续若再想求均值或校验数量,该迭代器已处于耗尽状态,二次迭代将直接返回 0。
3. 浮点求和中的科学解法:math.fsum
如果业务场景必须对长序列的小数执行求和,标准库的 math.fsum() 是综合性能与精度的最优选择。它内部维持着一个累积和跟踪表,对中间相加的有效位做精确校准,彻底消除了常规 sum() 在处理浮点数时产生的舍入漂移。
import math

float_seq = [0.1] * 10
print(sum(float_seq))        # 0.9999999999999999 (有微小误差)
print(math.fsum(float_seq))   # 1.0 (完全精确)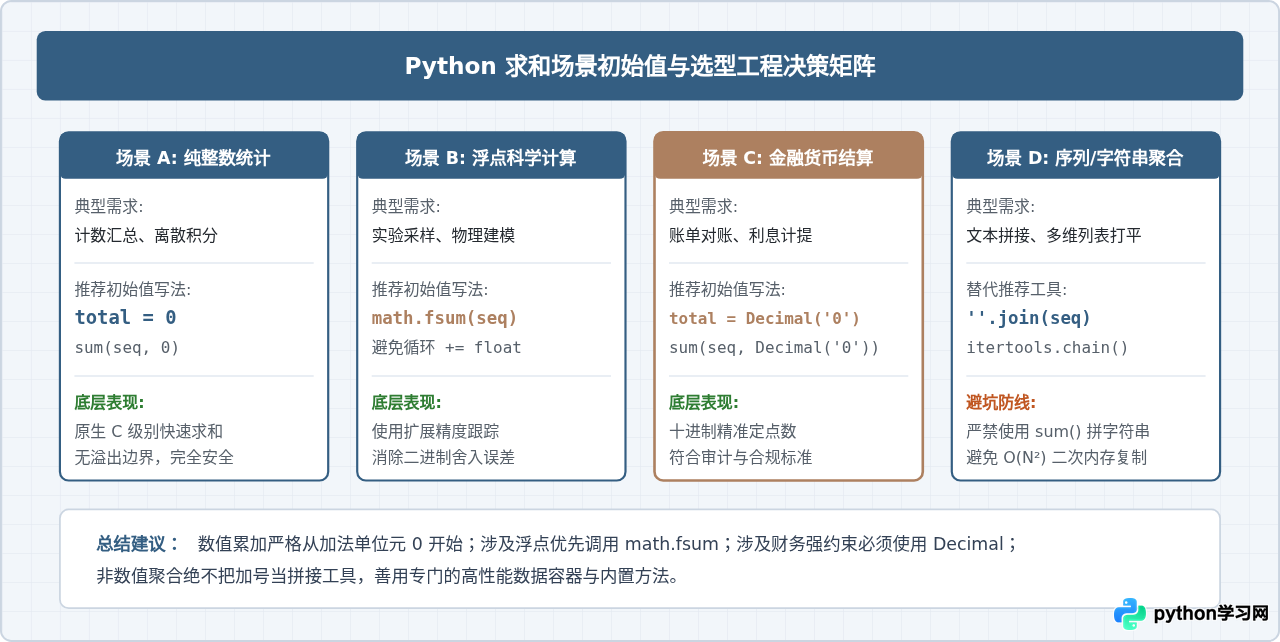
五、核心要点总结对照
为了便于在日常编写与代码审查中快速核对,下表列出了不同数据场景下的初始值设定规范及注意事项:
| 求和数据类型 | 推荐初始值设置 | 底层类型演变规律 | 核心防范风险与最佳实践 |
|---|---|---|---|
| 纯整数 (int) | total = 0 或 sum(seq) |
始终保持 int,支持无限长整数 |
避免误用 None 作为初始值;空序列时能够安全返回 0。 |
| 常规浮点数 (float) | math.fsum(seq) |
全过程维持 float(IEEE 754 双精度) |
普通 += 会逐级放大二进制舍入截断误差,严谨计算务必使用 math.fsum。 |
| 金融货币 (Decimal) | total = Decimal('0') |
严格保持 Decimal |
严禁混入 float;传参构造时必须使用字符串格式(如 Decimal('19.9'))。 |
| 字符串 (str) | 不可使用累加求和 | 禁止使用 sum() |
始终使用 ''.join(seq),避免 $O(N^2)$ 内存频繁重新分配与拷贝。 |
| 嵌套子列表 (list) | 推荐推导式或 extend() |
避免 sum(seq, []) |
sum(..., []) 会导致每轮重新申请列表并拷贝旧数据,海量数据时性能极差。 |
在 Python 中设定求和变量的初始值,远不止是一行简单的 total = 0。明确加法单位元的数学本质、时刻保持对底层类型提升与精度传播的敏感度,并在不同业务场景下选用最匹配的数据类型和内置工具,是编写高质量、高可靠 Python 代码的基石。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















