


Python电商销售数据分析实战:从数据清洗到可视化洞察
本文以电商订单交易数据为例,系统讲解使用Python完成数据加载、缺失与异常值清洗、指标聚合计算、RFM分群以及业务可视化的完整实战流程。
本文以一组包含真实业务特征的电商交易流水数据为基准,拆解数据加载、脏数据清洗、维度指标构建、RFM客户分群以及业务图表呈现的完整操作链路,帮助读者建立端到端的Python数据分析处理能力。
1. 业务场景与数据流转全貌
在电商实际运营中,原始业务数据库(如MySQL或日志采集器)导出的数据往往充斥着测试账号生成的零元单、退款冲红记录、用户未填写的区域信息以及非标准的时间戳字符串。分析师的工作并非直接作图,而是将不符合统计口径的噪音剔除,加工出符合财务与运营分析规范的干净数据集。
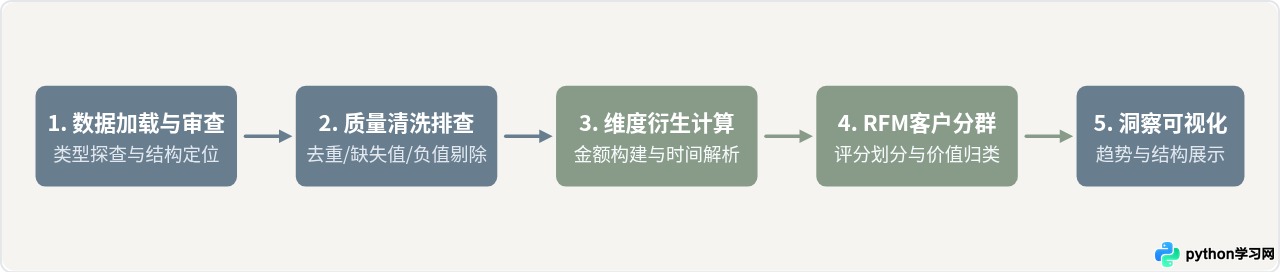
整个实战流程遵循严密的执行时序,各个环节前后依赖,如下方流程图所示:
2. 准备运行环境与载入原始数据
完成本分析需依托 Python 核心数据科学栈。在终端中安装必要依赖:
pip install pandas numpy matplotlib seaborn openpyxl我们以典型的交易明细记录为例,字段包括:订单号(order_id)、用户标识(user_id)、购买时间(order_date)、品类(category)、销售单价(unit_price)、购买数量(quantity)以及收货省份(province)。执行基础加载和字段类型探查:
import pandas as pd
import numpy as np

# 模拟载入数据,保持业务中常见的脏数据特征
raw_data = {
    'order_id': ['E001', 'E002', 'E003', 'E004', 'E005', 'E005', 'E006', 'E007'],
    'user_id': ['U101', 'U102', 'U103', 'U101', 'U104', 'U104', 'U105', 'U106'],
    'order_date': ['2026-01-05', '2026-01-12', '2026-02-01', '2026-02-15', '2026-02-18', '2026-02-18', '2026-03-02', '2026-03-10'],
    'category': ['数码配件', '家居日用', '数码配件', '服饰鞋包', '生鲜食品', '生鲜食品', '美妆个护', None],
    'unit_price': [120.0, 45.0, 399.0, 0.0, 88.0, 88.0, -50.0, 199.0],
    'quantity': [2, 1, -1, 3, 2, 2, 1, 1],
    'province': ['广东', '浙江', '上海', '北京', None, None, '四川', '江苏']
}

df = pd.DataFrame(raw_data)
print("--- 原始数据摘要 ---")
df.info()Data columns (total 7 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 order_id 8 non-null object
1 user_id 8 non-null object
2 order_date 8 non-null object
3 category 7 non-null object
4 unit_price 8 non-null float64
5 quantity 8 non-null int64
6 province 6 non-null object
3. 数据清洗的核心手段:删除还是填补?
在数据清洗环节,面对缺失值和异常值,初学者常面临两难抉择:是直接调用 dropna() 一键剔除,还是通过众数或平均值填补?两者的选择取决于字段的业务属性和统计目标。
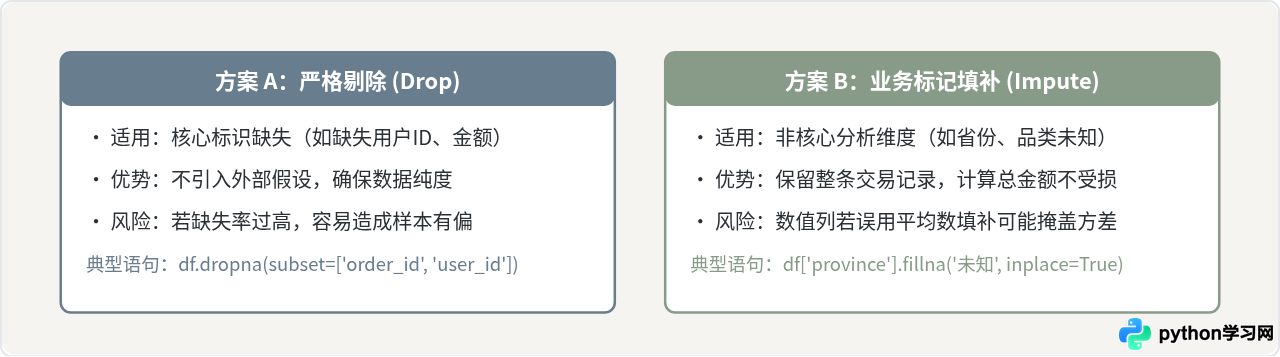
基于上述差异,我们在本例中采取针对性清洗:
- 重复记录处理:全字段重复的记录通常源于接口重发或重复导出,使用
drop_duplicates()直接清除。 - 非合理交易值过滤:单价
unit_price <= 0或购买数量quantity <= 0通常为退款冲正或测试刷单,若本次分析重点是实际成交额与健康度,需将其过滤。 - 维度分类缺失处理:对于省份、类别列的缺失,采用
fillna('未知')保持总行数与总销售流水不丢失。 - 日期格式化:将字符串型字段转换为
datetime64类型,方便后续按月份和天数提取时间指标。
# 1. 剔除完全重复的数据行
df_clean = df.drop_duplicates().copy()

# 2. 过滤异常业务值(必须保留正向有效交易)
df_clean = df_clean[(df_clean['unit_price'] > 0) & (df_clean['quantity'] > 0)]

# 3. 填补缺失属性
df_clean['category'] = df_clean['category'].fillna('未知类目')
df_clean['province'] = df_clean['province'].fillna('未知省份')

# 4. 转换时间字段并生成衍生指标
df_clean['order_date'] = pd.to_datetime(df_clean['order_date'])
df_clean['sales_amount'] = df_clean['unit_price'] * df_clean['quantity']
df_clean['order_month'] = df_clean['order_date'].dt.to_period('M')

print("--- 清洗后的有效数据集 ---")
print(df_clean[['order_id', 'user_id', 'order_date', 'category', 'sales_amount', 'province']])order_id user_id order_date category sales_amount province
0 E001 U101 2026-01-05 数码配件 240.0 广东
1 E002 U102 2026-01-12 家居日用 45.0 浙江
4 E005 U104 2026-02-18 生鲜食品 176.0 未知省份
7 E007 U106 2026-03-10 未知类目 199.0 江苏
df_clean.reset_index(drop=True, inplace=True) 重置自然索引,防止后续基于行号(iloc)批量处理时引发越界或对齐错误。
4. 业务指标建模:客户RFM价值分群
在电商分析中,单一的“总消费额”无法有效区分偶尔大单采购的散客与高频复购的忠实用户。RFM 模型通过三个核心维度,将客户划分为清晰的价值梯度:
- R (Recency) 最近一次消费间隔:最后一次订单距离分析基准日期的天数。天数越少,客户活跃度越高。
- F (Frequency) 消费频率:在统计周期内的独立订单次数。频次越高,品牌依赖越强。
- M (Monetary) 累计消费金额:在周期内的总贡献流水。金额越大,经济价值越高。
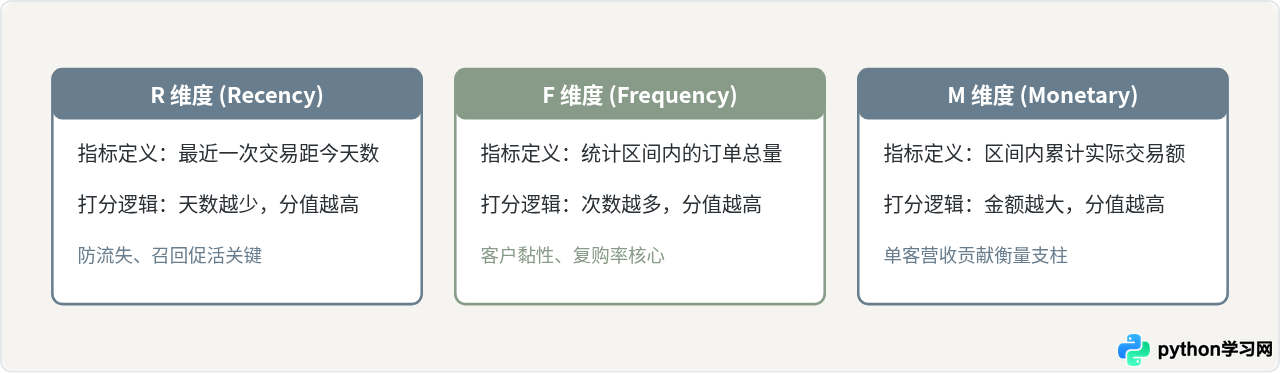
利用 Pandas 提供的聚合操作,我们很容易从交易表中提炼出以客户为维度的统计汇总:
# 设定分析基准时间(以最晚业务日期加一天作为参考锚点)
analysis_date = df_clean['order_date'].max() + pd.Timedelta(days=1)

# 按用户聚合 RFM 基础量
rfm = df_clean.groupby('user_id').agg({
    'order_date': lambda x: (analysis_date - x.max()).days, # R: 间隔天数
    'order_id': 'nunique',                                  # F: 订单总次数
    'sales_amount': 'sum'                                   # M: 累计金额
}).reset_index()

rfm.rename(columns={
    'order_date': 'Recency',
    'order_id': 'Frequency',
    'sales_amount': 'Monetary'
}, inplace=True)

# 与平均值对比,高于平均记为1,低于记为0
rfm['R_Score'] = np.where(rfm['Recency'] <= rfm['Recency'].mean(), 1, 0)
rfm['F_Score'] = np.where(rfm['Frequency'] >= rfm['Frequency'].mean(), 1, 0)
rfm['M_Score'] = np.where(rfm['Monetary'] >= rfm['Monetary'].mean(), 1, 0)

# 定义分类函数
def segment_customer(row):
    score = f"{row['R_Score']}{row['F_Score']}{row['M_Score']}"
    if score == '111':
        return '重要价值客户'
    elif score == '101':
        return '重要发展客户'
    elif score == '011':
        return '重要保持客户'
    elif score == '001':
        return '重要挽留客户'
    else:
        return '一般低价值客户'

rfm['Customer_Tag'] = rfm.apply(segment_customer, axis=1)
print(rfm[['user_id', 'Recency', 'Frequency', 'Monetary', 'Customer_Tag']])
5. 数据可视化洞察实操
清洗与建模完成后,需要将结果转化为图表。在电商领域,常规汇报最关注两类视角:宏观趋势(月度销售走势)与结构构成(品类销售分布与客户画像)。
5.1 基础设置与中文支持
Matplotlib 在默认情况下可能会将中文字符渲染为空白方块(Tofu block)。在绘图前应明确指定支持的中文字体:
import matplotlib.pyplot as plt
import seaborn as sns

# 针对中文字符设置字体回退支持
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei', 'sans-serif']
plt.rcParams['axes.unicode_minus'] = False  # 正常显示负号
5.2 绘制月度销售趋势与品类分布
以下代码一次性生成月度趋势折线图和品类占比条形图,并输出整洁的可视化布局:
# 1. 计算月度趋势
monthly_sales = df_clean.groupby(df_clean['order_date'].dt.strftime('%Y-%m'))['sales_amount'].sum()

# 2. 计算类目销售
cat_sales = df_clean.groupby('category')['sales_amount'].sum().sort_values(ascending=False)

# 创建画布
fig, axes = plt.subplots(1, 2, figsize=(14, 5))

# 趋势折线图
axes[0].plot(monthly_sales.index, monthly_sales.values, marker='o', color='#687D8D', linewidth=2.5)
axes[0].set_title('2026年第一季度月度销售额走势', fontsize=13, pad=12)
axes[0].set_ylabel('销售金额 (元)', fontsize=11)
axes[0].grid(True, linestyle='--', alpha=0.5)

# 品类条形图
sns.barplot(x=cat_sales.values, y=cat_sales.index, ax=axes[1], palette=['#687D8D', '#879B88', '#B0BEC5', '#CFD8DC'])
axes[1].set_title('各商品品类总销售金额排名', fontsize=13, pad=12)
axes[1].set_xlabel('销售金额 (元)', fontsize=11)

plt.tight_layout()
plt.show()
通过组合图表,运营人员可以快速察觉两项核心事实:一是月度流水波动的节律点,明确营收主要爆发的月份;二是品类集约度,识别出哪些类目是主要的利润压舱石,哪些类目存在长尾或库存周转隐患。
6. 全流程总结与复盘清单
完成一次标准的电商数据分析实战,其重点往往不在于使用多么高深的机器学习模型,而在于清洗逻辑的严密性与指标与业务的对应程度。下表归纳了项目各阶段的标准交付产物与关键检查点:
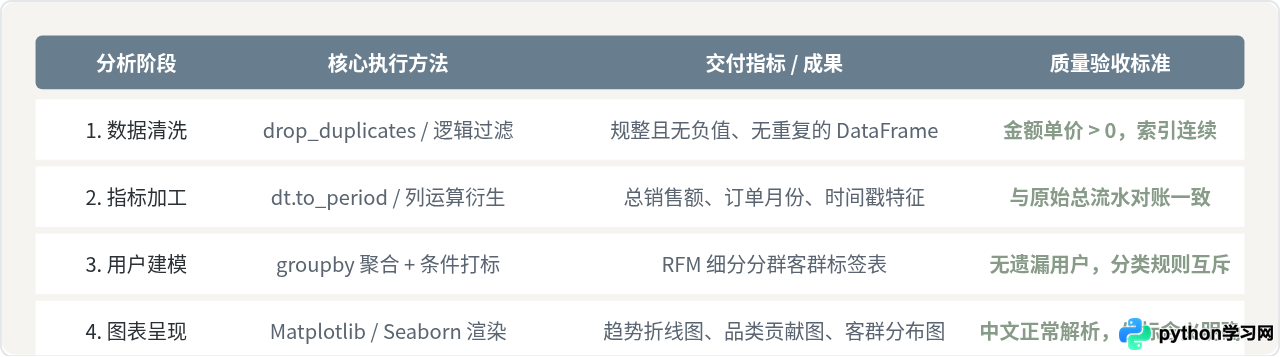
在日常业务落地中,只要按照此体系建立清洗脚本(ETL)、核心聚合指标函数(Metrics)与固定画图模板(Dashboards),即使数据规模从几百行扩展至上百万行,分析体系依然能够保持清晰、健壮且易于复现。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















