


python必背源代码async/await协程代码
本文梳理掌握Python async/await协程必背的核心源代码,涵盖基础启动生命周期、TaskGroup结构化并发、超时熔断控制、信号量限流以及阻塞解耦,配以清晰的架构原理图与实战注意事项。
编写 Python 高并发网络爬虫、API 服务与异步 I/O 应用时,async/await 协程机制是解决并发瓶颈的核心工具。协程利用单线程内的事件循环(Event Loop),在等待网络响应或文件读写时主动让出 CPU 控制权,从而在极低内存占用下支撑成千上万个并发连接。本文精选了掌握 Python 协程必须熟练默写的 5 大经典场景核心源码,逐一拆解基础启动、并发编排、超时熔断、流量控制及阻塞解耦的最佳实践。
一、协程的本质与事件循环调度原理
初学者最容易产生的一个误解是:认为用 async def 定义的函数可以直接像普通函数一样调用。但在 Python 中,直接调用协程函数只会返回一个处于挂起状态的 coroutine 对象,函数内部的代码一行都不会执行。
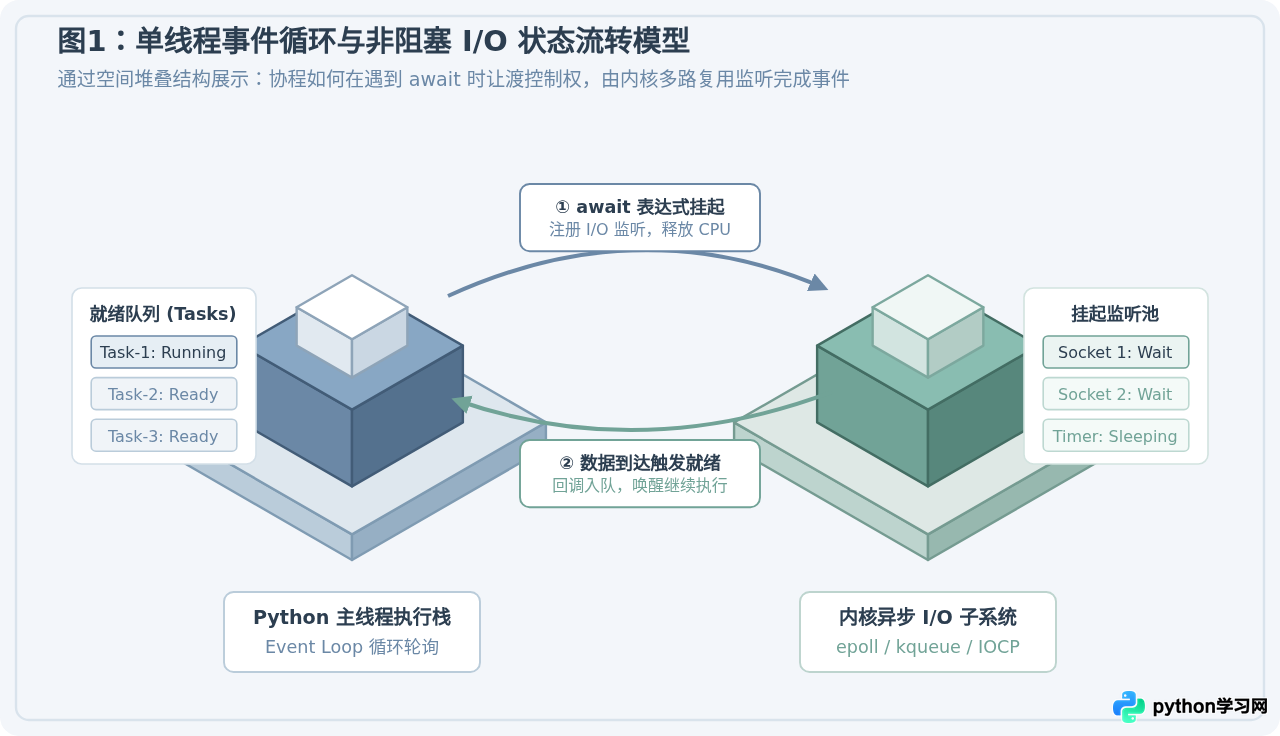
协程必须被提交到“事件循环”(Event Loop)中注册为任务(Task)才会真正运转。事件循环好比一个不间断运行的调度器:当某个协程执行到 await 表达式时,如果底层的网络 I/O 尚未就绪,该协程会主动把 CPU 运行权让还给事件循环,事件循环立即转去执行其他处于就绪状态的协程;一旦底层数据包到达,操作系统通知事件循环,原协程就会在上次让出的断点处无缝恢复运行。
二、必背核心代码 1:基础协程定义与标准生命周期管理
在 Python 3.7+ 中,启动顶级协程的唯一推荐标准方式是 asyncio.run()。它会自动创建全新的事件循环、运行传入的根协程直到返回、妥善取消未完成的残留任务,并在退出时完整关闭事件循环与底层异步生成器。
import asyncio

# 1. 使用 async def 定义协程函数
async def fetch_data(item_id: int) -> dict:
    print(f"[任务 {item_id}] 开始请求远端数据...")
    # await 模拟非阻塞 I/O(不能使用同步的 time.sleep)
    await asyncio.sleep(1.0)
    print(f"[任务 {item_id}] 数据抓取完成!")
    return {"id": item_id, "status": "success"}

# 2. 定义业务主入口协程
async def main():
    # 使用 await 挂起当前协程并等待结果返回
    result = await fetch_data(101)
    print("收到主程序处理结果:", result)

# 3. 标准生命周期启动函数(Python 3.7+ 唯一推荐主入口)
if __name__ == "__main__":
    asyncio.run(main())
[任务 101] 数据抓取完成!
收到主程序处理结果: {'id': 101, 'status': 'success'}
await 只能写在 async def 函数的内部。如果尝试在普通同步函数中直接写 await,Python 解释器会在语法解析阶段直接抛出 SyntaxError: 'await' outside async function。
三、必背核心代码 2:现代结构化并发编排(TaskGroup 与 gather)
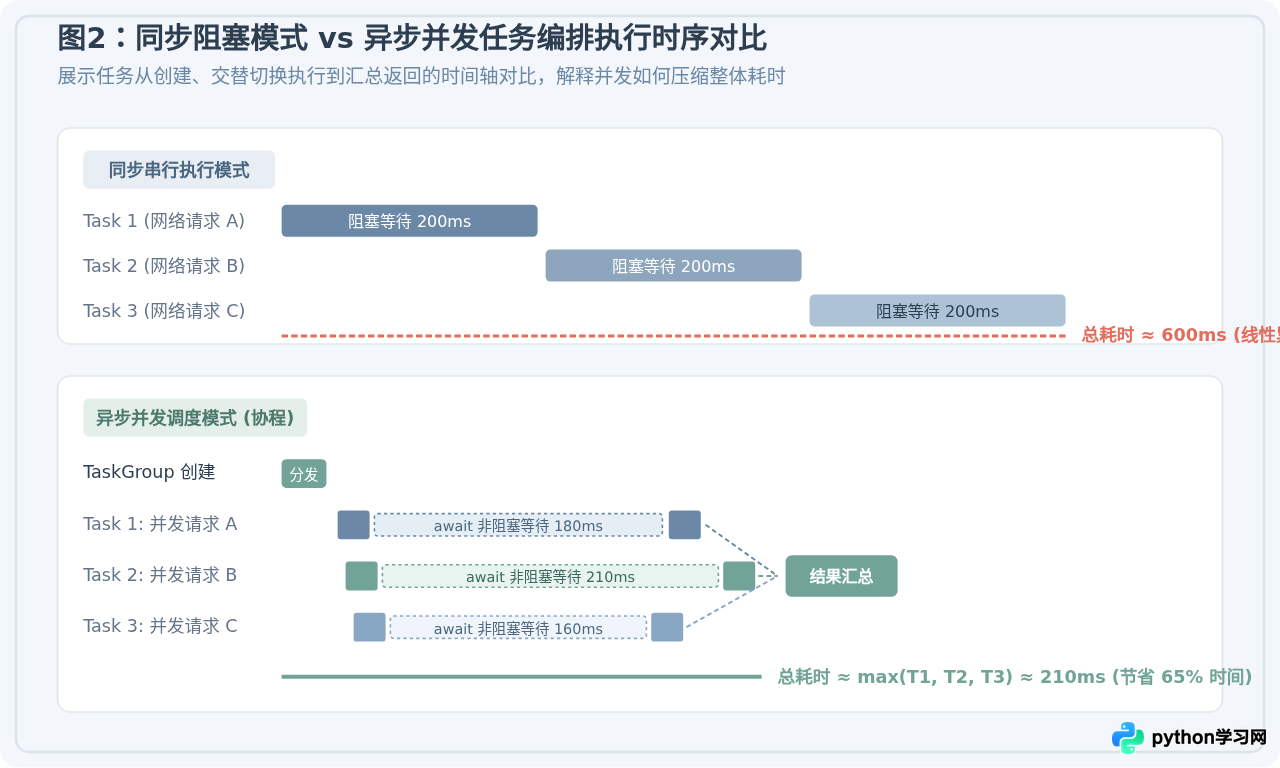
单独按顺序执行多个 await 并不能发挥协程的并发优势——如果依次执行三次等待 1 秒的协程,总耗时依然是 3 秒。要实现真正的“并发执行”,必须将多个协程同时注册到事件循环中并发推进。
在代码组织上,Python 提供了两种主要编排工具:
asyncio.TaskGroup(Python 3.11+ 首选推荐):提供结构化并发(Structured Concurrency)。它作为异步上下文管理器使用,一旦组内任意一个任务抛出未捕获异常,其余所有正在运行的任务都会被立即自动取消,从根本上防止任务悬空泄漏。asyncio.gather(经典兼容方案):接收可变数量的协程,并发启动后按传入顺序将所有执行结果打包成列表统一返回。
1. 现代化方案:asyncio.TaskGroup(推荐)
import asyncio
import time

async def worker(task_name: str, delay: float) -> str:
    print(f"[{task_name}] 开始执行,预估耗时 {delay}s")
    await asyncio.sleep(delay)
    print(f"[{task_name}] 执行完毕")
    return f"{task_name}_done"

async def main():
    start_time = time.perf_counter()
    tasks = []

    # 使用 TaskGroup 管理任务组生命周期
    async with asyncio.TaskGroup() as tg:
        # tg.create_task 会立即将协程封装为 Task 并提交至事件循环并发运行
        t1 = tg.create_task(worker("Task-A", 1.5))
        t2 = tg.create_task(worker("Task-B", 0.8))
        t3 = tg.create_task(worker("Task-C", 1.2))
        tasks.extend([t1, t2, t3])

    # 退出上下文管理器时,所有任务已全部完成
    results = [t.result() for t in tasks]
    total_time = time.perf_counter() - start_time
    print("并发聚合结果:", results)
    print(f"总耗时: {total_time:.2f} 秒 (以最长子任务 1.5s 为准,而非 3.5s)")

if __name__ == "__main__":
    asyncio.run(main())
[Task-B] 开始执行,预估耗时 0.8s
[Task-C] 开始执行,预估耗时 1.2s
[Task-B] 执行完毕
[Task-C] 执行完毕
[Task-A] 执行完毕
并发聚合结果: ['Task-A_done', 'Task-B_done', 'Task-C_done']
总耗时: 1.50 秒 (以最长子任务 1.5s 为准,而非 3.5s)
2. 经典方案:asyncio.gather 批量收集
import asyncio

async def fetch_api(endpoint: str) -> str:
    await asyncio.sleep(0.5)
    return f"Response from {endpoint}"

async def main():
    endpoints = ["/users", "/orders", "/products"]

    # 构造协程列表并通过解包操作 (*) 传入 gather
    # return_exceptions=True 可以确保即使某个任务报错,其他任务正常返回且不中断程序
    results = await asyncio.gather(
        *(fetch_api(ep) for ep in endpoints),
        return_exceptions=True
    )
    print("批量拉取结果集:", results)

if __name__ == "__main__":
    asyncio.run(main())
四、必背核心代码 3:超时熔断与异常保护(wait_for)
网络通信存在不可控性,任何远端 API 请求都有可能遭遇网络丢包、服务端死锁或慢响应。如果不加限制地等待,某个挂起的协程将永久占用连接资源。
使用 asyncio.wait_for(coro, timeout=秒数) 可以在指定时间内等待协程结果;一旦超时,系统会自动向底层协程发送 CancelledError 终止执行,并向外抛出 TimeoutError。
import asyncio

async def slow_network_request() -> str:
    print("正在连接远端网关...")
    # 模拟耗时 5 秒的长连接请求
    await asyncio.sleep(5.0)
    return "成功获取数据"

async def main():
    try:
        # 设置最大超时阈值为 2.0 秒
        result = await asyncio.wait_for(slow_network_request(), timeout=2.0)
        print("请求成功:", result)
    except TimeoutError:
        # 注意:Python 3.11+ 中 TimeoutError 与 asyncio.TimeoutError 已统一
        print("[超时拦截] 网络请求耗时超过 2 秒限制,任务已被强制取消并安全回收!")

if __name__ == "__main__":
    asyncio.run(main())
[超时拦截] 网络请求耗时超过 2 秒限制,任务已被强制取消并安全回收!
五、必背核心代码 4:高并发流量限流(asyncio.Semaphore)
在爬虫抓取、数据库写入或微服务调用中,“并发度越大越快”是一个严重的误区。如果瞬间发起 5000 个 HTTP 请求,会导致操作系统打开的文件描述符(fd)耗尽抛出 OSError: Too many open files,或者直接触发目标服务器的反爬与熔断封禁(HTTP 429 Too Many Requests)。
使用 asyncio.Semaphore(value) 信号量可以像控制停车场车位一样,严格限定当前同时处于执行状态的协程数量上限。
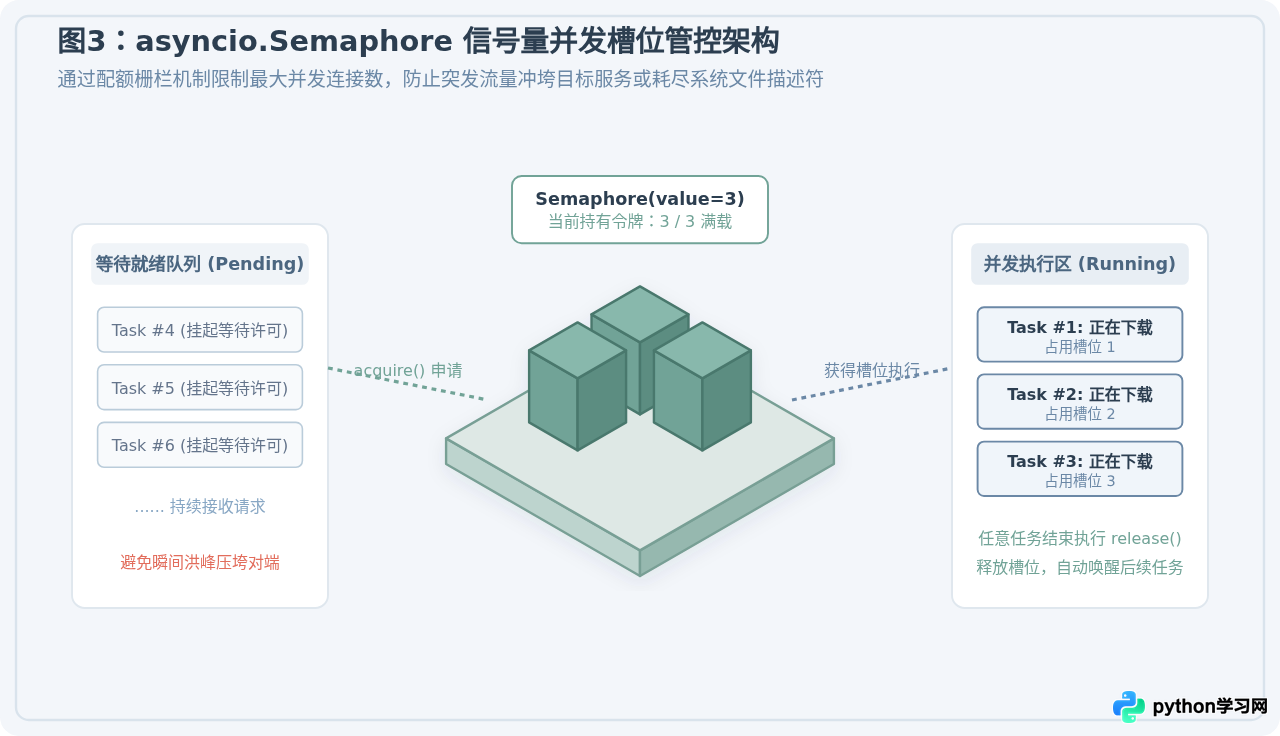
import asyncio

# 限制最多只允许 3 个协程同时处于活跃执行状态
semaphore = asyncio.Semaphore(3)

async def limited_worker(worker_id: int):
    # 使用 async with 语法自动申请 (acquire) 与释放 (release) 信号量槽位
    async with semaphore:
        print(f"[槽位占用] 任务 {worker_id} 获得执行权,开始下载...")
        await asyncio.sleep(1.0)
        print(f"[槽位释放] 任务 {worker_id} 下载完毕,释放配额。")
        return f"Worker_{worker_id}_OK"

async def main():
    # 模拟同时产生 9 个突发网络任务
    tasks = [limited_worker(i) for i in range(1, 10)]
    # 虽然一次性调度 9 个任务,但由于 Semaphore 约束,会以 3 个为一组分批推进
    results = await asyncio.gather(*tasks)
    print("全部限流任务处理完成,样本数:", len(results))

if __name__ == "__main__":
    asyncio.run(main())
[槽位占用] 任务 2 获得执行权,开始下载...
[槽位占用] 任务 3 获得执行权,开始下载...
[槽位释放] 任务 1 下载完毕,释放配额。
[槽位释放] 任务 2 下载完毕,释放配额。
[槽位释放] 任务 3 下载完毕,释放配额。
[槽位占用] 任务 4 获得执行权,开始下载...
[槽位占用] 任务 5 获得执行权,开始下载...
[槽位占用] 任务 6 获得执行权,开始下载...
... (其余任务顺次推进)
全部限流任务处理完成,样本数: 9
六、必背核心代码 5:异步资源管理与流式迭代(async with / async for)
异步编程中同样需要保证网络 Session 连接池、数据库事务或文件句柄的平稳关闭。Python 提供了专门的 async with(异步上下文管理器)与 async for(异步迭代器)协议。
import asyncio

# 1. 自定义异步上下文管理器(实现 __aenter__ 与 __aexit__)
class AsyncDatabaseConnection:
    def __init__(self, dsn: str):
        self.dsn = dsn

    async def __aenter__(self):
        print(f"[DB] 正在建立异步连接池: {self.dsn}")
        await asyncio.sleep(0.2)
        print("[DB] 连接成功建立")
        return self

    async def __aexit__(self, exc_type, exc_val, exc_tb):
        print("[DB] 正在安全回收数据库连接并归还连接池...")
        await asyncio.sleep(0.1)
        print("[DB] 连接池回收完毕")

# 2. 自定义异步生成器(使用 async def 与 yield)
async def async_data_stream(total_batches: int):
    for batch_id in range(1, total_batches + 1):
        await asyncio.sleep(0.3)  # 模拟分批拉取网络流
        yield f"Data_Chunk_{batch_id}"

async def main():
    # 使用 async with 确保连接即使异常也能可靠释放
    async with AsyncDatabaseConnection("postgresql://user:pass@localhost:5432/app") as db:
        print("[业务] 开始流式消费远端数据块...")
        # 使用 async for 逐批消费异步流,避免一次性将海量数据载入内存
        async for chunk in async_data_stream(3):
            print(f" -> 实时处理数据块: {chunk}")

if __name__ == "__main__":
    asyncio.run(main())
七、混合编程解阻塞:使用 asyncio.to_thread 防止事件循环假死
这是异步编程中最致命的隐形陷阱:单线程事件循环最怕被同步阻塞代码硬性卡死。如果在协程函数内部直接调用了同步库(例如 requests.get()、time.sleep() 或复杂的图像计算),整个 Python 主线程就会被同步代码完全霸占。在此期间,事件循环被冻结,所有排队的几十甚至几百个并发协程都将完全停摆!
当无法找到纯异步库(如 aiohttp 或 httpx)替代、必须调用旧版同步函数时,应使用 Python 3.9+ 提供的 asyncio.to_thread,它会自动将该同步函数扔到后台独立线程池中执行,并在协程层以非阻塞的方式 await 它的返回。
import asyncio
import time

# 模拟第三方遗留的同步阻塞函数(如 requests.get 或密集计算)
def legacy_blocking_io(name: str, seconds: int) -> str:
    print(f"[同步线程] 开始执行阻塞代码: {name}")
    time.sleep(seconds)  # 同步硬阻塞
    print(f"[同步线程] 阻塞代码完成: {name}")
    return f"{name}_result"

async def background_tick():
    for i in range(3):
        print(f"  [事件循环滴答] 心跳正常执行中... (tick {i+1})")
        await asyncio.sleep(0.5)

async def main():
    # 错误做法(绝对禁止):直接在协程里调用 legacy_blocking_io() 会瞬间卡死事件循环!
    # 正确做法:使用 asyncio.to_thread 转移到工作线程池执行
    print("启动并发测试:异步心跳 + 后台线程阻塞任务")
    await asyncio.gather(
        background_tick(),
        asyncio.to_thread(legacy_blocking_io, "Task-Sync", 1.5)
    )
    print("并发混合任务执行成功,事件循环未被阻塞!")

if __name__ == "__main__":
    asyncio.run(main())
import time; time.sleep(...)。必须全部替换为 await asyncio.sleep(...);凡是耗时的普通同步 I/O,必须通过 asyncio.to_thread 桥接隔离。
八、核心代码全景速查与学习路径总结
掌握 Python 协程不仅是背诵 async 与 await 两个关键字,更需要建立分层的并发思维模型。下表整理了本文介绍的 5 套核心源码的功能定位与选型指导:
| 代码模式 / API | 核心作用 | 典型应用场景 | 关键注意事项 |
|---|---|---|---|
asyncio.run(main()) |
顶层启动入口与生命周期管理 | 命令行脚本、主程序入口启动 | 每个线程只能有一个主循环,禁止在已有循环中嵌套调用 |
async with asyncio.TaskGroup() |
结构化并发编排(Python 3.11+) | 批量网络请求、多源并行聚合 | 具备异常级联取消机制,子任务报错会统一取消同伴 |
asyncio.gather(*tasks) |
经典批量并发结果汇总 | 允许部分失败的数据并行抓取 | 配合 return_exceptions=True 实现容错收集 |
asyncio.wait_for(coro, timeout) |
单任务执行超时保护 | 远端 API 调用的网络熔断防挂死 | 超时会自动向底层协程注入 CancelledError 并抛出 TimeoutError |
asyncio.Semaphore(N) |
并发配额控制与流量限速 | 高并发爬虫、数据库连接数受限操作 | 搭配 async with sem: 确保槽位必被释放 |
asyncio.to_thread(func, *args) |
同步阻塞代码桥接异步 | 调用旧版 requests、文件压缩、密码哈希 | 交由内置线程池执行,防止主线程事件循环卡死 |
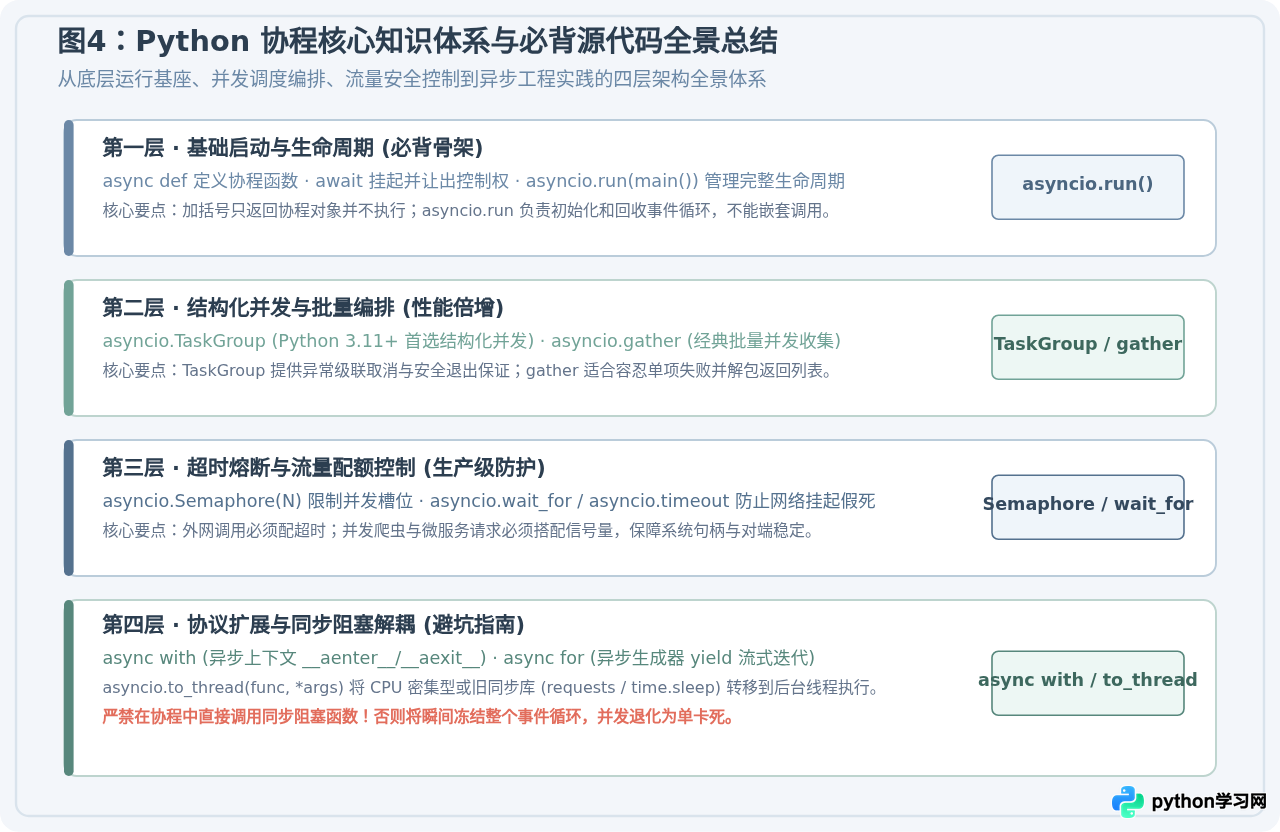
九、常见报错与排查清单
-
RuntimeWarning: coroutine '...' was never awaited:
原因:调用了async def函数但没有在前面加上await,也没有用create_task()注册到事件循环。
解决:在调用处加上await,或者使用asyncio.create_task(...)提交至后台执行。 -
RuntimeError: This event loop is already running:
原因:在已经启动的事件循环环境内部(例如 Jupyter Notebook、IPython、Tornado 或 FastAPI 的路由函数中)再次调用了asyncio.run()。
解决:在已有事件循环的环境中,不要调用asyncio.run(),直接在顶层执行await main(),或通过loop.create_task()派发任务。
熟练默写并理解上述 5 段核心源码及其实际运行边界,是应对 Python 异步网络编程、现代 Web 框架(FastAPI / Sanic)开发及高性能分布式数据采集的关键基石。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















