


Python读取中文文件乱码怎么办?open函数encoding参数详解
详解Python读取中文文件时报错UnicodeDecodeError或文字乱码的根本原因,深入解析open函数encoding与errors参数的标准用法,对比UTF-8与GBK编码差异,并提供系统化排查与实战解决方案。
UnicodeDecodeError 报错或内容显示为“锟斤拷/问号”乱码,根本原因在于文件在磁盘保存时的编码格式与 open() 函数解码时采用的编码规则不一致。解决该问题的通用做法是:永远不要省略 encoding 参数,显式传入 encoding='utf-8';若文件来自早期 Windows 或老版本 Excel 导出,则尝试 encoding='gbk' 或 encoding='gb18030'。
一、现象与根源:为什么读取中文文件会报错或乱码?
很多初学者在编写文件读取代码时,往往习惯直接调用 open(filename, 'r')。当文件内容只有纯英文字母和数字时,程序运行通常没有任何异常;但只要文件中出现中文字符,在某些系统(尤其是 Windows)下就会立刻崩溃,抛出如下典型的错误提示:
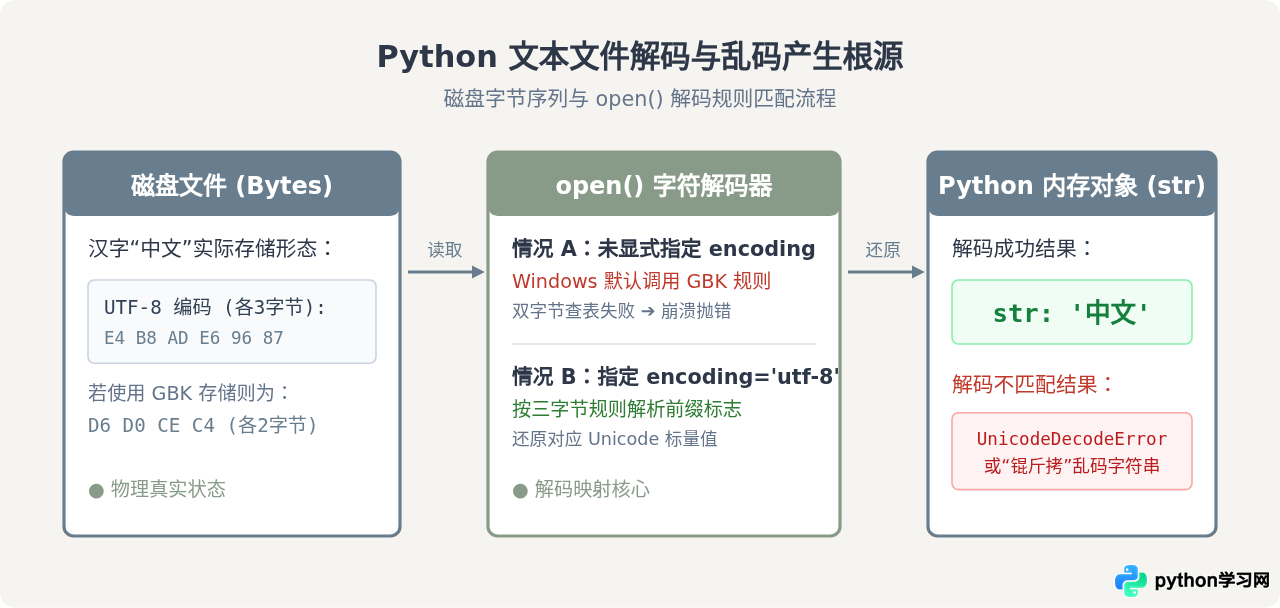
要理解这个问题,需要理清文本在计算机中的两层存在形态:
- 磁盘物理形态(字节流 Bytes):计算机硬件只能存储二进制字节(0 与 1)。汉字“中”在 UTF-8 编码下被切分成 3 个字节(
0xE4 0xB8 0xAD),而在 GBK 编码下则被切分成 2 个字节(0xD6 0xD0)。 - 内存逻辑形态(Unicode 字符):Python 3 中的
str字符串对象在内存中由统一的 Unicode 码点表示。open()函数读取文本模式时,负责扮演“翻译官”的角色,将磁盘上的二进制字节流按照既定规则还原为 Unicode 字符。
如果在调用 open() 时省略了 encoding 参数,Python 会默默启用系统平台当前的默认编码(通过 locale.getpreferredencoding() 获取)。在 Linux 和 macOS 环境下,该默认值通常是 utf-8;但在简体中文版的 Windows 环境中,默认值往往是代码页 936(即 gbk / cp936)。此时,如果你的编辑器默认以 UTF-8 格式保存了文件,Windows 下的 Python 就会拿着 GBK 的双字节规则去强行解析 UTF-8 的三字节序列,一旦匹配到非法的字节组合,便会立刻中断并触发 UnicodeDecodeError。
二、四步排查与解决流程
当遇到读取中文文件报错或乱码时,请遵循以下标准排查流程逐步处理,切忌盲目更换代码:
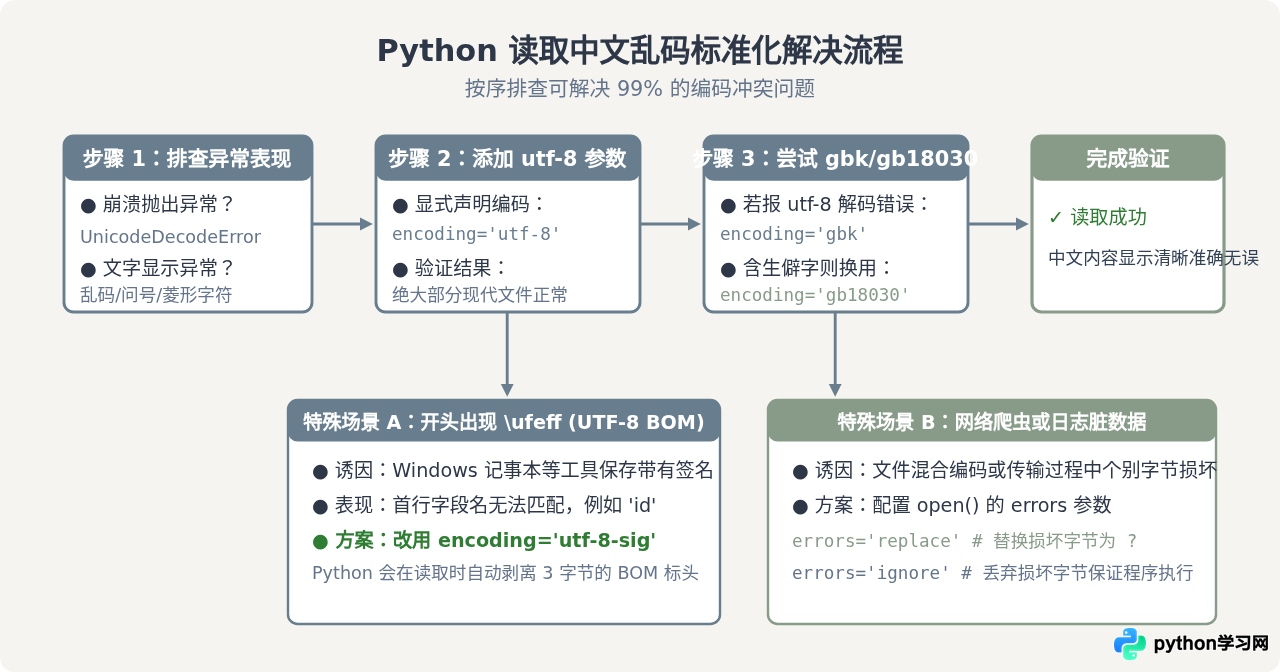
第 1 步:显式传入 encoding='utf-8'
现代软件工程标准均推荐将 UTF-8 作为存储格式。打开文件时,务必使用 with 上下文管理器并显式传入该参数:
# 推荐的基础标准写法
with open('report.txt', 'r', encoding='utf-8') as f:
    text = f.read()
print(text)
第 2 步:若报错,更换为 encoding='gbk' 或 'gb18030'
如果执行上述代码时报出 UnicodeDecodeError: 'utf-8' codec can't decode...,说明该文件在创建时并不是用 UTF-8 编码的。这在以下场景中非常常见:
- 国内业务系统导出的
.csv或.txt账单报表; - 在 Windows 中文版系统中使用原生记事本直接点击“保存”生成的旧文件;
- 历史遗留系统日志。
此时应将参数替换为 encoding='gbk'。如果文本中包含人名生僻字、古籍字或特定生僻字符,GBK 可能依然不够用,此时建议直接选用其国家标准超集 encoding='gb18030':
# 针对中文 Windows 传统导出的安全读取方案
with open('data_export.csv', 'r', encoding='gb18030') as f:
    content = f.read()
第 3 步:处理 Windows 记事本的“隐形杀手”——BOM 标头
在 Windows 下使用旧版记事本保存 UTF-8 文件时,系统常会在文件最前端塞入 3 个不可见的特殊标记字节(0xEF 0xBB 0xBF,即 Byte Order Mark,简称 BOM)。如果使用标准的 encoding='utf-8' 读取,这 3 个字节会被解码成 Unicode 字符 \ufeff,直接粘在首行开头。例如读取 CSV 标题行时,本来是 'name',却会变成 'name',导致通过字典键或字段名索引时报出 KeyError。
解决此问题的标准方法是选用 Python 专门提供的 utf-8-sig 编码:
# 自动识别并剥离文件开头的 BOM 标记
with open('windows_notes.txt', 'r', encoding='utf-8-sig') as f:
    first_line = f.readline()
    print(repr(first_line))  # 不会再残留 \ufeff 字符
三、关键对比:UTF-8 与 GBK / GB18030 的核心差异
很多开发者在遇到乱码时喜欢“凭运气尝试”,换一个参数能跑通就不求甚解。理解 UTF-8、GBK 与 GB18030 在相同环境下的关键差异,对于编写具备健壮跨平台能力的代码至关重要:
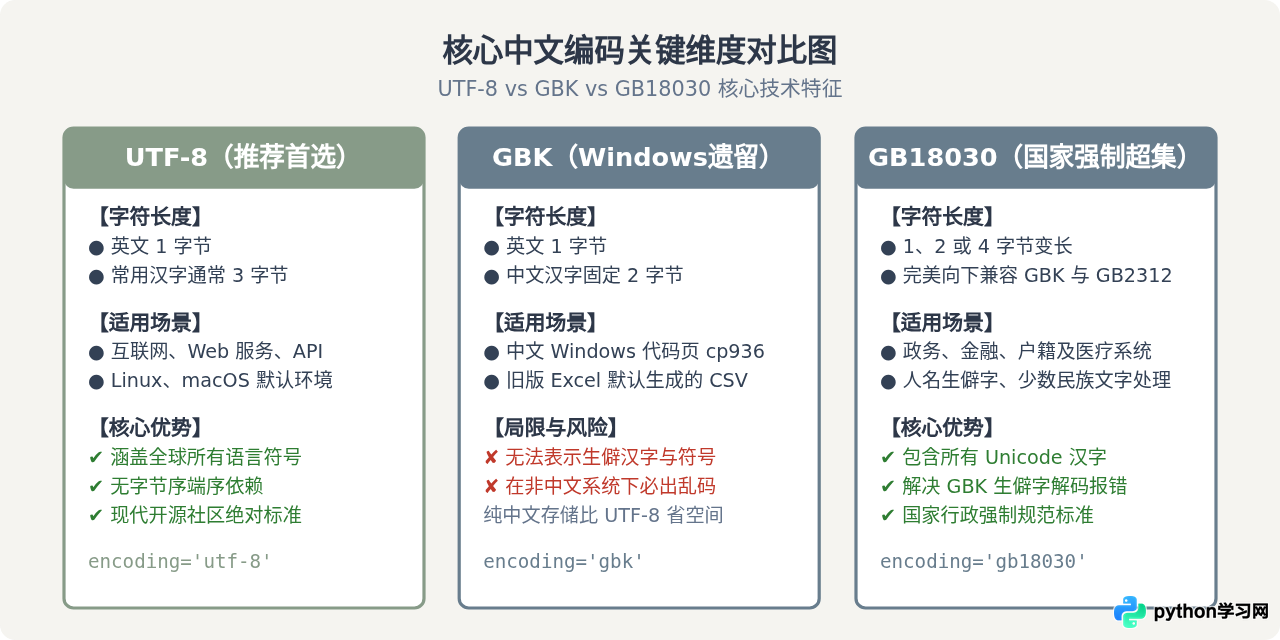
| 编码格式 | 标准参数写法 | 单个汉字字节占用 | 典型适用情景 | 能否跨平台解析 |
|---|---|---|---|---|
| UTF-8 | encoding='utf-8' |
通常 3 字节 | 互联网全行业标准、Linux/macOS 默认、现代项目 | 是,全球统一 |
| UTF-8 with BOM | encoding='utf-8-sig' |
3 字节 + 3 字节文件头 | Windows 记事本、部分特殊 Windows 工具导出的文本 | 是,自动剔除首部标识 |
| GBK | encoding='gbk' |
固定 2 字节 | 中文 Windows 代码页 936、旧版财务/办公软件输出 | 需在代码中显式指定 |
| GB18030 | encoding='gb18030' |
1/2/4 字节变长 | 国内大型政务、银行系统、生僻人名与古籍文献处理 | 需在代码中显式指定 |
四、open() 函数的 errors 容错机制详解
在批量处理海量爬虫抓取文本、传感器硬件数据或经过多次转码的混乱日志时,文本中可能掺杂了少量非法破损字节。如果仅仅因为千分之一的异常字节导致整个脚本崩溃中断,代价过于高昂。此时可通过 open() 的 errors 参数定制容错策略:
# 语法签名:open(file, mode='r', encoding=None, errors=None, ...)常用 errors 策略如下:
errors='strict'(默认值):遇到任何无法解码的字节立刻抛出UnicodeDecodeError,适合对数据完整度要求苛刻的场景。errors='ignore':遇到非法字节直接悄悄跳过,不抛异常也不保留该字节。缺点是可能会丢失关键字符。errors='replace'(工程常用推荐):遇到无法解析的坏字节时,将其替换为标准 Unicode 替换字符(\ufffd,在终端通常显示为一个带问号的黑色菱形?),既不中断程序,又能在结果中保留问题痕迹。errors='surrogateescape':常用于系统级底层脚本,将未知字节存入特殊的 Unicode 代理码区,写入时原样还原,实现无损回写。
下面的示例展示了在面对损坏字节时,不同 errors 参数带来的不同运行结果:
# 模拟含损坏字节的二进制数据 (包含汉字'中'以及一个孤立的无效字节 0xFF)
raw_bytes = b'\xe4\xb8\xad\xff'

# 1. 默认 strict 模式:直接抛出异常
try:
    text = raw_bytes.decode('utf-8', errors='strict')
except UnicodeDecodeError as err:
    print(f"[strict 结果] 抛出异常: {err}")

# 2. ignore 模式:丢弃 0xFF,仅保留正常字符
text_ignore = raw_bytes.decode('utf-8', errors='ignore')
print(f"[ignore 结果] 输出字符串: '{text_ignore}',长度: {len(text_ignore)}")

# 3. replace 模式:将 0xFF 替换为占位字符
text_replace = raw_bytes.decode('utf-8', errors='replace')
print(f"[replace 结果] 输出字符串: '{text_replace}',包含替换标记")[ignore 结果] 输出字符串: '中',长度: 1
[replace 结果] 输出字符串: '中',包含替换标记
五、总结:避免乱码的四大黄金准则
为了让写出的 Python 代码无论在 Windows、Linux 还是 macOS 上都能稳定运行,请牢记以下工程实践原则:
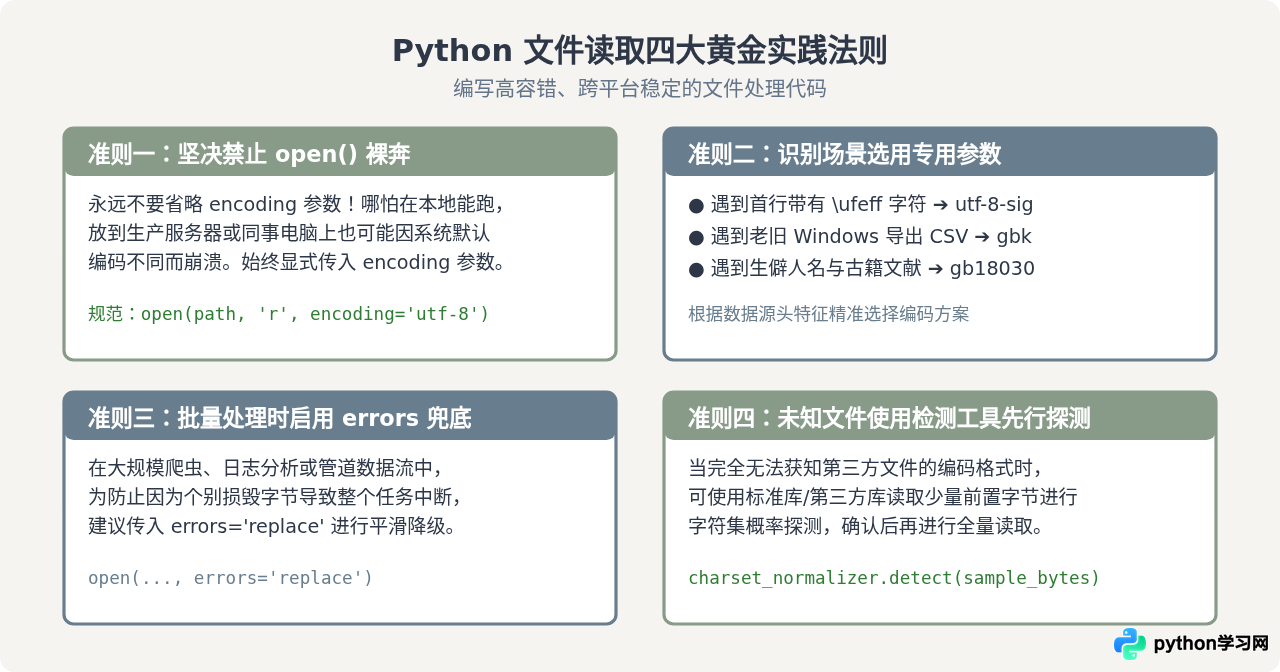
通过遵循上述规范,不仅可以彻底杜绝 UnicodeDecodeError 异常与文字乱码现象,还能大幅提升 Python 脚本在不同操作系统和生产环境中的健壮性与可维护性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















