


python用reduce函数累加怎么写
详细讲解在Python中使用functools.reduce函数实现数值与对象累加的具体写法、底层执行过程、初始值设置技巧以及与sum函数的区别与选择。
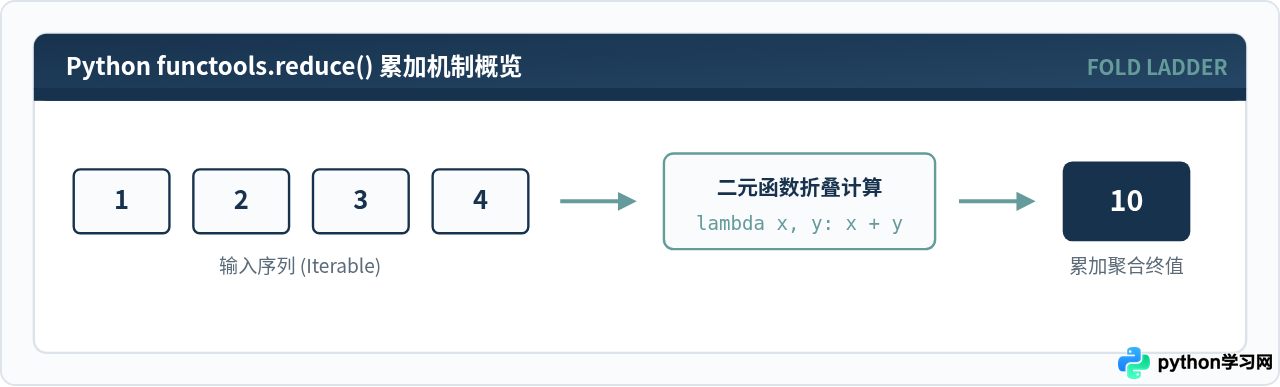
reduce 函数进行累加需要先从标准库 functools 中导入,最常用的写法是 reduce(lambda x, y: x + y, numbers)。本文将具体介绍基础数值累加、带初始值的防空累加、字典对象字段提取累加的标准代码写法,并深入剖析其底层折叠机制与常见注意点。
一、标准累加写法与运行示例
在 Python 3 中,reduce 不再是全局内置函数,而是收录在 functools 模块中。因此,编写累加代码的第一步是导入该模块。
1. 经典 lambda 写法
最直接的方式是传递一个接收两个参数的匿名函数 lambda x, y: x + y,如下所示:
from functools import reduce

# 准备待累加的数字列表
numbers = [1, 2, 3, 4, 5]

# 执行累加
total = reduce(lambda x, y: x + y, numbers)

print(total)  # 示例输出:15
2. 使用 operator.add 提升运行效率
除了匿名函数外,Python 标准库 operator 模块提供了由 C 语言实现的运算符函数 add。在对性能有要求的场景下,这种写法通常比 lambda 更高效且可读性更好:
from functools import reduce
from operator import add

numbers = [10, 20, 30, 40]
total = reduce(add, numbers)

print(total)  # 示例输出:100
二、reduce 累加的逐步推导与执行原理
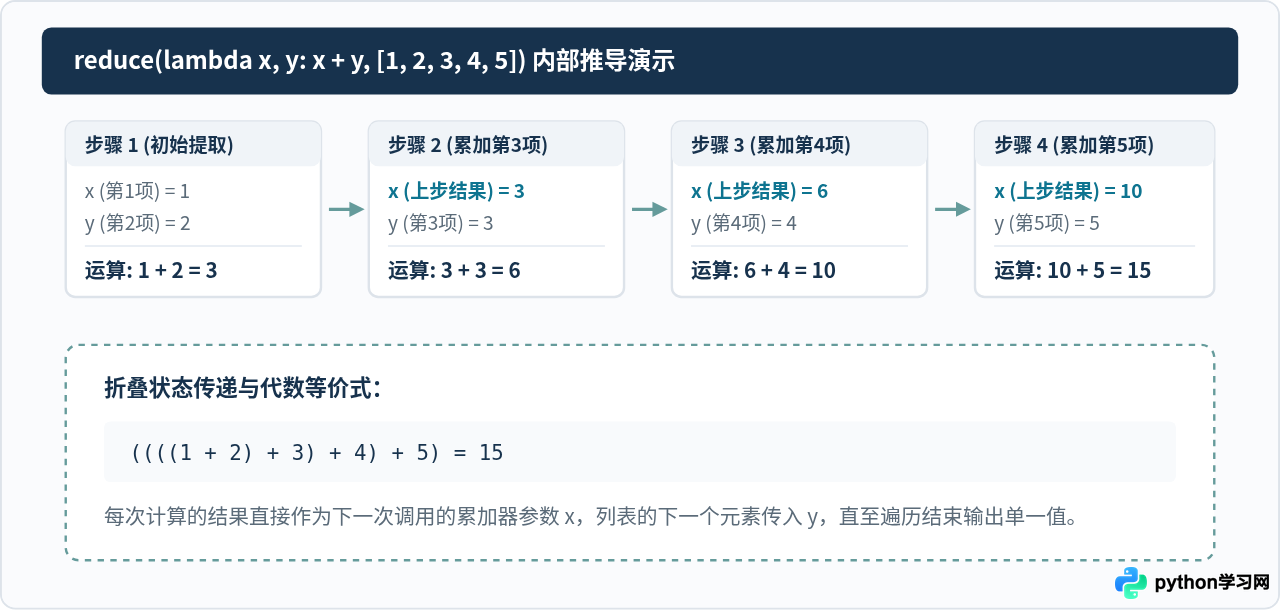
要用好 reduce,关键在于理解它的“折叠(Fold)”执行过程。累加并非一次性把所有数字相加,而是将上一次运算的结果作为下一次运算的第一个参数:
- 第 1 步:取出序列前两个元素
1和2,执行1 + 2 = 3。此时累计值(Accumulator)为3。 - 第 2 步:将当前的累计值
3与第三个元素3相加,执行3 + 3 = 6。累计值更新为6。 - 第 3 步:将累计值
6与第四个元素4相加,执行6 + 4 = 10。累计值更新为10。 - 第 4 步:将累计值
10与最后一个元素5相加,执行10 + 5 = 15。序列遍历完毕,返回15。
三、参数详解:初始值(initializer)的作用与防错机制
reduce 函数的完整参数签名为:
reduce(function, iterable[, initializer])其中第三个参数 initializer 为可选参数,表示累加运算的初始基准值。传入该参数不仅能够为累加设置基数,还能显著提高代码健壮性。
1. 空列表边界问题与 TypeError
如果不提供 initializer,当传入的序列为空时,Python 会直接抛出异常:
from functools import reduce

empty_list = []
# 未指定初始值,直接运行时报错:
# TypeError: reduce() of empty iterable with no initial value
total = reduce(lambda x, y: x + y, empty_list)
2. 安全的防御性写法
为累加运算指定 0 作为初始值,能够确保在序列为空时平稳返回 0,同时在序列非空时第一步将 0 与首个元素相加,结果完全一致:
from functools import reduce

empty_list = []
safe_total = reduce(lambda x, y: x + y, empty_list, 0)
print(safe_total)  # 示例输出:0,不会发生崩溃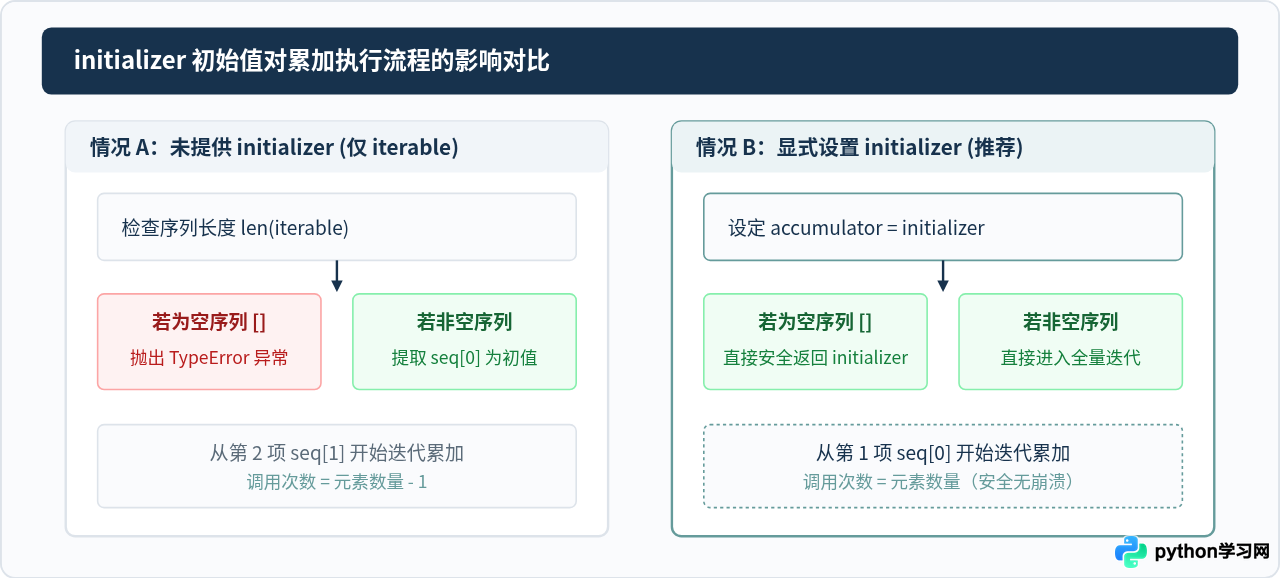
四、进阶场景:对字典列表与复合对象进行字段累加
在实际开发中,我们常常需要对一系列包含结构化数据的对象进行求和(例如计算订单列表中所有商品的总价)。此时,列表中的元素是字典或对象,而累加结果是一个数值。这种类型不一致的场景下,必须传入初始值。
1. 典型错误写法分析
# 错误示例:未传初始值
items = [{"name": "A", "price": 25}, {"name": "B", "price": 40}]

# 下面这行代码会报错!
# 因为第一次调用时 x 是字典 {"name": "A", "price": 25},而 y 也是字典,字典之间不能直接做加法
total = reduce(lambda x, y: x + y["price"], items)
2. 正确规范写法
通过指定初始值 0,累加器 acc 在一开始就是整数类型,后续每次迭代只需要把当前元素 item["price"] 加到 acc 上:
from functools import reduce

orders = [
    {"product": "键盘", "amount": 299},
    {"product": "鼠标", "amount": 129},
    {"product": "显示屏", "amount": 1099}
]

# 正确做法:acc 为数值累加器,item 为字典项,末尾指定初始值 0
total_amount = reduce(lambda acc, item: acc + item["amount"], orders, 0)

print(f"订单总额: {total_amount}")  # 示例输出:订单总额: 1527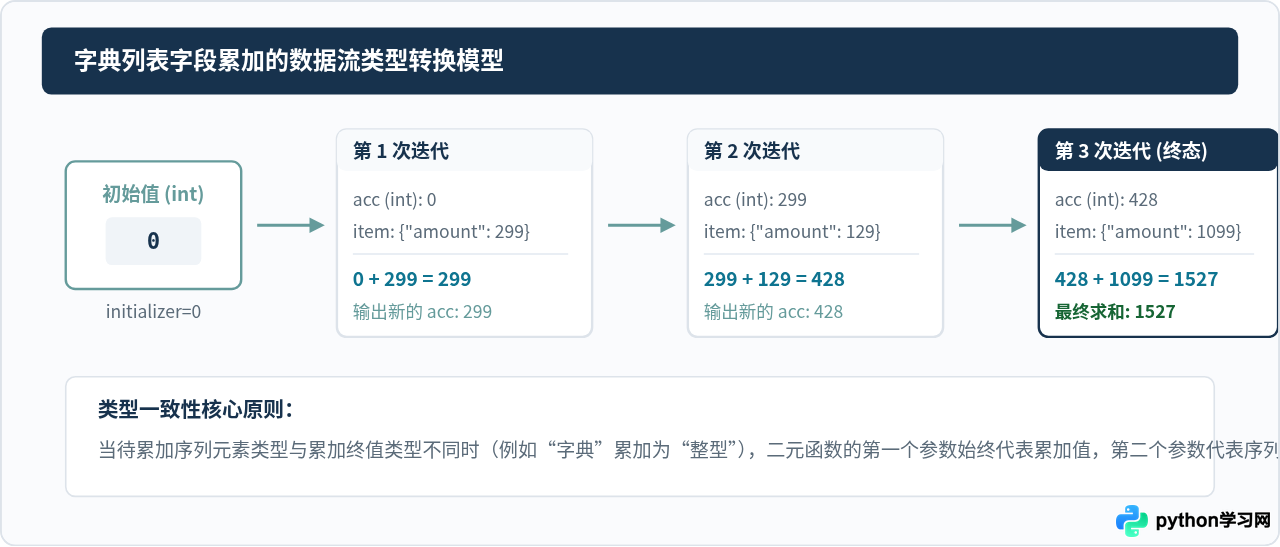
五、reduce 累加与内置 sum() 的技术选型与总结
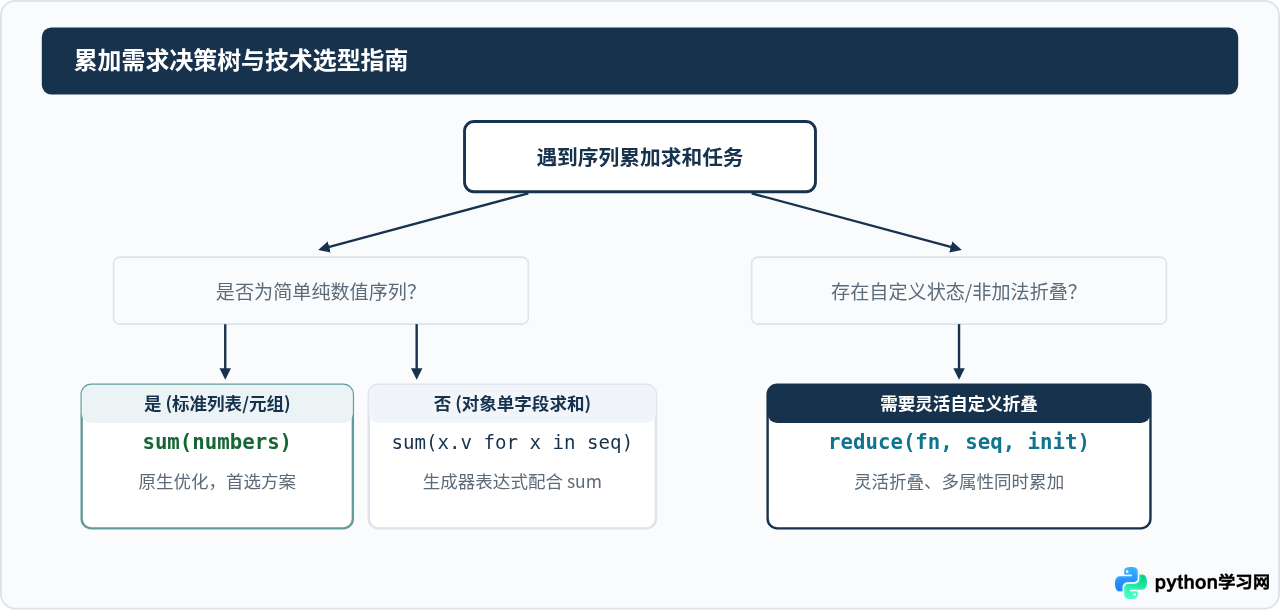
在 Python 日常开发中,如果只是对常规的一维数字列表做纯加法运算,内置函数 sum(numbers) 通常更加简洁、直观,并且在 CPython 解释器层进行了高度优化。
但在需要自定义累加逻辑、在累加过程中执行条件转换、维护复合聚合状态时,reduce 具有不可替代的灵活性。下表列出二者的差异与选型建议:
| 对比维度 | 内置 sum() | functools.reduce() |
|---|---|---|
| 引入方式 | 内置全局函数,无需 import | 需要 from functools import reduce |
| 语法结构 | sum(iterable, start=0) |
reduce(function, iterable, initializer) |
| 执行灵活性 | 仅支持标准的算术加法 | 支持任意二元运算、字段提取、条件过滤等自定义逻辑 |
| 纯数字累加性能 | 底层纯 C 语言循环,运行效率极高 | 每次迭代需要发生 Python 函数调用开销,稍慢 |
| 代码可读性 | 符合 Pythonic 风格,初学者极易阅读 | 体现函数式编程思想,逻辑紧凑但需要理解 fold |
六、核心要点总结
掌握 reduce 函数累加,只需记住以下三点核心实践准则:
- 先导入再使用:Python 3 环境下牢记
from functools import reduce,需要追求极致性能时可以配合from operator import add。 - 养成传递初始值的习惯:写成
reduce(lambda x, y: x + y, numbers, 0)能有效规避空列表导致的TypeError,保证系统运行时稳定。 - 复合对象累加需区分参数:在字典或自定义对象列表中累加字段时,函数定义为
lambda acc, item: acc + item['field'],并且必须设置initializer=0来统一步进时的累加器类型。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















