


python必背源代码归并排序代码
完整提供Python必背源代码归并排序代码,包含标准递归切片版本与索引优化版本,附带详细原理分治图解、双指针合并步骤、关键差异对比与避坑总结。
O(n log n) 的时间复杂度,同时保证同值元素相对位置不变。本文直接给出规范、可运行的 Python 必背源代码,并拆解每行代码的执行机理与易错边界。
一、Python 归并排序核心必背源代码
在各类面试手撕代码、考试上机与日常工程实现中,最推荐背诵的是“切片递归版”。该版本将拆分与合并解耦为两个独立函数,结构层次清晰,逻辑与分治算法定义一一对应,便于记忆与即时手写。
def merge_sort(arr):
    # 1. 递归基线条件:列表长度小于等于 1 时本身已有序,直接返回
    if len(arr) <= 1:
        return arr

    # 2. 找到中间切分点,进行二分拆解
    mid = len(arr) // 2

    # 3. 递归切分并对左右两侧分别执行排序
    left = merge_sort(arr[:mid])
    right = merge_sort(arr[mid:])

    # 4. 将两个已有序的子序列合并为一个有序序列
    return merge(left, right)


def merge(left, right):
    result = []
    i = 0  # 左序列遍历指针
    j = 0  # 右序列遍历指针

    # 遍历两个子序列,将较小的元素优先放入 result
    while i < len(left) and j < len(right):
        # 此处必须使用 <=,以确保算法的稳定性(左侧同值元素优先输出)
        if left[i] <= right[j]:
            result.append(left[i])
            i += 1
        else:
            result.append(right[j])
            j += 1

    # 追加未遍历完的剩余元素(切片越界在 Python 中返回空列表,安全高效)
    result.extend(left[i:])
    result.extend(right[j:])
    return result
测试调用与运行验证
可以将上述代码保存为 merge_sort.py,并在本地 Python 环境(Python 3.6+)中直接验证排序效果:
if __name__ == "__main__":
    sample_data = [38, 27, 43, 3, 9, 82, 10]
    sorted_data = merge_sort(sample_data)
    print("排序前:", sample_data)
    print("排序后:", sorted_data)
控制台示例输出如下:
排序前: [38, 27, 43, 3, 9, 82, 10]
排序后: [3, 9, 10, 27, 38, 43, 82]
二、分治原理推导:拆分与递归回溯全过程
归并排序是“分而治之”(Divide and Conquer)思想的典范。要深刻理解并记住上述代码,关键在于把整个过程划分为两阶段:
- 分(Divide):将大问题拆成形态一致的小问题。每次计算
mid = len(arr) // 2,将原数组拆分成左右两半,直到子序列长度等于 1。一个元素的列表天然是有序的,此时触发递归终止。 - 治与合(Conquer & Combine):从单个元素的叶子节点开始,两两进行有序归并,回溯层层向上,最终拼装成完整的有序数组。
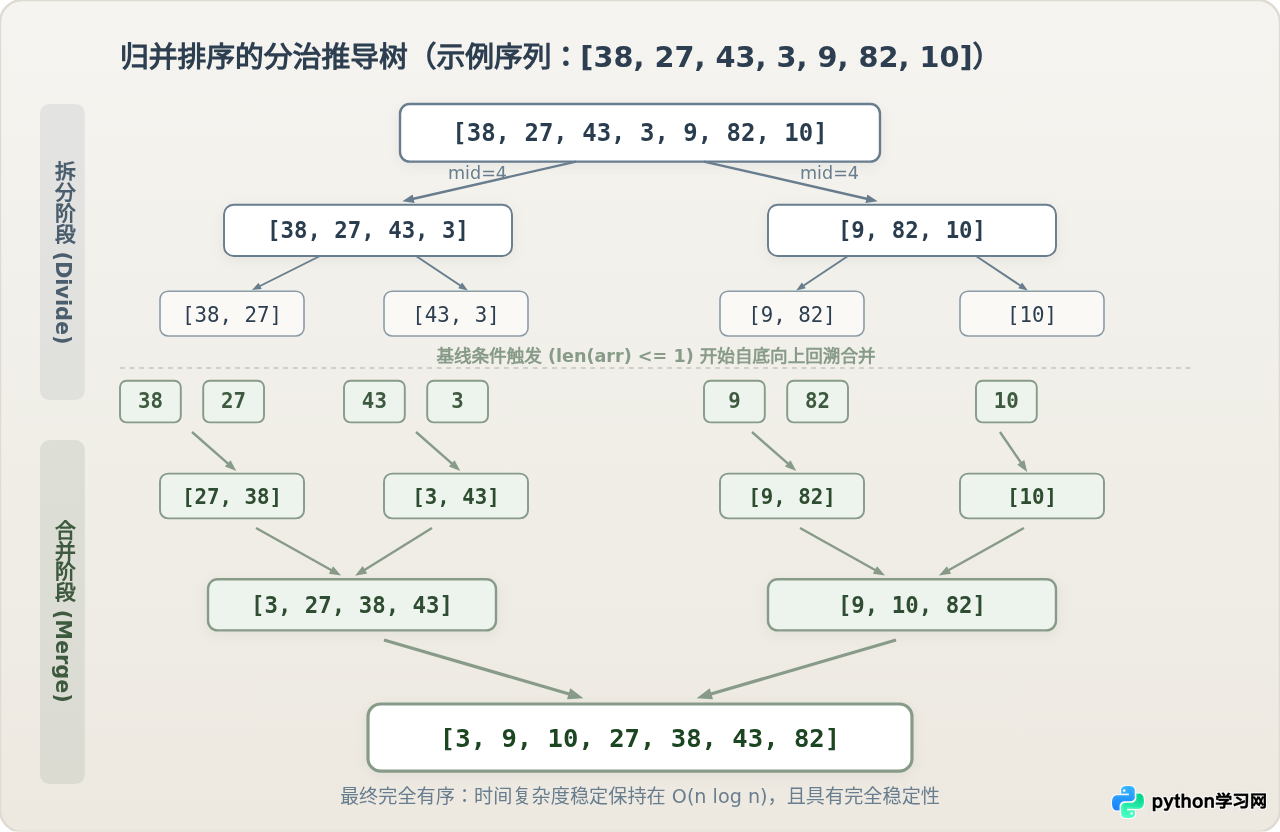
从图 1 可以看出,高度为 log₂ n 层的二叉树直观展示了递归调用栈的展开过程。每一层的所有节点合并总耗时均为 O(n),总共 log₂ n 层,因此总耗时稳定为 O(n log n)。
三、双指针合并逻辑(merge 函数)逐步拆解
merge(left, right) 函数是归并排序的核心运算单元。输入必须是两个各自有序的子序列,输出为一个合并后整体有序的新序列。为了理顺指针移动,我们以 left = [27, 38] 与 right = [3, 43] 为例,演示指针推进的 4 个步骤。
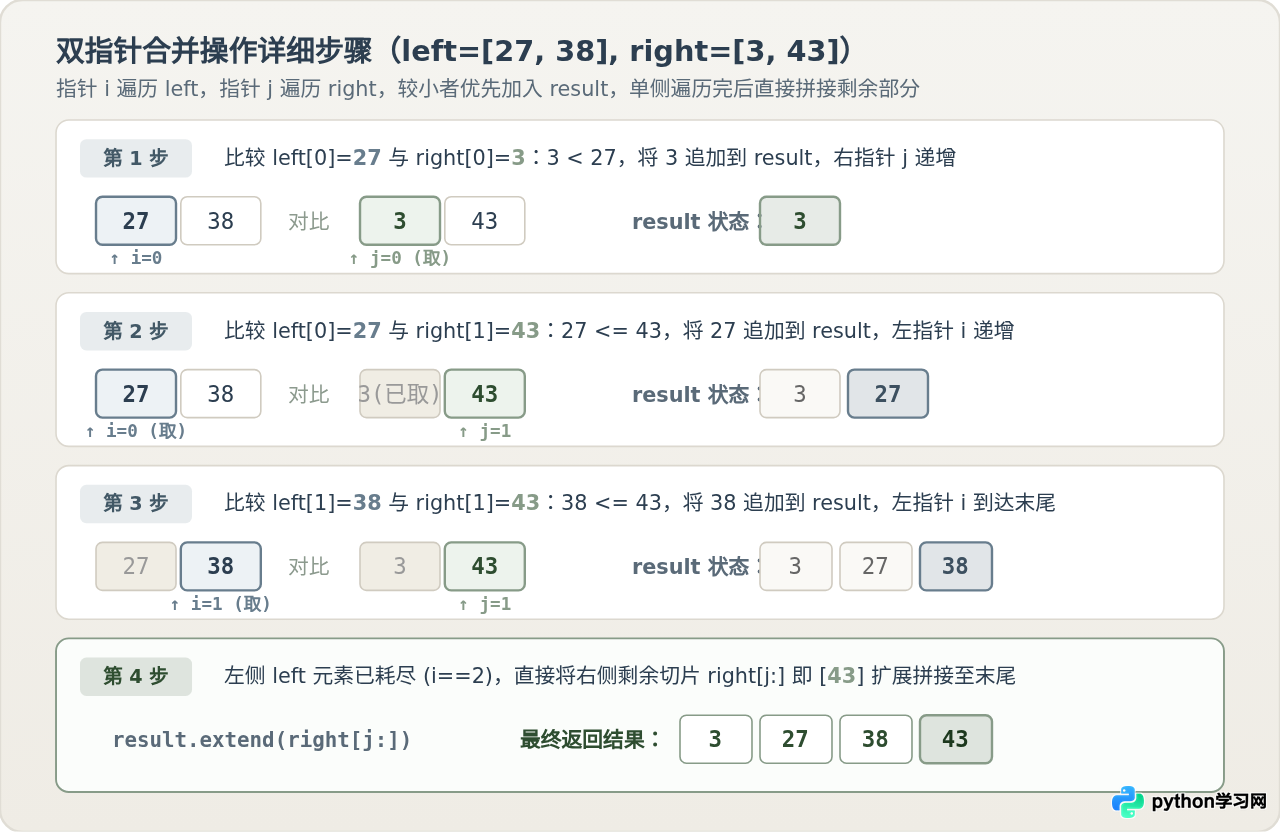
整个合并过程的控制流可以归纳为三个要点:
- 同速比较与前进:只要指针
i < len(left)且j < len(right),循环就持续进行。每次只把较小的值推入result,并将对应的指针单步自增。 - 尾部快速拼合:一旦某一边序列耗尽,另一边剩余的所有元素必定大于等于已合并的所有元素,且内部本身已有序。利用 Python 的列表切片
result.extend(left[i:]),直接把余项拼接到末端即可,无需再次逐一遍历。 - 稳定性保障:在判断条件中写
left[i] <= right[j],当左右两个数值相等时,优先挑选左侧数组的元素,从而防止相等元素跨越彼此,保全了输入时的先后顺序。
四、关键实现对比:切片递归法 vs 索引传参辅助数组法
在学习和使用 Python 归并排序时,常常会遇到两种不同的编码实现策略:一种是前文给出的切片递归法,另一种是类似 C/Java 传统数据结构教材的双索引指针原地切分法。在一致的测试条件下,两者的关键差异及其对工程实现的影响如下。
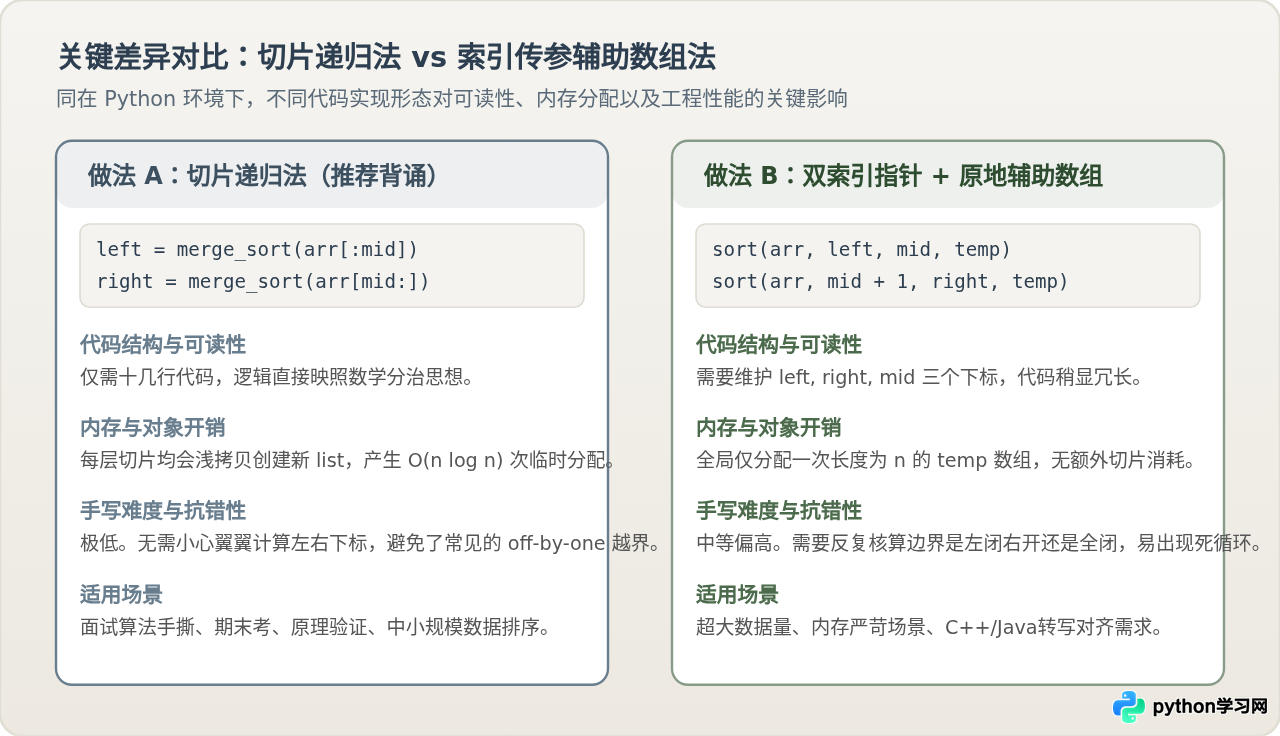
| 比较维度 | 做法 A:切片递归法(正文推荐) | 做法 B:双索引指针 + 预分配辅助数组 |
|---|---|---|
| 代码行数与可读性 | 约 20 行,结构清晰,极易背诵与临场书写 | 约 40 行,需要传 low, mid, high,容易发生下标计算偏移 |
| 空间分配机制 | 每次切片 arr[:mid] 均创建新列表,临时对象分配较多 |
提前分配一个 temp = [0] * n 数组反复复用,额外内存严格受控 |
| 时间常数项开销 | 频繁申请和释放小对象,运行常数略大 | 无多余列表构造,循环内纯数组索引赋值,常数较小 |
| 出错概率(Bug-Prone) | 极低。无需手动控制右边界闭合或开区间 | 中等。常见越界、递归终止条件漏写等于号导致的栈溢出 |
| 应用建议 | 面试手撕、笔试应考、日常脚本首选 | 底层高性能算法库、数据量极大且内存敏感时采用 |
为什么这一差异重要?许多读者在面试手写代码时,试图在白板上用 Python 还原 C 语言的下标传递逻辑,结果因 high - low、mid + 1 的边界条件产生混淆导致超时挂科。而在 Python 中,切片写法虽然带来了一定的浅拷贝开销,但它的表达与分治语义天然契合,并且在 Python 解释器内部切片拷贝是 C 级别 memcpy,在中小规模数组下性能差异极小。因此,作为“必背源代码”,首推切片递归法。
五、编写与手写归并排序的 4 大避坑细节
在实际书写与运行归并排序代码时,有几个极易疏漏的代码细节需要注意:
- 基线条件严禁写成
len(arr) == 1:若仅判断== 1,一旦外部调用传入一个空列表[],len(arr)为 0,递归将永远无法终止,导致RecursionError: maximum recursion depth exceeded。务必写成len(arr) <= 1。 - 比较符号必须保留等号:即必须是
left[i] <= right[j]。如果误写成<,当两个元素值相等时,右侧元素的指针会先行自增进入结果列表,使得原数组中靠后的相同元素排到了前面,破坏了归并排序最宝贵的“稳定性”。 - 剩余元素追加不可遗漏:在
while循环跳出后,必定有且仅有一个子序列还剩下若干个最大元素,必须通过result.extend(left[i:])与result.extend(right[j:])补齐。 - 切片越界安全特性:在 Python 中,如果
i == len(left),切片left[i:]会安全返回空列表[],不会抛出IndexError,这也是切片写法简洁的一大根基。
Python 内置的 list.sort() 和 sorted() 底层使用的是 Timsort(一种结合了归并排序与插入排序的高级混合稳定排序算法)。在实际工程开发中,应始终优先调用内置排序;本篇归并排序代码主要服务于算法学习、底层分治机制理解以及各类技术面试考核。
六、必背速记总结卡片
为方便考前复习或面试前快速回顾,下图总结了归并排序的核心复杂度指标、四步记忆口诀及骨架模板:
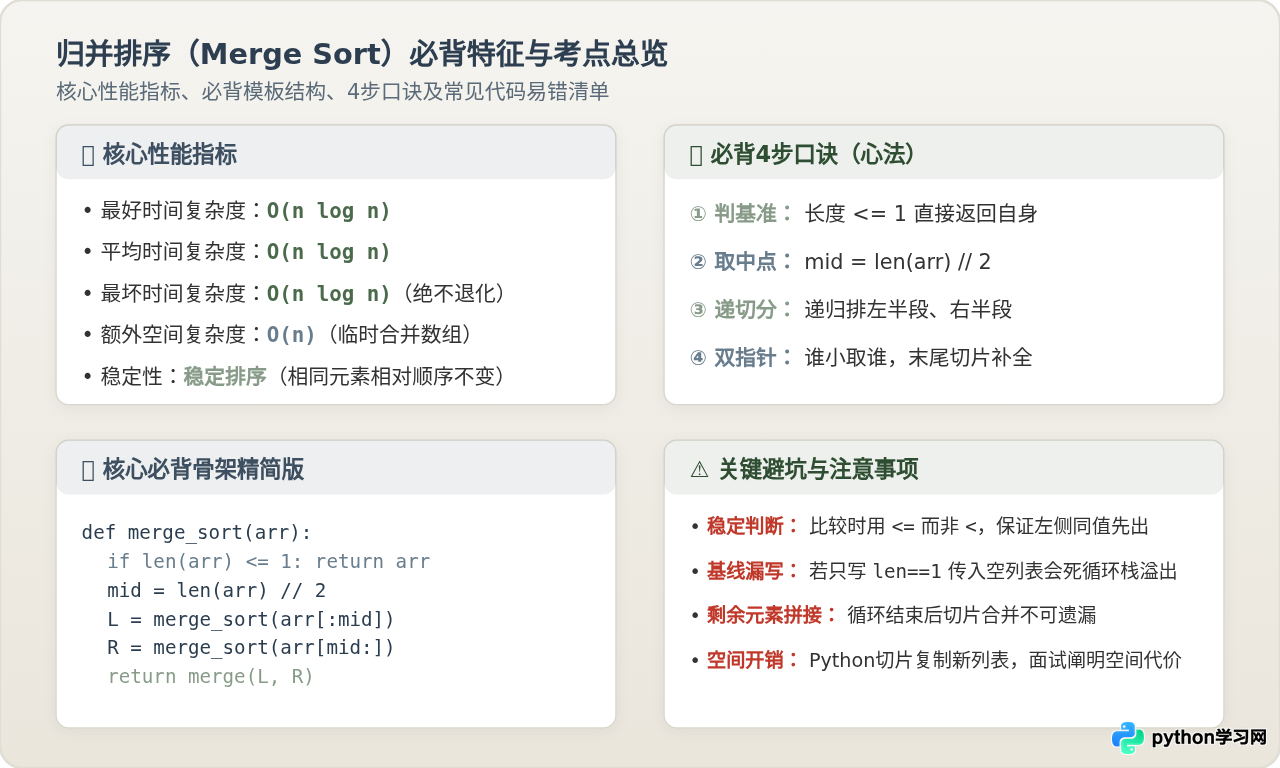
掌握归并排序的核心在于牢记“一判空、二分半、三递推、四合拢”的执行节拍。只需牢牢抓住递归终止基准和双指针 merge 的指针步进与切片合并,就能在任何手写与上机场合一次性写出标准无错的代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















