


Python爬虫入门实战:怎么合法抓取网页数据并保存
详细讲解Python网络爬虫的合法边界、工作原理、核心步骤与数据持久化保存实战,包含完整的合规抓取代码与四幅高清技术架构与流程图示。
一、合规边界与“Robots协议”:抓取前的准绳
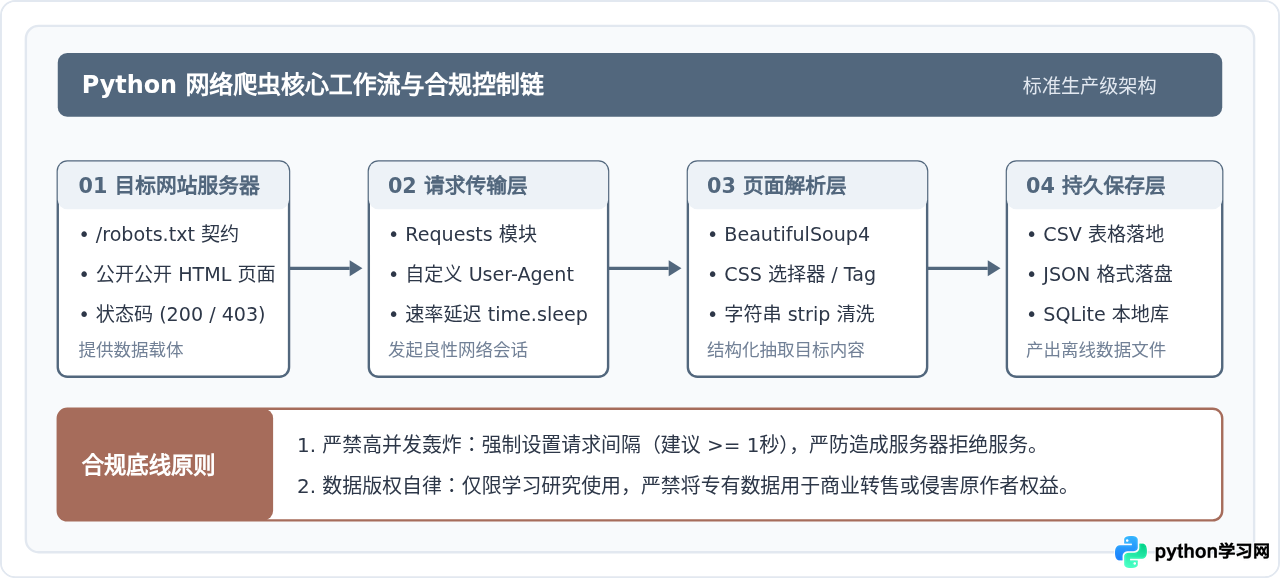
编写爬虫绝非单纯的代码实现,网络数据具有明确的权利归属与服务契约。合规抓取的底线是只获取公开可见、无需绕过权限验证的数据,严禁通过逆向突破登录限制、抓取受隐私保护的个人身份信息,或抓取属于他人受知识产权法严格保护的核心商业资产。
任何合规的爬虫在正式运行前,都应首先访问目标域名的 /robots.txt 文件(即 Robots Exclusion Protocol)。该协议是网站所有者与搜索引擎及爬虫程序之间达成的声明规范,明确列出了哪些路径允许被检索(Allow),哪些路径禁止访问(Disallow),以及建议的访问频次间隔(Crawl-delay)。
robots.txt 中对目标路径标注了 Disallow: /data/,或网站用户协议明确禁止自动化脚本爬取,强行编写脚本抓取可能引发法律纠纷或直接触发目标站点的 IP 封禁与服务告警。
二、核心环境与基础库准备
完成一次标准的数据抓取与存储,Python 生态中推荐采用轻量可靠的黄金组合:requests 负责网络传输,beautifulsoup4 搭配 lxml 负责文档树解析。这些模块分工清晰,便于理解和排查故障。
在终端中执行如下命令安装必要依赖:
pip install requests beautifulsoup4 lxml三、实战四步走:从请求、解析到存储
本实战以公开供开发者学习练习的测试站点 http://quotes.toscrape.com/ 为例,展示如何抓取名言、作者及标签,并将数据安全存储到本地文件。
步骤 1:构造文明友好的请求头并发送 GET 请求
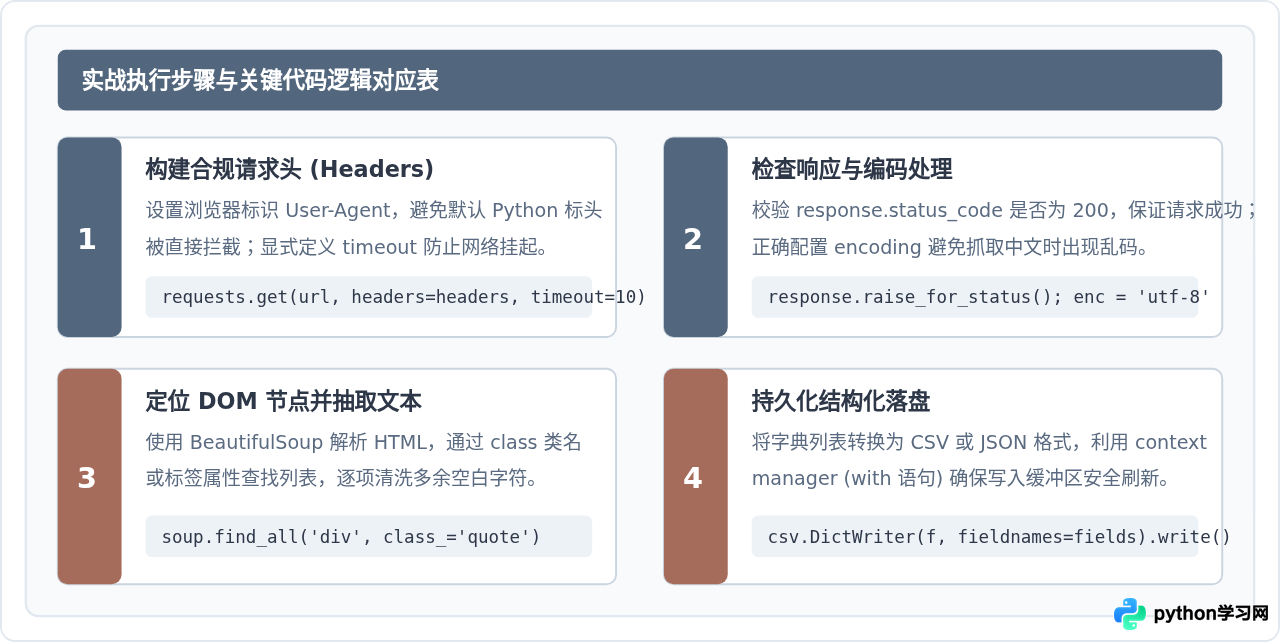
直接使用 requests.get(url) 时,底层发送的 User-Agent 默认标头为 python-requests/x.y.z。很多反爬系统与防火墙会直接拒绝对该标头的响应。因此,必须将爬虫包装为常见的现代浏览器请求,同时可附加邮件或联系方式说明来源。
步骤 2:使用 BeautifulSoup 提取目标内容
获取到 response.text 后,传入 BeautifulSoup(html, 'lxml') 解析生成 DOM 语法树。通过浏览器“审查元素”(F12)定位包含数据的父容器和子标签,例如 class 为 quote 的 <div>,再通过 .get_text(strip=True) 剔除前后回车与空格。
步骤 3:数据持久化落地为 CSV 文件
Python 内置的 csv 模块支持字典写入器 DictWriter,非常适合保存多行具有固定表头结构的字段。指定 encoding='utf-8-sig' 可以让生成的 CSV 文件在中文版 Windows Excel 中双击打开时避免乱码。
完整可运行实战代码
import time
import csv
import json
import requests
from bs4 import BeautifulSoup

def fetch_quotes(page=1):
    url = f"http://quotes.toscrape.com/page/{page}/"
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
    }

    print(f"正在抓取第 {page} 页: {url}")
    try:
        response = requests.get(url, headers=headers, timeout=10)
        # 遇到 4xx/5xx 时主动抛出异常
        response.raise_for_status()
    except requests.RequestException as e:
        print(f"网络请求失败: {e}")
        return []

    soup = BeautifulSoup(response.text, "lxml")
    quote_elements = soup.find_all("div", class_="quote")

    results = []
    for elem in quote_elements:
        text_elem = elem.find("span", class_="text")
        author_elem = elem.find("small", class_="author")
        tag_elems = elem.find_all("a", class_="tag")

        quote_text = text_elem.get_text(strip=True) if text_elem else ""
        author = author_elem.get_text(strip=True) if author_elem else ""
        tags = [tag.get_text(strip=True) for tag in tag_elems]

        results.append({
            "quote": quote_text,
            "author": author,
            "tags": " / ".join(tags)
        })

    return results

def save_to_csv(data, filename="quotes.csv"):
    if not data:
        print("无数据需要保存")
        return

    fieldnames = ["quote", "author", "tags"]
    with open(filename, mode="w", newline="", encoding="utf-8-sig") as f:
        writer = csv.DictWriter(f, fieldnames=fieldnames)
        writer.writeheader()
        writer.writerows(data)
    print(f"已成功将 {len(data)} 条数据保存至 {filename}")

def save_to_json(data, filename="quotes.json"):
    if not data:
        return
    with open(filename, mode="w", encoding="utf-8") as f:
        json.dump(data, f, ensure_ascii=False, indent=2)
    print(f"已成功将 {len(data)} 条数据保存至 {filename}")

if __name__ == "__main__":
    all_quotes = []
    # 示例抓取前 2 页,并在请求间设置文明延时
    for page in range(1, 3):
        quotes = fetch_quotes(page)
        all_quotes.extend(quotes)
        # 关键:礼貌爬虫必不可少的抓取间隔
        time.sleep(1.5)

    save_to_csv(all_quotes, "quotes.csv")
    save_to_json(all_quotes, "quotes.json")
四、数据存储格式选择:CSV、JSON 与 SQLite 对比
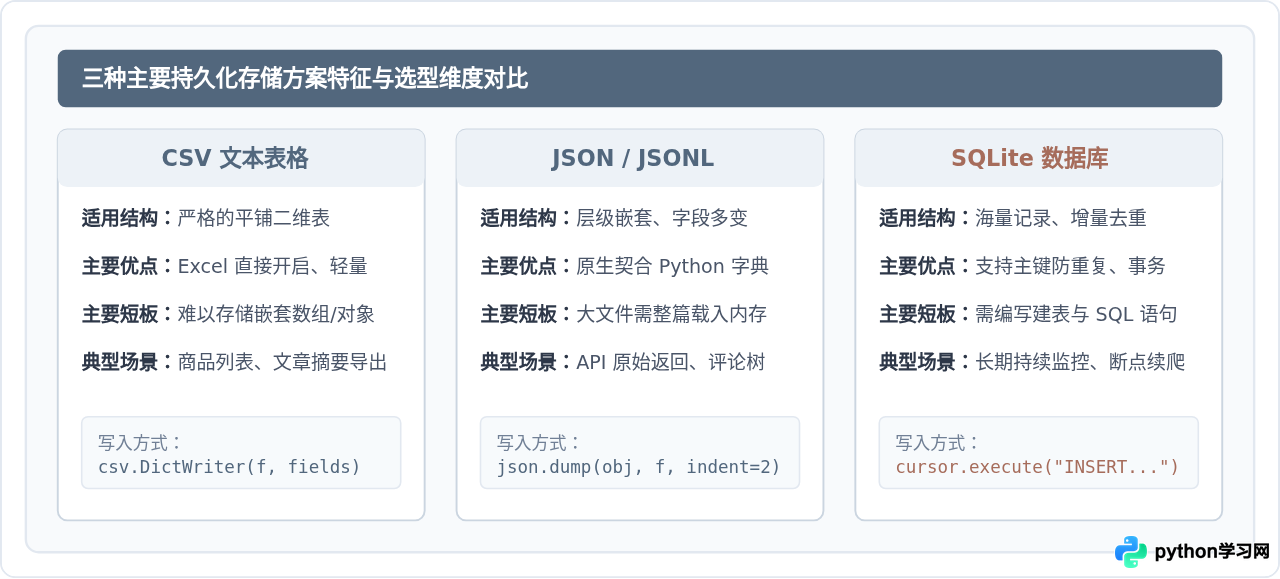
抓取下来的数据根据结构复杂度和后续处理用途,应该选择不同的存储载体。简单的表格类数据推荐 CSV;嵌套结构或不定长属性优先选择 JSON;若需要去重、增量更新和多表关联,则推荐嵌入式 SQLite 数据库。
五、工程稳健性与礼貌爬取准则
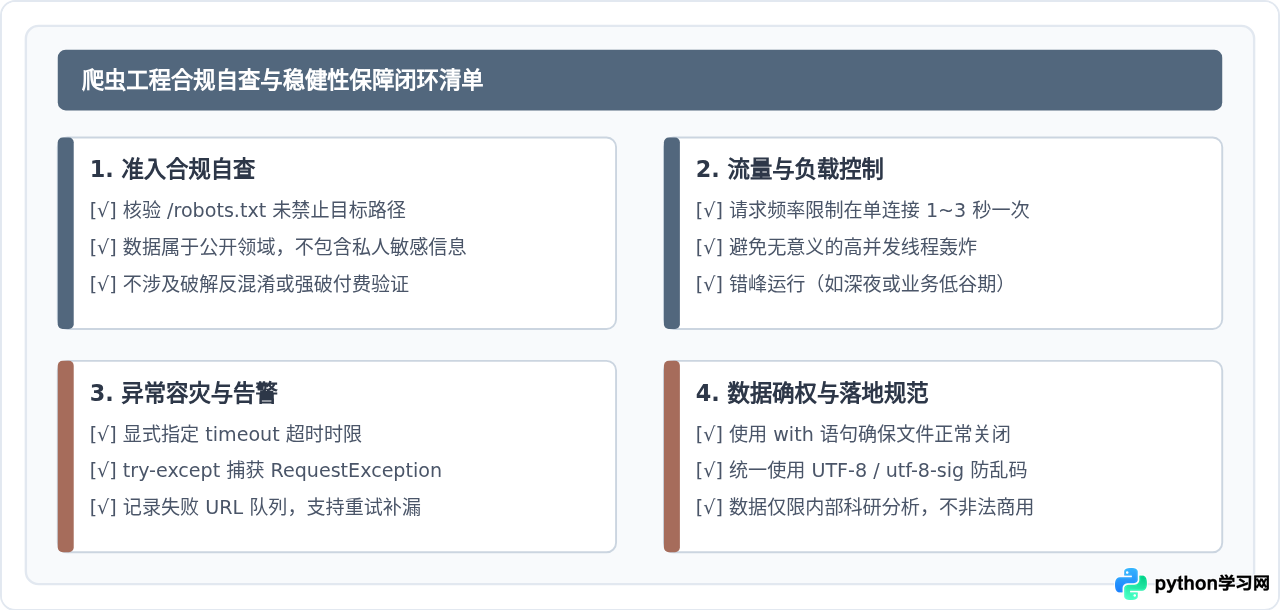
在实际编写爬虫时,网络抖动、目标站响应迟缓或临时限流属于常态。优秀的爬虫工程绝不应假定网络 100% 可用,而必须建立健全的防御性编程机制:
- 超时保护(Timeout):
requests.get()必须指定timeout=10参数。如果不传该参数,遇到对方服务器挂起时,程序将永久阻塞卡死。 - 频次节流(Rate Limiting):单线程爬虫每次循环末尾务必调用
time.sleep(random.uniform(1.0, 3.0)),模拟真实人类点击间隔,避免触发服务器熔断机制。 - 异常分类重试:区分
requests.exceptions.Timeout、ConnectionError与HTTPError,遇到偶发超时进行有限次数(如 3 次)的退避重试,而非直接退出程序。 - 增量去重:保存每条记录时维护唯一标识(例如文章 URL 或业务 ID),在落盘前查重,防止重复抓取导致的文件臃肿与资源浪费。
六、总结与核心结论
Python 爬虫的核心逻辑非常直观:以合规准则为前提,通过 requests 模拟真实且友好的网络访问,借助 BeautifulSoup 清晰定位 DOM 节点,并用标准文件写入方法将数据保存到本地。
技术本身是中立的工具,真正界定爬虫质量的不仅是提取数据的速度,更是对目标服务器承载力的尊重与对法律边界的敬畏。坚持做到“先读 Robots 协议、主动降低并发延迟、妥善处理异常情况”,才能在保障自身与他人系统稳定的前提下,高效获取有价值的数据资产。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















