


Python使用SQLAlchemy批量更新数据库记录中的备注字段

本文详细介绍在Python中使用SQLAlchemy批量更新数据库记录备注字段的实用方法,涵盖统一条件更新、多记录差异化更新、分批次处理及Session缓存一致性处理。
在日常数据处理与后台业务开发中,批量更新特定字段是极为频繁的操作。特别是对于订单、工单、用户信息表中的“备注”(remark)字段,往往需要在数据核销、审核归档、异常标注或批量打标签时进行成百上千条记录的写入。在Python生态中,如果直接使用循环遍历ORM对象并逐条修改提交,会产生大量的数据库网络往返(Round Trips)并导致事务锁等待加剧;而借助SQLAlchemy 2.0及以上版本的现代批处理机制,可以在单个SQL交互中完成多条记录的高效更新。
本文将围绕SQLAlchemy批量更新备注字段展开,分别介绍针对“全量/多条记录设置为相同备注”和“不同记录分别写入个性化差异备注”两种核心场景的具体实现步骤、代码范式以及底层机制,帮助读者在保证数据一致性的前提下显著提升程序执行效率。
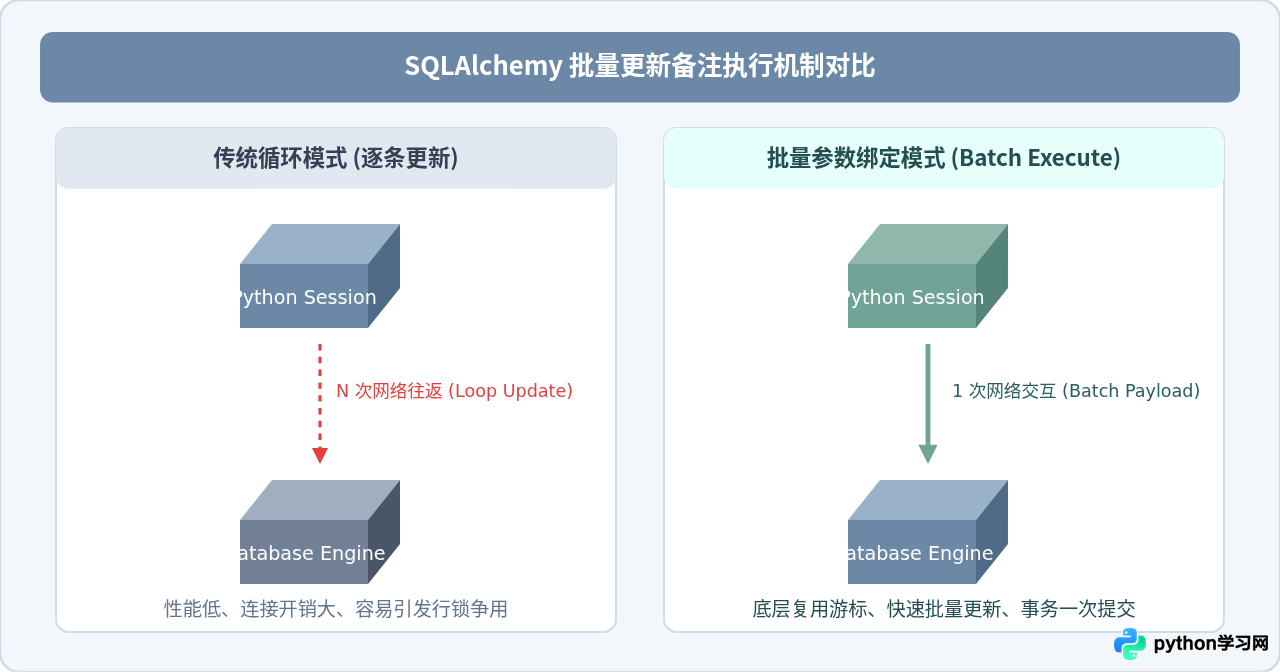
一、批量更新的常见场景与机制对比
在展开具体代码前,需要明确业务上更新备注字段的两种典型形态:
- 同值批量更新:将满足特定过滤条件的一批记录统一更新为相同的备注内容。例如将所有“已超时未支付”的订单状态变更为已关闭,并统一添加备注
"系统自动超时关闭"。 - 异值批量更新:每条记录的主键不同,所需要写入的备注文本也各不相同。例如根据外部导入的客服工单Excel表格,批量将数百个不同的客户回访结果分别同步到各自对应的记录中。
二、环境准备与模型定义
为便于后续代码演示,我们基于SQLAlchemy 2.0现代语法构建一个订单信息模型Order。其中包含主键id、订单编号order_no、订单状态status、备注说明remark以及更新时间updated_at。
from datetime import datetime
from typing import Optional
from sqlalchemy import create_engine, String, DateTime, update, bindparam
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column, Session

class Base(DeclarativeBase):
    pass

class Order(Base):
    __tablename__ = "shop_order"

    id: Mapped[int] = mapped_column(primary_key=True, autoincrement=True)
    order_no: Mapped[str] = mapped_column(String(64), index=True)
    status: Mapped[str] = mapped_column(String(32), default="pending")
    remark: Mapped[Optional[str]] = mapped_column(String(255), nullable=True)
    updated_at: Mapped[datetime] = mapped_column(DateTime, default=datetime.now, onupdate=datetime.now)

# 初始化 SQLite 或 MySQL 数据库连接
engine = create_engine("sqlite:///demo_shop.db", echo=False)
Base.metadata.create_all(engine)
三、场景一:根据条件统一更新多条记录的备注
当多个记录需要打上同一备注标记时,推荐直接使用SQLAlchemy的update()构建器生成单条批量更新SQL语句。这种方式直接在数据库服务端根据WHERE子句进行匹配更新,无需事先将数据查询到Python内存中。
1. 实现步骤与代码范式
例如,业务需要将所有状态为"refunded"(已退款)且备注为空的订单,统一追加备注信息"系统已自动核销原款项":
def update_identical_remarks():
    with Session(engine) as session:
        # 构建 UPDATE 语句
        stmt = (
            update(Order)
            .where(Order.status == "refunded", Order.remark.is_(None))
            .values(
                remark="系统已自动核销原款项",
                updated_at=datetime.now()
            )
        )

        # 执行更新并提交
        result = session.execute(stmt)
        session.commit()

        print(f"成功统一更新备注,影响行数: {result.rowcount}")
2. 原理解析
上述代码生成的SQL类似于:
UPDATE shop_order
SET remark = '系统已自动核销原款项', updated_at = '2026-10-17 00:00:00'
WHERE shop_order.status = 'refunded' AND shop_order.remark IS NULL;
整个过程仅向数据库发送了一次SQL请求,无论符合条件的记录是10条还是10万条,都能在数据库内部完成索引检索与批量修改,开销极小。
四、场景二:按主键批量更新各不相同的备注字段
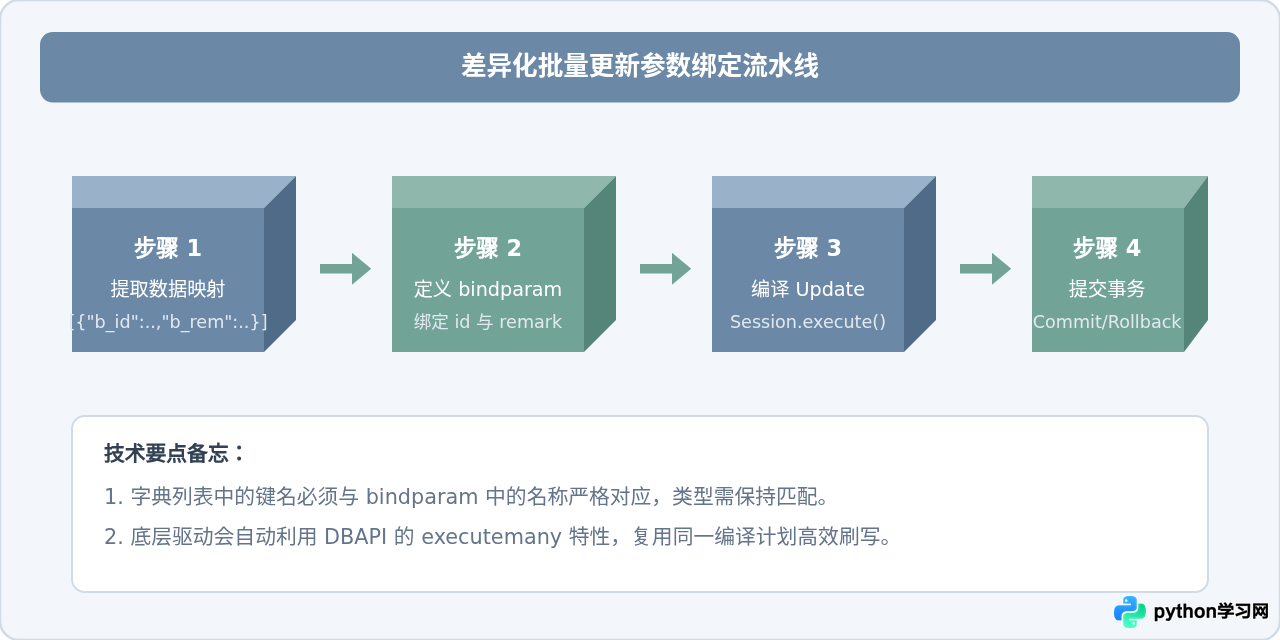
如果每条记录的备注都不相同(例如从Excel表格中解析得到几百个订单ID及各自对应的人工审核备注),则无法使用单个静态值。在SQLAlchemy 2.0中,最标准、最高效的解法是利用参数字典列表结合参数绑定(bindparam)。
1. 完整实现代码
下面展示如何将一批不同的备注内容,通过一次session.execute()精准刷入数据库对应记录:
def update_custom_remarks_batch():
    # 模拟外部输入的数据源:待更新的记录ID及其对应的新备注
    records_to_update = [
        {"b_id": 1, "b_remark": "客户来电核实,加急顺丰发货"},
        {"b_id": 2, "b_remark": "缺货状态已解除,预计明日出库"},
        {"b_id": 3, "b_remark": "发票抬头已变更为企业专票"},
        {"b_id": 4, "b_remark": "赠品随第二批包裹单独发出"},
    ]

    with Session(engine) as session:
        # 声明基于 bindparam 的动态更新语句
        stmt = (
            update(Order)
            .where(Order.id == bindparam("b_id"))
            .values(
                remark=bindparam("b_remark"),
                updated_at=datetime.now()
            )
        )

        # 一次性传入字典列表执行批处理
        session.execute(stmt, records_to_update)
        session.commit()
        print("不同备注字段已完成批量写入。")
2. 关键点剖析
在上述结构中,bindparam("b_id")和bindparam("b_remark")充当了SQL模板中的动态占位符。执行时,SQLAlchemy会将其转化为底层的参数批处理操作(例如在PostgreSQL中采用参数化批处理,在MySQL驱动中采用executemany)。与循环逐条提交相比,网络通信开销减少至一次往返,且数据库只需进行一次SQL语法解析与执行计划编译。
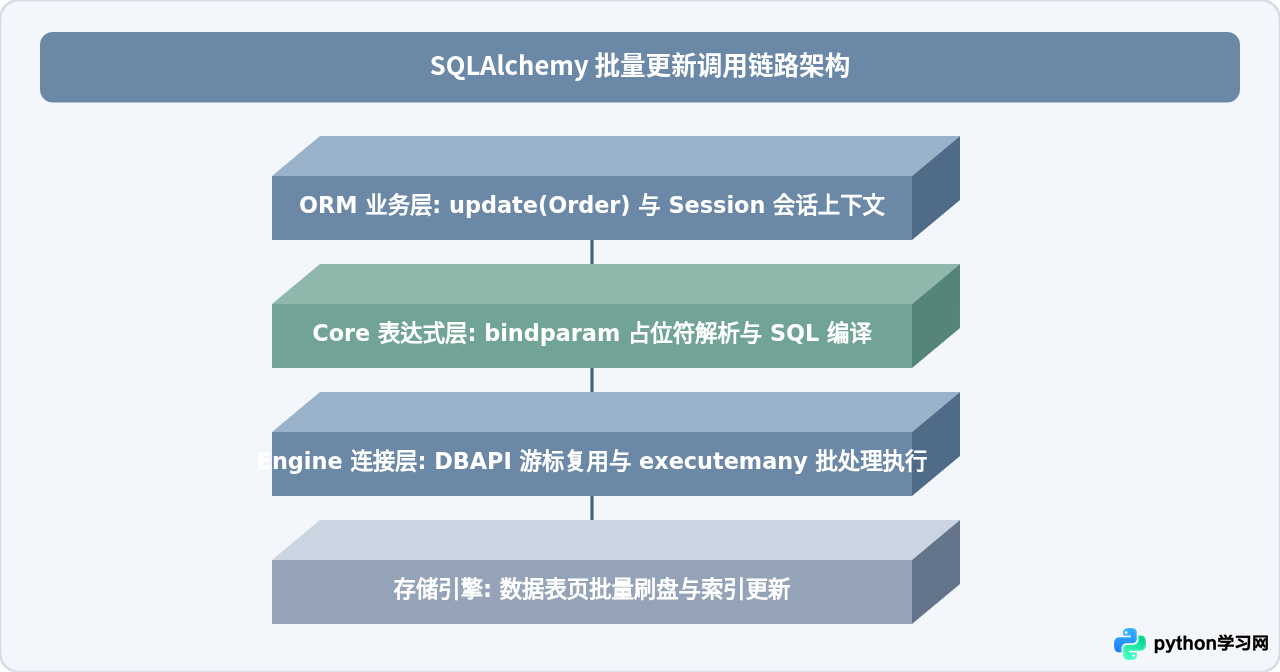
五、SQLAlchemy 架构层次与批量执行链路
理解批量更新在SQLAlchemy中的流转路径,有助于排查超时和锁争用问题。整个调用自上而下经过ORM映射层、Core核心表达式编译层,最终进入Engine连接池。
六、超大规模数据下的分批切片(Chunking)优化
如果待更新的备注数据达到几万乃至几十万条,即使使用session.execute(stmt, list_of_dicts),将所有数据一次性打包进单个列表也会带来两大风险:
- 内存骤增与连接超时:Python构建巨型列表占用大量内存,数据库驱动在一次性组装巨型SQL包时容易超出
max_allowed_packet限制。 - 长事务与死锁风险:更新耗时过长会导致涉及的数据行被长期锁定,阻塞其他正常业务。
此时应采用分批切片(Chunking)策略,以固定批次大小(如每次500至1000条)逐步执行并适时提交:
def chunked_update_remarks(large_dataset: list[dict], batch_size: int = 1000):
    stmt = (
        update(Order)
        .where(Order.id == bindparam("b_id"))
        .values(
            remark=bindparam("b_remark"),
            updated_at=datetime.now()
        )
    )

    total_records = len(large_dataset)
    with Session(engine) as session:
        for i in range(0, total_records, batch_size):
            chunk = large_dataset[i : i + batch_size]
            session.execute(stmt, chunk)
            session.commit()  # 每批处理完提交一次事务,释放行级排他锁
            print(f"已完成: {min(i + batch_size, total_records)} / {total_records}")
七、核心避坑指南与注意事项
直接执行
session.execute(update(...))属于Core层面的批量写入,它会直接绕过Session中当前已加载的对象。如果此前你已经通过session.get(Order, 1)加载了订单1,在批量更新其备注后,由于内存中的旧实例不会自动感知数据库变化,访问order_obj.remark可能仍是旧值。此时应调用session.expire_all()或重新开启新Session查询。
备注字段通常在模型中定义为
String(255)或Text。在批量写入外部数据时,应提前进行长度截断或校验,避免因为单条记录备注过长导致整批操作报DataError: value too long for type并引发全部回滚。
对于生产级脚本,务必将批量操作包裹在
try...except中,出现异常时显式调用session.rollback(),防止连接池中的连接保持未完结事务状态。
八、方案选型与总结全景
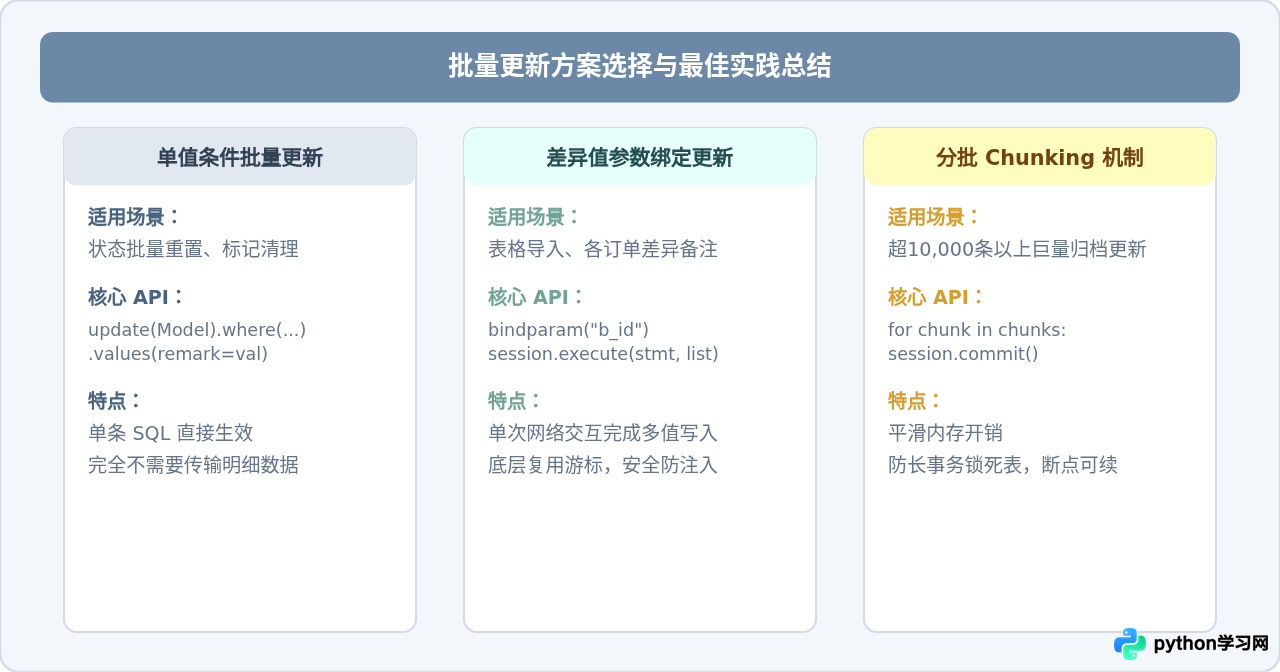
针对批量更新数据库记录中的备注字段,核心总结如下:
| 更新需求 | 推荐方式 | 网络往返次数 | 注意事项 |
|---|---|---|---|
| 多条记录更新为相同备注 | update().where().values() |
1 次 | 尽量利用已建立索引的条件字段进行过滤 |
| 不同记录更新为不同备注(小于 5000 条) | bindparam + 字典列表 |
1 次 | 检查参数名与字典键是否严格吻合 |
| 海量差异化备注(大于 5000 条) | 分批 Chunking(每次 500~1000 条) | N / batch_size 次 | 每批显式 commit,避免长事务锁表 |
通过合理结合SQLAlchemy的Update表达式与参数批处理特性,不仅能消除慢查询与循环等待问题,还能使代码逻辑更加简洁易维护。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















