


python必背源代码去除空格和标点代码
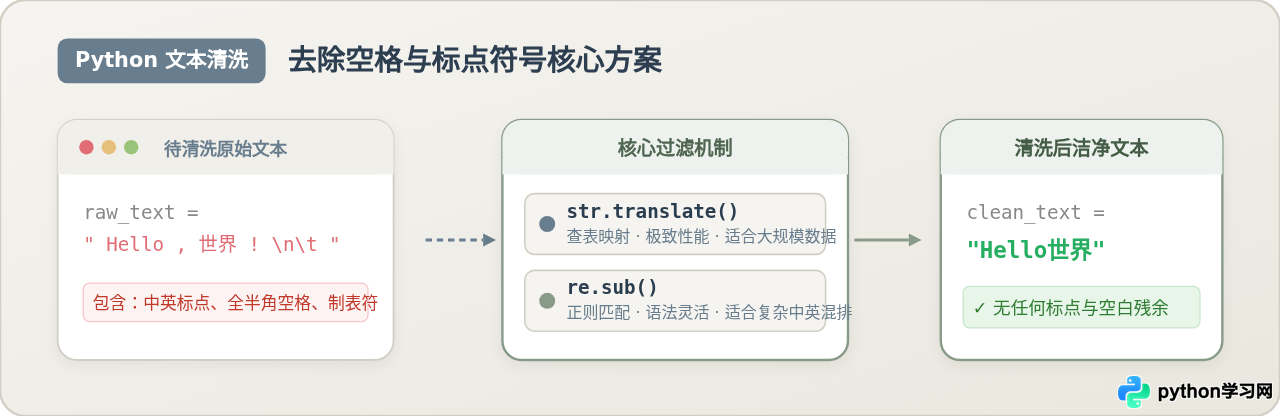
在Python中去除空格和标点符号的两大核心必背代码方案详解,涵盖str.translate查表法与re.sub正则表达式法,分析中英文标点清洗细节与性能差异。
str.translate() 配合 str.maketrans(),在 C 语言层完成极速过滤;二是使用正则表达式 re.sub(),通过灵活的规则定义一次性清除全部空白与中英文标点。
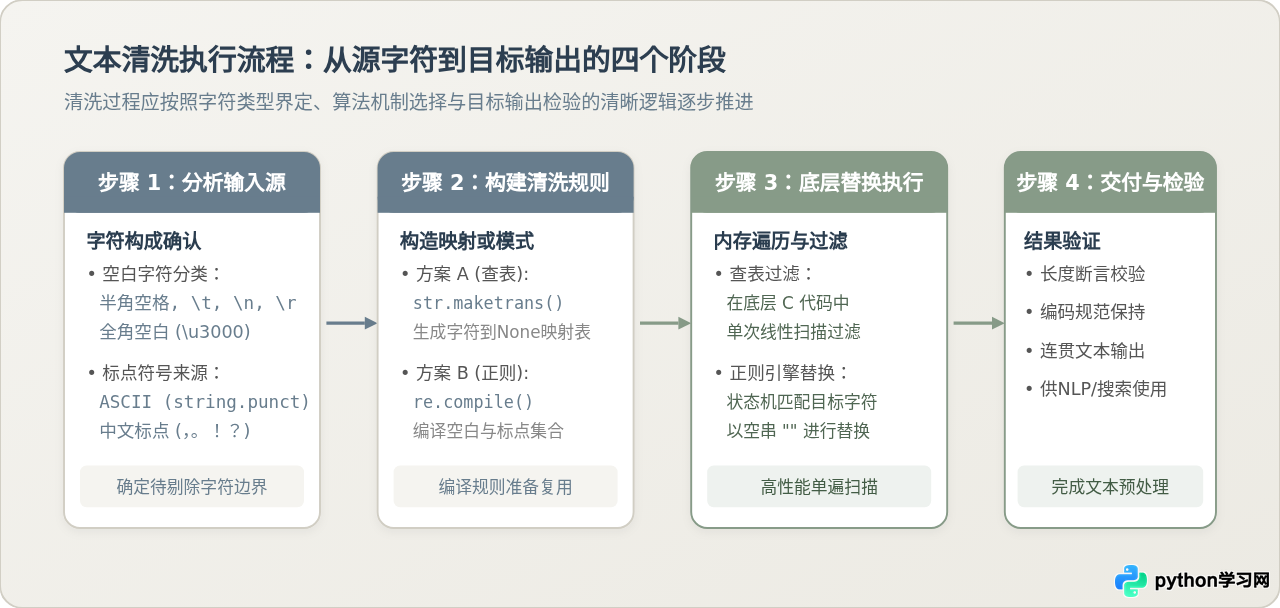
一、清洗目标界定:空白字符与标点符号的真实构成
在编写清洗代码前,必须明确“空格”与“标点”在 Python 字符串中的真实定义。许多初学者写出的清洗代码常常出现“漏网之鱼”,根源在于将空格仅仅理解为英文半角空格 ' ',或将标点仅局限于 ASCII 范围内的键盘字符。
在计算机文本中,空白字符包含以下主要类型:
- 标准半角空格:
' '(ASCII 码 32)。 - 转义空白符:制表符
- 全角空白符:中文输入法排版下的全角空格
标点符号同样存在两套常用体系:
- 英文 ASCII 标点:Python 内置模块
string.punctuation提供了 32 个常见符号,例如!"#$%&'()*+,-./:;<=>?@[\]^_`{|}~。 - 中文全角标点:常见的中文字符如逗号
,、句号。、感叹号!、问号?、双引号“”、书名号《》以及省略号……。这些字符不在string.punctuation的范围内。
二、必背方案一:内置高效查表法(str.translate)
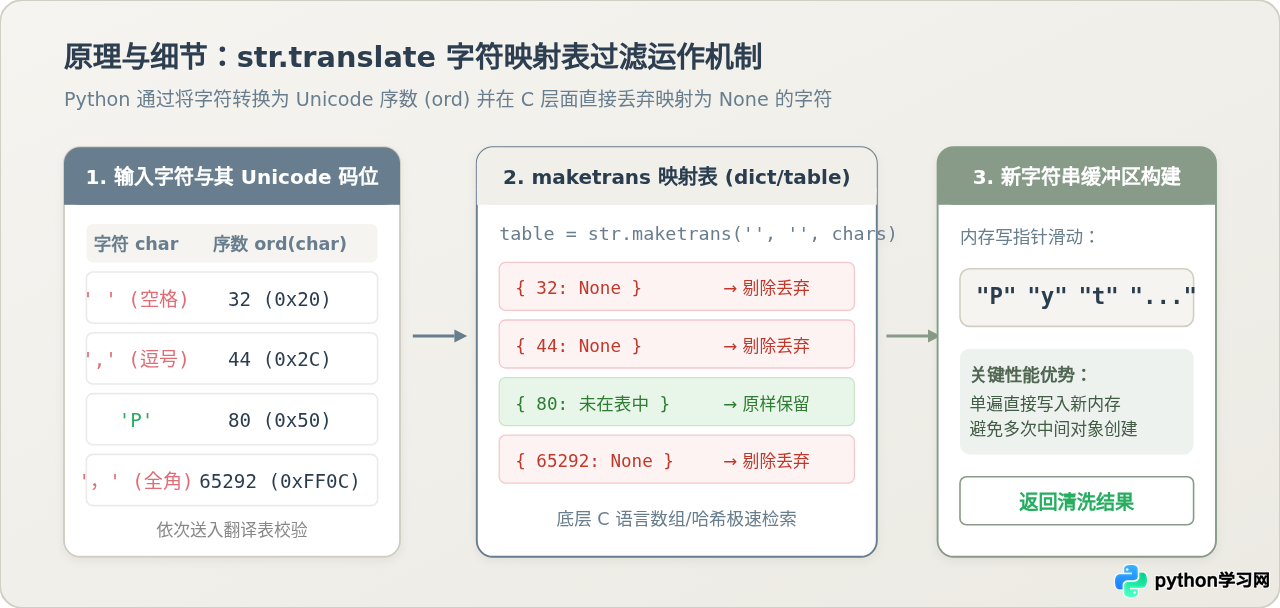
对于大文本量或性能敏感的场景,str.translate() 是官方推荐的最高性能写法。该方法直接在 Python 解释器底层的 C 代码中完成字符比对与剔除,避免了 Python 层面的循环开销。
1. 核心代码示例
通过 str.maketrans() 的第三个参数指定所有需要删除的字符集合,包括标准空白符与全部中英文标点:
import string

# 待清洗的原始字符串(包含全半角空格、制表符、中英文标点)
raw_text = "  【Python教学】: 字符清洗,测试 123 ! \t\n Hello, World.  "

# 1. 组合待删除的全部标点与空白字符集合
# 包含:ASCII 标点 + 常见中文全角标点 + 空格/制表符/换行符/全角空格
chinese_punctuation = "!?。。"#$%&'()*+,-/:;<=>@[\]^_`{|}~⦅⦆「」、、〃》「」『』【】〔〕〖〗〘〙〚〛〜〝〞〟〰〾〿–—‘’‛“”„‟…‧﹏"
del_chars = string.punctuation + chinese_punctuation + " \t\n\r\u3000"

# 2. 构造翻译映射表,将目标字符全部映射为 None(即直接剔除)
trans_table = str.maketrans('', '', del_chars)

# 3. 执行单遍极速转换
clean_text = raw_text.translate(trans_table)

print("清洗后结果:", clean_text)
str.maketrans(x, y, z) 接收三个参数。前两个参数是等长的映射替换字符,第三个参数是待删除的字符。当我们的目标是纯粹“剔除”时,前两个参数传入空字符串 '' 即可。
三、必背方案二:灵活正则匹配法(re.sub)
当文本内容多变、中英文混合复杂,或者无法穷举所有可能出现的标点符号时,使用标准库 re 模块的 re.sub() 是最简洁通用的手段。
1. 核心代码示例
正则表达式利用字符集反向匹配(否定字符类)或者 Unicode 属性,可以一条语句同时解决空白与标点:
import re

raw_text = "  【Python教学】: 字符清洗,测试 123 ! \t\n Hello, World.  "

# 模式说明:
# \s 匹配所有空白字符(包括空格、\t、\n、\r、全角空格等)
# [^\w\s]|_ 匹配所有不是字母、数字、汉字的字符(即所有标点符号),并补充剔除下划线
# 两者合并:匹配任何空白字符与标点字符
pattern = r'[\s\W_]+'

clean_text = re.sub(pattern, '', raw_text)

print("清洗后结果:", clean_text)
2. 性能进阶:正则预编译
如果在循环体或高频调用的函数中使用正则,务必先通过 re.compile() 预编译正则表达式对象,避免每次调用重复解析模式语法:
import re

# 提前编译为正则对象,供批量处理复用
clean_regex = re.compile(r'[\s\W_]+')

data_list = [
    "第一行:数据清洗, 步骤一! ",
    "第二行:去除全部 标点、以及 空格...\t"
]

cleaned_list = [clean_regex.sub('', item) for item in data_list]
print("批量清洗结果:", cleaned_list)
四、关键差异剖析:str.translate 与 re.sub 的深度对比
在面对文本去空格与去标点任务时,选择 str.translate 还是 re.sub 会对代码性能与维护性产生显著影响。以下在相同的输入数据与运行环境下对两者进行对比解释。
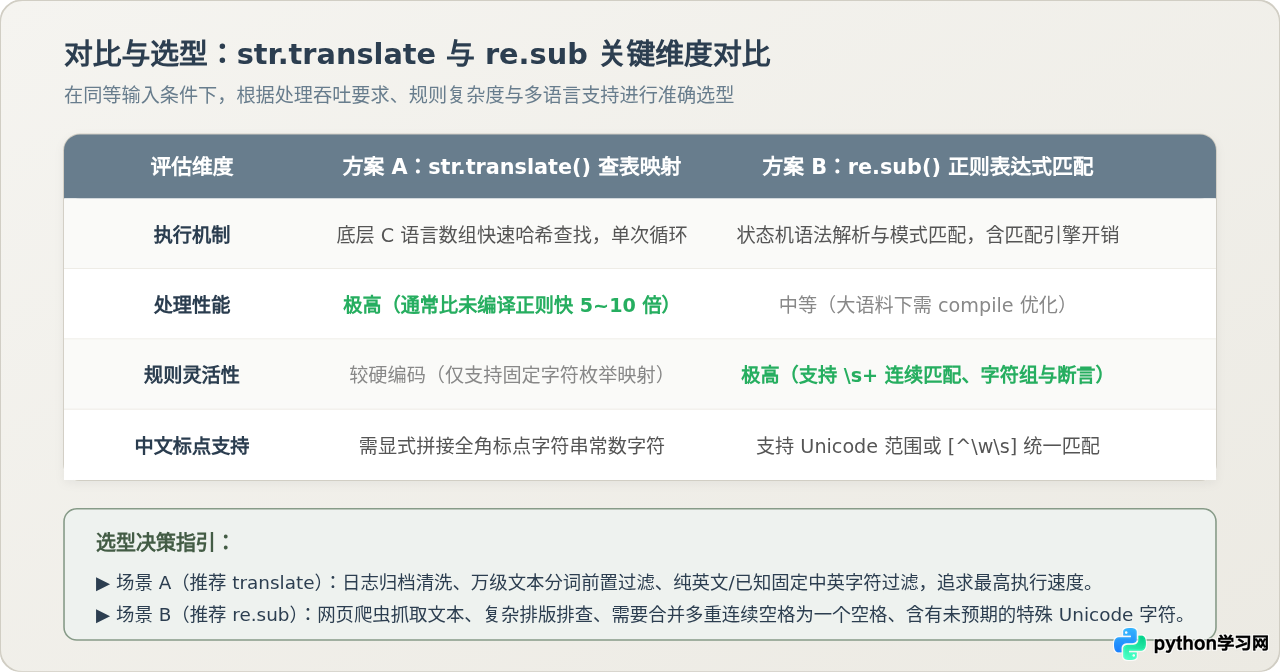
| 对比维度 | str.translate(查表法) | re.sub(正则匹配法) |
|---|---|---|
| 核心机制 | C 语言层数组查表,根据字符 ord 码位做直接定位并丢弃。 | 正则表达式引擎有限状态机遍历,动态匹配模式。 |
| 执行性能 | 极高。在纯字符剔除任务中,耗时通常为正则的 1/5 到 1/10。 | 中等。状态机构建与回溯存在固定计算开销。 |
| 中文字符兼容 | 需要手动维护或拼接中文全角标点字符串常量。 | 天然支持 \w 识别中文字符,无需维护标点枚举清单。 |
| 规则扩展性 | 仅支持 1 对 1 映射或删除,不支持多字符合并模式。 | 极强。支持多空白合并、上下文前后查找、条件断言。 |
差异为什么重要:
在处理数以万计的爬虫文本、语料分词预处理或者大文件逐行分析时,str.translate 能节省大量的 CPU 计算时间。然而,它的局限在于必须显式声明所有需要删除的字符。如果文本中出现了罕见的 Unicode 符号(如特殊日韩标点、数学符号),未被枚举进 del_chars 的符号就会被遗漏。
相反,re.sub(r'[\s\W_]+', '', text) 采取的是“白名单保留”逻辑:在 Python 3 中,\w 默认包含所有 Unicode 语言字符(包括汉字、英文字母、数字),其他所有符号一律视为非单词字符并清除。这种方式代码极简、容错率高,适合应对来源复杂、标点未知的日常业务数据。
五、两种常见衍生场景与专门写法
1. 仅保留单个词间空格(排版规范化)
有时需求并不是将所有空格彻底删光,而是将连续的多个空格、制表符压缩为单个空格,并清除首尾空格。此时最精简的原生必背写法是 str.split() 配合 str.join():
raw_text = "  Python   数据   清洗 \t\n 技术 "

# 不传参数的 split() 会自动将任意连续的空白符(含全半角、制表符)视为一个分隔符切分
words = raw_text.split()
normalized_text = " ".join(words)

print("空格归一化:", repr(normalized_text))
2. 使用 unicodedata 模块严谨剔除国际标点
如果业务面向多语言语料,无法事先确定可能出现的国际标点符号,标准库 unicodedata 提供了权威的字符属性判断方法:
import unicodedata

raw_text = "Hello, 世界!«Bonjour» — 123."

# unicodedata.category(c) 以 'P' 开头的均为标点符号 (Punctuation)
# c.isspace() 判断是否为空白符
clean_chars = [
    c for c in raw_text
    if not c.isspace() and not unicodedata.category(c).startswith('P')
]
clean_text = "".join(clean_chars)

print("国际化清洗:", clean_text)
六、总结与选型速查
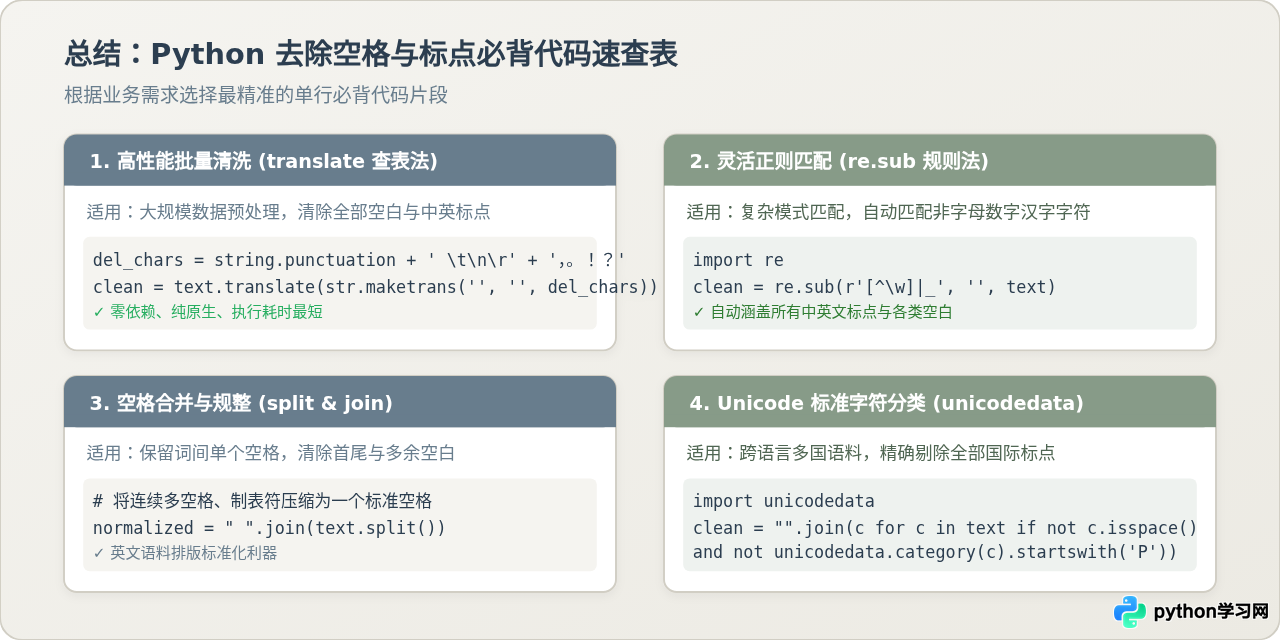
在 Python 中去除空格与标点符号,不需要依赖任何第三方库。根据实际业务场景,遵循以下选择逻辑即可:
- 追求极限速度、已知字符集:优先使用
str.translate(str.maketrans('', '', del_chars))。 - 中英混排、快速开发、规则容错:优先使用
re.sub(r'[\s\W_]+', '', text)。 - 英文或排版需要保留单词间隔:使用
" ".join(text.split())压缩空格。 - 多国语言学术级预处理:使用
unicodedata.category()结合列表推导式。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















